Claude Code默认开启Auto Mode:AI自主编码时代全面来临

Auto Mode默认开启:AI编码进入自主执行新阶段
Anthropic近日确认,从8月14日起,Claude Code将在Pro与Max订阅计划的新会话中默认开启Auto Mode。这一变化标志着AI编码工具正在从"人机协作"向"AI自主执行、人类监督"的模式转变。
在Auto Mode下,Claude Code不再对每一步操作逐一弹窗征求用户同意,而是采用更智能的判断机制——只有在动作不可逆或具有破坏性时才停下来确认。这意味着日常的代码编写、文件读取、常规命令执行等操作,AI都可以自主完成,人类的角色更多转向"看着"和"把关关键节点"。
Auto Mode的设计理念源自人机交互(HCI)领域长期研究的「中断成本」问题。传统的逐步确认模式(类似Unix系统的sudo提权机制)虽然安全,但频繁的上下文切换会严重打断开发者的心流状态(Flow State)。研究表明,开发者被中断后平均需要15-23分钟才能恢复到之前的专注水平。Auto Mode本质上是将「白名单确认」模式转为「黑名单拦截」模式——默认允许安全操作,仅对高风险操作进行阻断。这种模式转变的背后,是对大量编码操作进行风险分级的结果:操作被分为只读类(文件浏览、代码搜索)、可逆类(创建文件、修改代码)和不可逆类(删除文件、执行rm命令、修改系统配置、推送至生产分支)三个层级,只有最后一类才会触发人工确认。
值得关注的是背后的安全数据支撑。Anthropic的研究显示,Auto Mode拦截危险命令的成功率高达80%,而人工审查的成功率仅为13.6%。换言之,在识别高风险操作方面,经过训练的AI判断机制反而比人工点击"确认"按钮更可靠——这一数据打破了许多人对"人工审核一定更安全"的直觉认知,其原因在于人类面对大量重复确认弹窗时容易产生"确认疲劳"(Confirmation Fatigue),最终沦为机械性点击。团队使用Auto Mode后,约多完成了200%的Pull Request处理量,效率提升显著。
Sandboxes沙箱与隔离:让AI编码智能体安全"放手去做"
AI自主执行的前提是安全隔离。Anthropic同步推出了Sandboxes功能,为自主编码Agent提供一次性隔离的执行环境。
每个沙箱运行在基于原生Hypervisor之上的MicroVM中,拥有独立的内核、文件系统与网络。这一设计与传统容器(如Docker)有本质区别:容器共享宿主操作系统内核,一旦攻击者利用内核漏洞实现"容器逃逸"(Container Escape),就能获得宿主机的完整控制权;而MicroVM在Hypervisor层面实现了硬件级隔离,每个虚拟机拥有完全独立的内核空间,逃逸难度等同于突破完整的硬件虚拟化层,安全等级提升了一个数量级。这种轻量级虚拟化方案的灵感来源于AWS Firecracker项目,启动时间通常在125毫秒以内,内存开销低至5MB,兼顾了安全性与开发者体验。
这一设计的关键意义在于:即便Agent发生"逃逸"或执行了恶意/错误操作,影响也仅限于临时VM,不会波及宿主机与真实生产环境。
Sandboxes的兼容性也相当开放,支持Claude Code、Codex、Copilot、Cursor、Gemini、Kilo等十余种Agent命令行工具,本地免费、商用亦免费。这为整个AI编码生态提供了一个通用的安全执行层。
无独有偶,AWS在Black Hat USA大会上宣布,其Continuum代码漏洞平台将直接集成Anthropic Claude Code与OpenAI的Codex。当开发者让AI助手写代码时,安全层可实时扫描输出中的不安全代码模式与风险依赖并及时告警。可以看出,随着AI自主编码能力增强,"实时安全防护"正成为各大厂商的标配——这与传统软件开发中"安全左移"(Shift Left Security)的理念一脉相承,只不过现在需要防范的不仅是人类开发者的疏忽,还包括AI Agent可能引入的供应链攻击和不安全依赖。
竞争格局升温:DeepSeek组建Harness团队对标Claude Code
AI编码智能体的竞争正在白热化。据证实,北京深度求索(DeepSeek广告)已在内部组建全新的Harness团队,主攻代码智能体产品,内部对标Anthropic的Claude Code。公司资深研究员陈德里对此进行了确认。
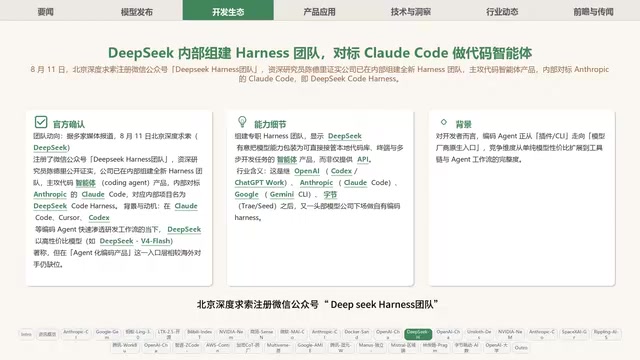
DeepSeek此举反映了AI行业一个重要趋势:竞争焦点正从基础模型能力向应用层产品快速转移。「Harness」一词在软件工程中意为「测试线束」或「工具框架」,暗示该团队的目标不仅是构建代码生成能力,而是打造完整的代码智能体工作流——涵盖代码理解、自动测试、版本管理和部署流水线的端到端能力。DeepSeek此前以开源大模型(如DeepSeek-V2、DeepSeek-Coder)在代码理解和生成方面积累了深厚的技术基础。代码智能体赛道的竞争本质上是争夺开发者工作流的入口——一旦开发者将日常编码任务委托给某个Agent,其迁移成本会随着项目上下文、自定义规则和工作记忆的积累而迅速升高。
同时,OpenAI也在加速布局,宣布ChatGPT桌面应用与Codex CLI新增从其他Agent导入内容的能力。ChatGPT桌面端支持从Claude Code、Claude Code Work、Cursor导入,Codex CLI支持从Claude Code与Cursor导入。可迁移内容涵盖指令文件、设置、技能插件、项目文件夹、MCP服务器配置以及最近30天的聊天记录——这种"降低迁移成本"的策略,本质上是在争夺用户的工作流粘性。OpenAI深知,在AI工具的竞争中,产品间的切换成本(Switching Cost)是最强大的护城河之一,而主动降低从竞品迁移的门槛,则是一种"进攻性"的用户获取策略。
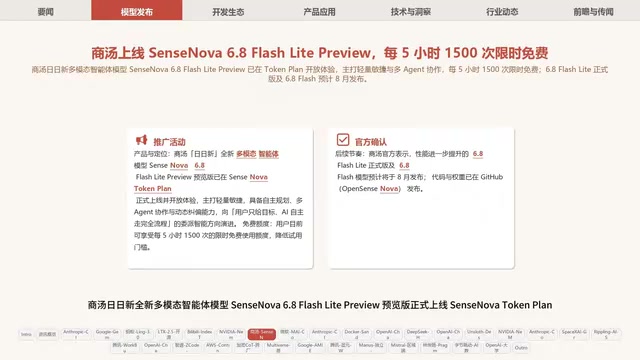
国产阵营同样动作频频。智谱旗下Zcode用户数已突破200万,并上线了低峰时段自动执行、自主交付模式与移动端远程控制等功能。商汤则推出了全新多模态智能体模型SenseNova 6.8 Flashlight Preview预览版。
持久化AI Agent崛起:从"对话"到"永续工作"
除了编码场景,企业级持久化AI Agent也成为新趋势。xAI推出企业级持久化产品GrokBot公测,每个Bot运行在独立云虚拟机中,拥有自己的浏览器、文件系统与终端,关闭笔记本后仍能继续工作,并支持多Bot在同一群聊中协作。团队版每席位每月12美元,个人版每月200美元。
持久化Agent与传统聊天机器人的根本区别在于「状态持久性」和「异步执行能力」。传统对话式AI采用无状态(Stateless)架构,每次会话结束后上下文即丢失;而持久化Agent运行在独立的计算实例中,维护着持续的工作状态(Working Memory)、长期记忆(Long-term Memory)和任务队列(Task Queue)。GrokBot每个Bot运行在独立云虚拟机中的设计,实质上是为每个Agent分配了一个完整的操作系统级运行时环境,使其能够像人类员工一样:在没有人监督的情况下持续执行任务、处理异步事件(如收到新邮件)、并在需要时主动寻求人类授权。这种架构类似于Unix系统中的daemon进程——常驻后台、持续运行、事件驱动。
OpenAI在ChatGPT中引入了"工作区Agent",用户描述工作内容后,ChatGPT可协助将其转化为团队间共享的可执行Agent,自动完成审查、潜在客户生成、报告等长期多步骤工作流,并能跨Slack、Google Drive、Microsoft SharePoint等工具提取上下文。
腾讯WorkBuddy广告则推出多端同步功能,实现PC、App、小程序三端的任务、对话记录与产物实时同步,用户甚至可以在锁屏状态下通过手机远程授权或停止电脑端Agent的任务。这些产品共同勾勒出一个方向:Agent正在从"被动响应的对话工具"进化为"持续运行的数字员工"。这一转变的深层含义是:AI的价值计量单位正从"单次对话质量"转向"持续产出量",其商业模式也相应地从按次调用转向按时间/产出订阅。
AI Token成本管理成为企业新命题
随着AI Agent大规模自主运行,Token消耗成本正在成为企业不可忽视的开支。
Token是大语言模型计费的基本单位,大约对应3-4个英文字符或1-2个中文字符。当AI Agent自主运行时,其Token消耗呈指数级增长——一个简单的代码审查任务可能涉及数万Token的上下文输入(读取代码文件、理解项目结构)和数千Token的输出(生成审查意见)。而不同模型的Token单价差异巨大:顶级模型如GPT-4o约每百万输入Token 2.5美元,Claude 3.5 Sonnet约3美元,而轻量模型如GPT-4o-mini则低至0.15美元——价格差距可达20倍。
HR平台Rippling的CEO透露,公司自身的AI Token账单一度以每月80%的速度增长,占研发人力预算比例一度冲到40%。
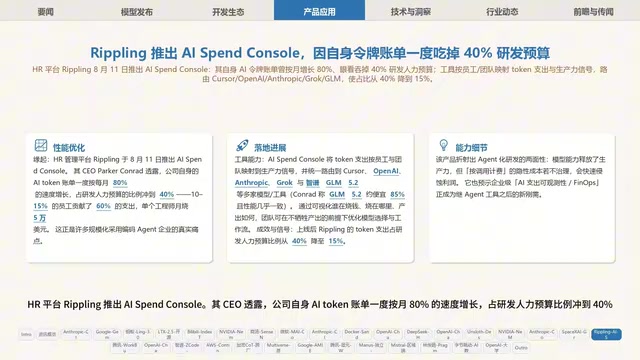
为此,Rippling推出了AI Spend Console工具,将Token支出按员工与团队映射到生产力信号,统一路由到Cursor、OpenAI、Anthropic、Grok与智谱GLM等多家模型。智能路由(Smart Routing)的核心思想是根据任务复杂度自动选择性价比最优的模型——简单的格式化任务路由到廉价轻量模型,复杂的架构设计任务才使用顶级模型,从而在保证质量的前提下大幅降低总成本。上线后,Token支出占研发人力预算的比例从40%降至15%。这一案例揭示了一个正在浮现的行业命题:当AI自主执行成为常态,成本可观测性与智能路由将和算力本身同等重要。
在底层技术上,也有降本进展。Hugging Face与Multiverse Computing公布了融合分块KL损失技术,在32K Token上下文下将峰值显存从85.2GB降至5.45GB,原本需要四节点集群才能完成的训练任务,如今可在单张GPU节点上完成。
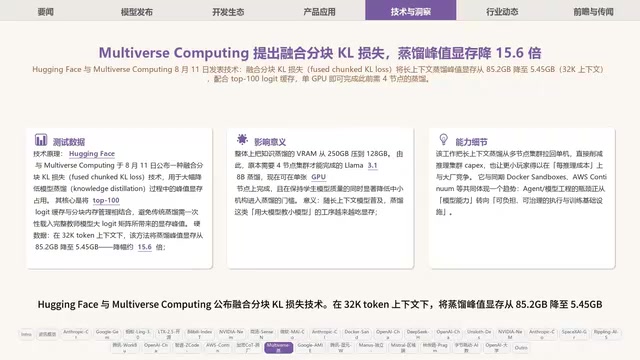
这一技术的原理值得深入理解:KL散度(Kullback-Leibler Divergence)损失是知识蒸馏训练中的核心损失函数,用于让小型"学生模型"模仿大型"教师模型"的输出分布。传统实现需要在GPU显存中同时保存完整序列的教师模型logits和学生模型logits——在32K Token序列长度、128000词表大小的情况下,这些中间张量的显存占用极为惊人。融合分块技术的核心创新在于将长序列分割为小块(Chunks),每次只计算一个块的KL损失并立即释放中间张量,同时通过算子融合(Operator Fusion)减少GPU内核启动开销和显存带宽瓶颈,最终实现93.6%的显存降幅。这本质上是经典的"时空权衡"——用少量额外计算换取大幅度的存储节省。
结语:自主化浪潮下的责任与安全天平
从Auto Mode默认开启、Sandboxes隔离执行,到DeepSeek、OpenAI、智谱等厂商密集布局代码智能体,AI编码正在快速走向"自主化"。AI自己写代码、自己执行,人类只负责监督关键节点,这一图景正从概念变为默认设置。
但正如Anthropic用80%的危险命令拦截率来为Auto Mode背书、AWS用实时安全扫描来护航一样,自主化的每一步都伴随着对安全边界的重新划定。当我们把越来越多的执行权交给AI时,如何在效率与可控之间找到平衡,将是这个新阶段最核心的议题。这也呼应了AI安全领域的一个经典框架——"人在环内"(Human-in-the-Loop)正在逐步演变为"人在环上"(Human-on-the-Loop):人类不再参与每一步决策,而是在更高的抽象层面设定边界、监控异常、并保留最终否决权。
相关推荐

LLaMA-Factory实战:零代码微调大模型全流程
本文介绍LLaMA-Factory开源微调工具,涵盖其60.1K Star项目背景、支持的模型与算法、本地与云服务器部署选择,以及CUDA环境安装步骤,帮助零基础开发者快速上手大模型微调。

曾鸣深度复盘:OpenAI为何难成终局赢家?公司制度将消亡
曾鸣在张晓骏商业访谈录中深度复盘AI终局:模型公司只是基础设施,OpenAI、Anthropic难成最终赢家;下一战役是Agent入口标准之争;公司制度将因AI重构而消亡,只有使命驱动的企业能穿越周期。

OpenHands v1.28.0:OpenCode与PI成内置Agent,密钥可对话申请
OpenHands 21天连推5个版本,v1.27.0将OpenCode与PI写入内置Agent列表,v1.28.0支持对话内申请密钥。本文梳理ACP协议接入方式、凭证复用规则、模型列表变更及升级建议。