Claude Code配置生物信息分析环境实战指南

引言:不必迷信最强Agent
在AI辅助编程领域,很多人会纠结于是否使用了最先进的Agent或最强大的大模型。但实际上,无论是OpenAI的Codex、Claude Code还是Agentic CLI,配合合适的提示词和人的引导,都能高效完成工作。本文将通过三个生物信息学实战案例,展示如何使用Claude Code配合国产大模型DeepSeek广告 v4 Flash来配置分析环境。
环境准备与配置
基本设置
使用的工具组合为:
- Agent:Claude Code v2.1.179
- 大模型:DeepSeek v4 Flash
- 运行模式:Bypass模式
Bypass模式是指绕过Claude Code默认绑定的Anthropic API,转而接入第三方大模型服务的运行方式。Claude Code本身是一个优秀的Agent框架,具备文件读写、命令执行、上下文管理等能力,但其底层调用的LLM可以被替换。通过配置API端点和密钥,用户可以将DeepSeek、OpenAI等其他模型接入Claude Code的Agent循环中,从而在保留Agent工具链能力的同时,大幅降低使用成本。这种解耦设计体现了Agent架构中"规划层"与"执行层"分离的思想。
这套组合的最大优势在于价格极低。DeepSeek v4 Flash是深度求索公司推出的轻量级高速推理模型,定位于在保持较高代码生成和推理能力的同时,提供极低的API调用成本和极快的响应速度。相比GPT-4o或Claude 3.5 Sonnet等旗舰模型,Flash系列通过模型蒸馏和架构优化,在编程任务上实现了接近旗舰模型的表现,但token价格仅为其十分之一甚至更低。这使得它特别适合需要大量Agent交互循环的场景——每次工具调用、环境检测、代码生成都会消耗token,低成本模型在这类高频调用场景中优势明显。如果使用量不大,甚至不需要包月,50块钱就能用很久。
记忆文件配置
在Claude Code中,记忆文件叫做claude.md(对应Codex中的agent.md)。需要注意的是,如果在启动Claude Code之后才修改配置文件,需要重新启动才能加载生效。
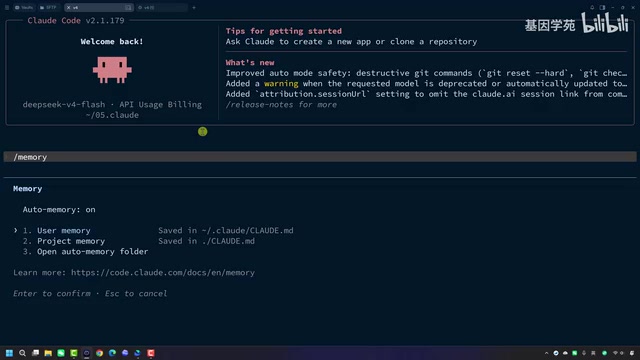
本次测试中,记忆文件的核心指令是让Agent"只生成代码",避免冗余的解释说明,提高工作效率。记忆文件本质上是一种系统级提示词持久化机制,它让用户无需在每次对话中重复说明偏好和约束条件,Agent在启动时会自动加载这些预设指令作为行为规范的一部分。
案例一:配置RNA-seq分析环境
背景知识
RNA-seq(RNA测序)是通过高通量测序技术对转录组进行全面分析的方法,广泛用于基因表达定量、差异表达分析、可变剪接检测等研究。标准分析流程包括:质量控制(FastQC检查原始数据质量、FastP进行接头去除和低质量碱基修剪、MultiQC汇总多样本QC报告)、序列比对(如HISAT2或STAR将reads比对到参考基因组)、表达定量(如featureCounts或HTSeq统计基因表达量)。配置这套环境涉及大量软件依赖和版本兼容性问题,是生物信息学入门的常见痛点。
执行过程
使用与Codex测试时完全相同的提示词,让Claude Code帮助配置RNA-seq分析环境。Agent首先会检测当前环境已安装的软件,然后询问配置方案(精简配置或完整配置)。

选择精简配置后,Agent会:
- 创建虚拟环境
- 安装FastQC、FastP、MultiQC等常用质控工具
- 安装比对和定量相关软件
效果评估
生成速度非常快,最终效果与Codex基本一致——常用的RNA-seq分析软件都能正确安装。这验证了一个重要观点:不同Agent在相同提示词下可以达到相同的效果。这也说明在当前大模型能力趋于同质化的背景下,Agent框架的选择更多是使用体验和成本的差异,而非能力的根本差距。
案例二:下载GATK参考数据
任务描述
GATK(Genome Analysis Toolkit)是Broad Institute开发的基因组变异检测工具包,是人类基因组变异分析的行业标准。其运行依赖一系列参考数据:人基因组参考序列(如GRCh38/hg38)及其BWA/Bowtie2索引文件;dbSNP数据库包含已知的单核苷酸多态性位点,用于变异注释和碱基质量重校准(BQSR);基因组金标准数据集(如HapMap、1000 Genomes、Mills indels)用于变异质量评分重校准(VQSR)。这些数据总量通常超过100GB,下载和组织管理本身就是一项耗时工作。
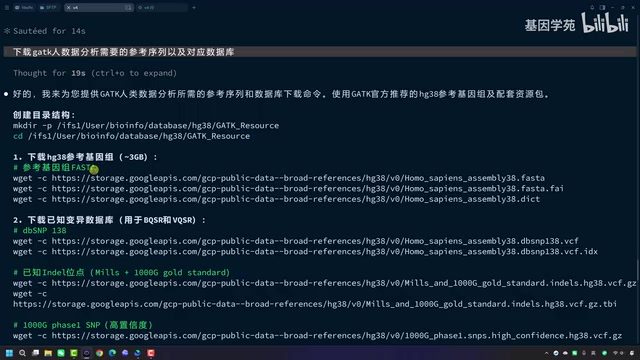
让Agent生成下载GATK对应参考数据的脚本,包括:
- 人基因组参考序列及索引
- dbSNP数据库
- 基因组金标准数据集
生成结果
Agent快速生成了完整的下载脚本,包含目录创建、文件下载、完整性校验等步骤。还贴心地提示:如果下载速度慢,可以尝试使用多线程下载工具。代码质量与Codex生成的结果完全一致。
案例三:SRA测序数据批量下载
复杂需求处理
这是一个更复杂的任务:获取某SRA项目下的全部测序数据,要求按样品名分类,同一样品的数据下载到同一目录,并按测序平台命名。
SRA(Sequence Read Archive)是NCBI维护的全球最大测序数据公共存储库,截至2024年已存储超过50PB的测序数据。从SRA下载数据面临多重挑战:传统的prefetch+fasterq-dump方式依赖NCBI服务器,国内访问速度极不稳定;数据需要从SRA格式解压为FASTQ格式,计算开销大。替代方案包括从AWS Open Data或Google Cloud的镜像直接下载已转换的FASTQ文件。
任务涉及20个细菌样本、三种测序平台,Agent需要解析NCBI网站获取元数据信息。
迭代优化
初始脚本使用了fasterq-dump直接下载,但用户希望改为从AWS下载以提高速度。
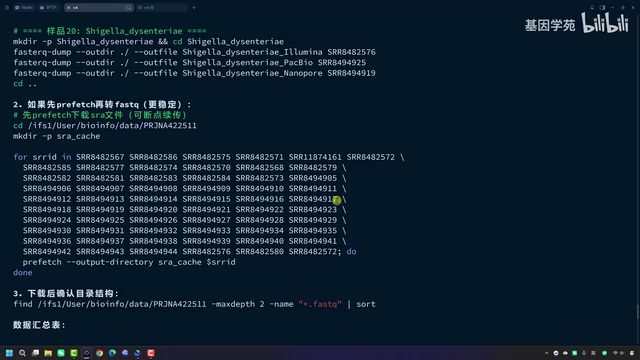
Agent展现了很强的理解和适应能力,直接改用Kingfisher工具,并提供了三种下载方案:
- Kingfisher + AWS(最推荐):内置AWS下载支持,使用最方便
- 直接AWS CLI下载:需要单独配置AWS凭证
- HTTPS协议下载:通过HTTPS直接从AWS获取,无需额外工具
Kingfisher是一个智能下载工具,能自动探测最快的数据源(ENA、AWS、GCP等),支持断点续传和并行下载,显著提升了大规模测序数据获取的效率。Agent不仅给出了多种方案,还用加粗标注了最推荐的方式,体现了良好的交互设计意识。
核心结论与建议
影响结果的三要素
通过本次测试可以总结出,AI辅助编程的效果取决于三个因素:
- 大模型能力:决定了理解和生成的上限
- Agent工具:Claude Code、Codex、Agentic CLI各有特点
- 提示词质量:人的引导在其中起到关键作用
这三者的关系可以类比为:大模型是引擎,Agent是车架,提示词是方向盘。引擎决定了动力上限,车架影响驾驶体验,但最终去向何方、能否安全到达目的地,取决于驾驶者如何操控方向盘。
实践建议
- 不必追求最贵的方案:DeepSeek v4 Flash + Claude Code的组合性价比极高
- 善用记忆文件:通过
claude.md预设行为规范,减少重复沟通 - 迭代优化:先让Agent生成基础版本,再通过对话逐步完善
- 清空上下文:当担心上下文干扰时,及时清空重新开始
最终的核心观点是:人在AI辅助编程中仍然起着决定性作用。选择合适的工具固然重要,但更重要的是掌握与AI协作的方法论——清晰的需求描述、合理的任务拆分、有效的迭代反馈,这些才是真正决定产出质量的关键。在生物信息学这样的专业领域,研究者的领域知识(知道该做什么、结果是否合理)与AI的代码生成能力形成互补,这种人机协作模式正在重新定义计算生物学的工作方式。
相关推荐

AI Agent vs ChatGPT:从被动应答到自主行动的范式跃迁
解析 AI Agent 与 ChatGPT 的本质区别:从被动应答的聊天机器人、预设轨道的 AI 工作流,到 LLM 自主决策的智能体。详解 ReAct 框架、自主纠错循环与人类在回路中的安全护栏。

用Claude订阅驱动Hermes Agent:Direct SDK插件实战指南
详解 Nous Research 的 Claude Subscription Direct SDK 插件:如何通过官方 Claude Code CLI 在 Hermes Agent 中使用 Claude 订阅,包含三种安装方式、运行原理、与 Claude Code/Buzz 的架构差异及实测速度对比。
ChatGPT砍价11万美元?房产经纪人为何仍不可替代
Reddit房产经纪人论坛掀起激辩:有买家声称用ChatGPT砍价11万美元,只花1200美元律师费。经纪人回应称核心价值在于情绪支持与风险兜底。本文分析AI在房产交易中的能力边界,探讨大模型能否真正替代专业人士。