Claude Code让普通人也能造App:个人开发的新门槛

一位只懂基础编程的YouTube博主用Claude Code做出了个人转录工具,揭示AI编程赋能普通人的真实临界点。
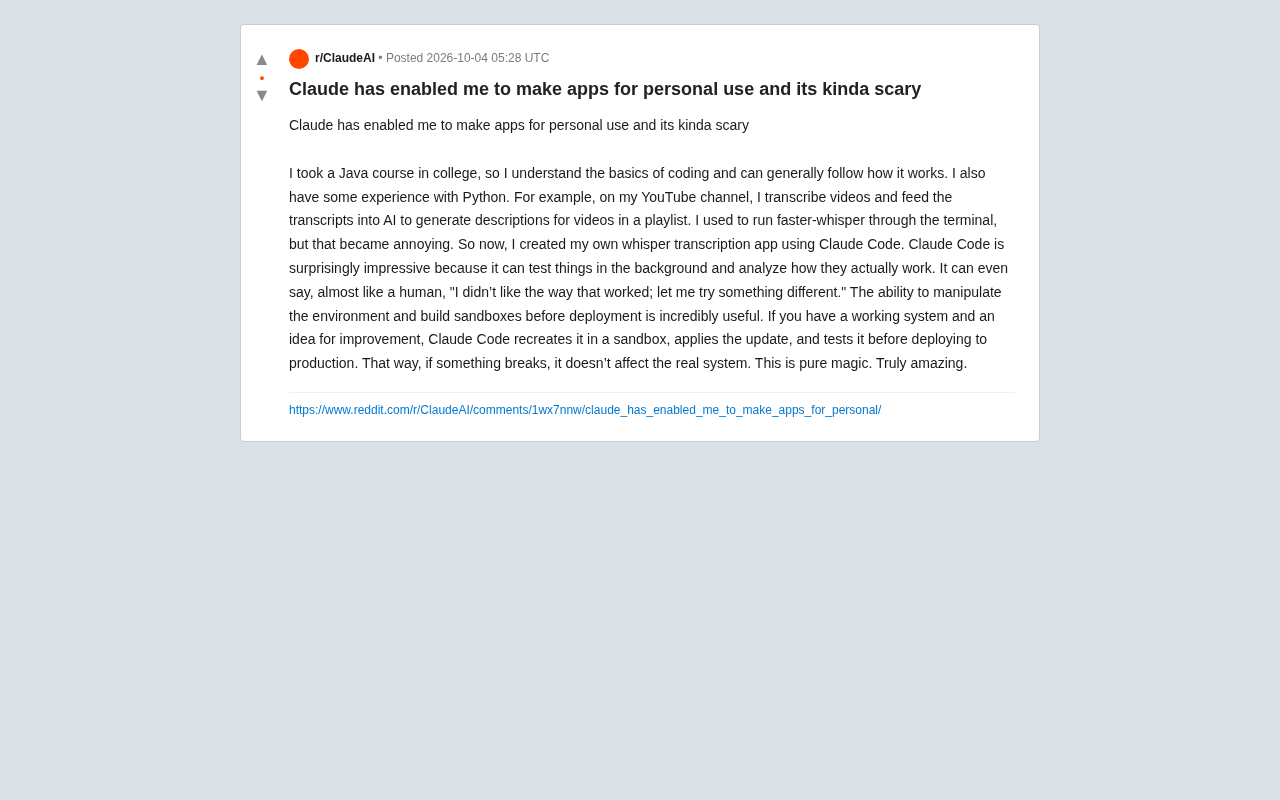
一位仅有大学Java课程背景的Reddit用户分享了用Claude Code为自己制作Whisper转录应用的经历。令他印象最深的不是代码生成本身,而是Claude Code能够自主在后台运行测试、分析结果并自我修正,以及内置的沙盒机制可在不影响生产系统的前提下验证改动。文章认为这一体验折射出三个信号:个人软件正在复兴、理解代码的能力正取代亲手编码的能力、专业开发者的价值将向架构与复杂判断迁移。尽管属于个人主观体验且任务场景相对简单,但它标志着AI编程工具在"赋能非专业人士解决真实问题"上已跨过一个可感知的临界点。
当一个会写代码的半吊子遇上Claude Code
一位Reddit用户分享了他使用Claude Code的真实体验,标题颇具戏剧性——"Claude让我能为自己做App了,这有点吓人"。这不是一位专业工程师的炫技,而是一个仅在大学上过Java课、懂一些Python基础的普通人的记录。他的描述朴实却有代表性:AI编程工具正把软件开发的门槛推到前所未有的低点。
这位用户经营着一个YouTube频道,日常需要把视频转录成文字,再喂给AI生成播放列表的视频描述。过去他通过终端运行 faster-whisper 来完成转录,流程繁琐。现在,他直接用 Claude Code 为自己做了一个 Whisper 转录应用,彻底解决了这个痛点。
faster-whisper 是 OpenAI Whisper 语音识别模型的高效推理实现,基于 CTranslate2 引擎优化,运行速度比原版快 4 倍以上,显存占用更低。Whisper 本身是 OpenAI 于 2022 年开源的多语言语音转文字模型,支持近百种语言,准确率在业界属于一流水平。然而,原生使用方式需要通过命令行调用,涉及模型下载、环境配置、参数设置等步骤,对非技术用户门槛较高。这正是为什么给自己包一个图形界面或简化流程的应用,会成为有实际价值的个人工具需求。
Claude Code 真正令人意外的地方
在这位用户的叙述中,最打动他的并非"能写代码"这一点——这早已是大模型的标配能力。真正让他感到"有点吓人"的,是 Claude Code 的工程化行为:它能在后台测试代码、分析运行结果,甚至会像人一样说出"我不喜欢刚才那个效果,让我换个方式试试"。
这种从"生成代码"到"验证代码"的跨越,是智能体(Agent)形态与传统代码补全工具的本质区别。它不只是输出一段看似合理的文本,而是把结果放回真实环境里跑一遍,根据反馈自我修正。对于不具备深厚调试能力的普通用户来说,这一步极其关键——因为他们往往无法判断AI给出的代码到底对不对。
沙盒机制:让试错不再有代价
用户特别称赞的一个能力是沙盒(sandbox)与部署流程的处理。按他的描述,当你已有一套能运行的系统,又想做改进时,Claude Code 会:
- 在沙盒中重建现有系统
- 应用新的更新
- 在部署到生产环境前完成测试
这意味着即使改动出了问题,也不会波及真正在用的系统。他用了"纯粹的魔法"来形容这套流程。从软件工程角度看,这其实是把隔离环境、测试、灰度部署这些专业实践,自动化地封装进了一个对话式工具里。过去这些需要开发者手动搭建的基础设施,现在变成了AI的默认行为。
Claude Code 是 Anthropic 推出的面向开发者的命令行 AI 编程助手,于 2025 年正式发布。与 GitHub Copilot 等以代码补全为核心的工具不同,Claude Code 以智能体(Agentic)模式运行:它可以主动读写文件、执行终端命令、调用外部工具,并根据执行结果调整后续行动,形成"规划—执行—观察—修正"的闭环。这一设计使其更接近一个能独立完成子任务的协作者,而非单纯的文字预测工具。正是这种对真实环境的直接操作能力,让它得以完成测试、调试等传统上需要开发者手动介入的工程环节。
沙盒(sandbox)在软件工程中指一个与生产系统隔离的受控执行环境,其核心价值在于"变更不影响真实用户"。专业开发团队通常维护开发环境、测试环境、预发布环境和生产环境四套独立系统,任何代码改动需逐级验证后才能上线。灰度部署(canary deployment)则是一种更精细的策略,先将新版本推送给一小部分用户,确认无异常再全量发布。这些实践在传统开发流程中需要花费大量人力搭建和维护基础设施。Claude Code 将这一流程以对话驱动的方式呈现,让没有运维经验的普通用户也能天然享有"先测试再部署"的安全边界,这正是文中用户感到"魔法"的工程本质。
"有点吓人"背后的真实信号
标题里的"scary"值得玩味。它既是惊叹,也是一种隐约的不安。当一个只懂基础编程的人,能在短时间内做出满足自身需求的工具,这释放出几个信号:
个人软件(personal software)正在复兴。 过去,为解决一个只有自己需要的小痛点去写一个App,成本高到不值得。现在边际成本被压到极低,"自己给自己做工具"成为可行选项。这类不打算商业化、只服务个人工作流的软件,可能是AI编程最先规模化落地的场景。
理解力比编码力更重要。 这位用户强调自己"大致能看懂代码如何运作"。这恰恰是关键——AI负责生成和测试,而人负责判断方向、描述需求、识别明显的错误。能看懂但不必亲手写,正在成为新的能力画像。
专业开发者的护城河在重构。 当沙盒测试、自我修正这些工程实践被工具自动承担,开发者的价值将更多转向架构设计、复杂系统权衡和那些AI尚难覆盖的判断。
冷静看待:这是个人视角的样本
需要指出,这是一位个人用户基于自身场景的主观体验,而非系统性评测。他做的转录应用属于相对标准、边界清晰的任务,AI在这类场景下表现出色并不意外。一旦涉及大型代码库、复杂依赖、模糊需求或高可靠性要求,情况会复杂得多,自我修正也可能走偏。
但即便带着这层保留,这个故事的价值依然成立:它展示了AI编程工具在"赋能非专业人士解决真实问题"这件事上,已经跨过了一个可感知的临界点。所谓"吓人",不是技术威胁,而是一种对能力边界被重新定义的直觉反应。对更多普通用户来说,"我也能做个App"正从一句玩笑,变成一个真实选项。
相关推荐

iPhone Duo上手体验:2000美元的小屏折叠,值不值?
YouTube博主Allison分享iPhone Duo上手体验:双屏多任务效率翻倍,视频观看体验出色,磨砂质感好评,但机身偏厚、单屏操作偏小,2000美元定价进入MacBook区间,属于奢侈品定位。

Sentry广告笑疯开发者:On-call也能变有趣?
Sentry广告短片以开发者On-call焦虑为切入点,用幽默对话展示其将错误、日志、链路、指标、录屏和发布记录集中一处的可观测性能力,引发开发者社区共鸣。
LLM应用越改越糟?三步构建有效评估体系
LLM应用迭代时如何判断变好还是变坏?本文基于Reddit开发者讨论,详解构建测试集、自动化回归评估、LLM-as-judge评分与结构化追踪智能体行为,建立从生产反馈到评估追踪的持续闭环。