Claude Code重试看门狗:无人值守运行不再中断

用 CLAUDE_CODE_RETRY_WATCHDOG=1 让 Claude Code 在限流时持续等待而非放弃,把无人值守任务变成真正的无人值守。
文章介绍了 Claude Code 中一个不为人熟知的环境变量 CLAUDE_CODE_RETRY_WATCHDOG。默认情况下,Claude Code 遇到 429 或 529 限流会重试约 10 次后终止会话,这对有人值守的交互式使用是合理的,却会让夜间批处理任务在关键时刻前功尽弃。开启该变量后,Claude Code 切换到"等待消耗"模式,失败条件从"重试 N 次"变为"等到能通为止",因为限流是暂时的而代码逻辑本身没问题。文章建议把这一特性用在 CI/CD、大规模代码迁移、配额高峰期批处理等可容忍等待的场景,而不适用于交互式调试、配额耗尽或对完成时间有硬性要求的流水线。同时强调要用 timeout 等外部机制为无限等待设置保险丝,并指出实测表明成功率提升的代价是总时长增加,而等待期间并不产生额外 token 费用。
无人值守任务为何总在关键时刻掉线
用 Claude Code 跑批处理任务的人大多遇到过这种场景:夜里启动一个大规模代码库重构,早上起来发现任务在凌晨两点就停了——不是代码逻辑出错,而是 API 返回了 429(请求限流)或 529(服务过载),内置重试在 10 次之后优雅地放弃了。
对于交互式使用,这个设计没问题:用户在场,看到报错可以手动决定是否重试。但无人值守场景下,一次限流就可能让数小时的计算前功尽弃。
Claude Code 提供了一个不太为人熟知的环境变量来解决这个问题:CLAUDE_CODE_RETRY_WATCHDOG=1。
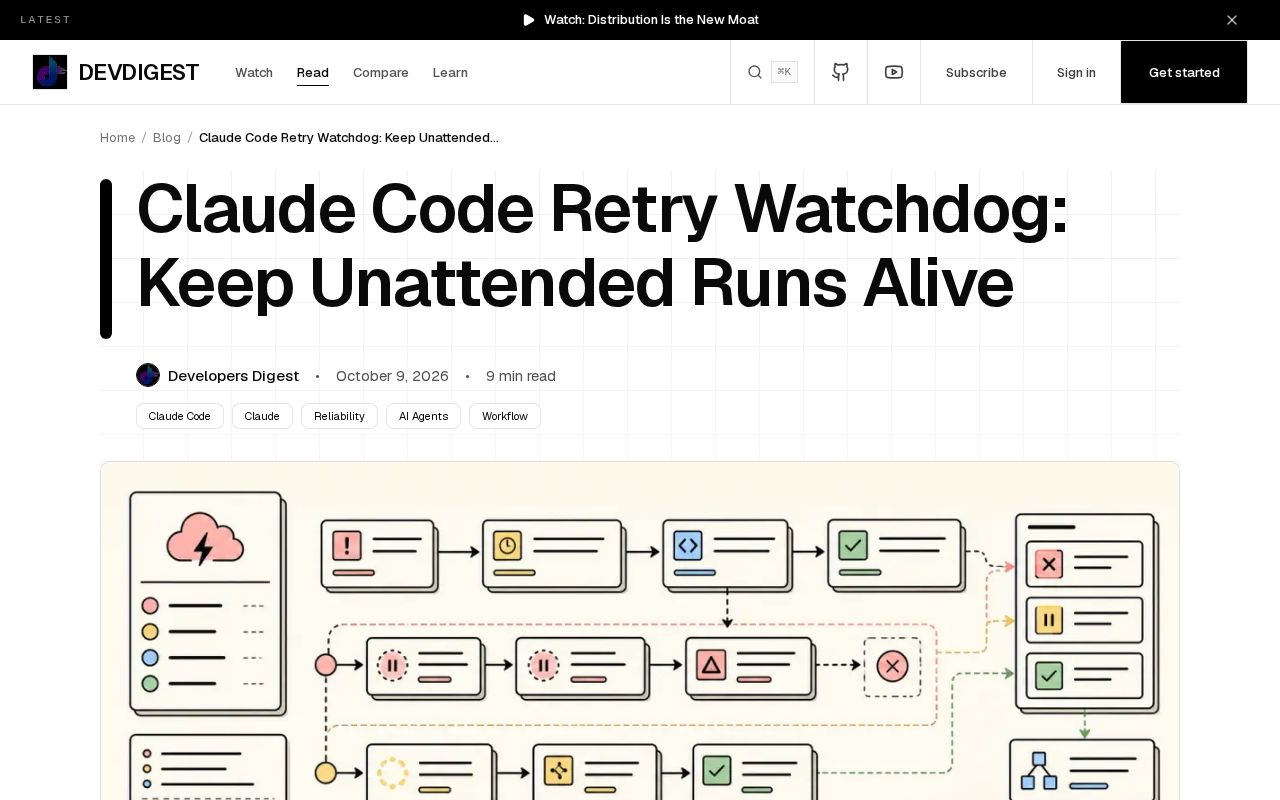
429 和 529 是 HTTP 状态码中与限流和过载相关的两个。429 Too Many Requests 表示客户端在给定时间内发送了过多请求,服务端要求其降速,通常会在响应头中携带 Retry-After 字段告知需要等待多久。529 Site is Overloaded 并非 HTTP 标准状态码,而是 Anthropic API 自有的扩展状态码,用来表示服务端因瞬时流量过大而暂时无法处理请求——它与 429 的区别在于,429 通常归因于客户端请求频率,529 则更多反映服务端整体的负载压力,与客户端行为无关。两者在实践中的共同点是都属于暂时性故障:只要等待足够长的时间,请求大概率能成功。这正是看门狗机制得以生效的前提——如果错误是永久性的(比如权限不足返回 403、配额耗尽返回某个特定的 billing 错误),那么无论等待多久都不会成功。理解这两类状态码的暂时性本质,是判断该不该开启 CLAUDE_CODE_RETRY_WATCHDOG 的关键。
CLAUDE_CODE_RETRY_WATCHDOG 到底改变了什么
默认行为下,Claude Code 在遇到 429 或 529 时会进行有限次数的重试,通常上限为 10 次,然后抛出错误并终止会话。这个策略对交互式使用是合理的:用户在场,看到报错可以手动决定是否重试。
一旦开启 CLAUDE_CODE_RETRY_WATCHDOG=1,Claude Code 会切换到"等待消耗"模式。它不再计数后放弃,而是持续等待限流窗口过去,直到 API 重新接受请求。换句话说,失败条件从"重试 N 次"变成了"等到能通为止"。
这对批处理任务的意义很直接:限流是暂时的,代码逻辑没问题,任务没必要因为外部服务的短期波动而终止。
这里涉及两种截然不同的重试哲学。第一种是有界重试(bounded retry):设定一个最大重试次数,每次尝试之间做指数退避(exponential backoff),典型如第 1 次等 1 秒、第 2 次等 2 秒、第 4 秒、第 8 秒……直到达到上限就放弃。这种策略适合交互式场景,因为它保证了请求最终会返回一个确定的结果——要么成功,要么失败,不会无限期挂起。第二种是无限等待(unbounded wait)或"等待消耗"模式:不设次数上限,只要错误仍然是暂时性的,就一直轮询直到成功为止。看门狗(watchdog)这个词借用自嵌入式系统——原本指一个定时器,需要被定期"喂狗"重置,否则就触发复位,这里反其道而行之,指的是持续守护、监控状态直到条件满足。两者的核心权衡是确定性与成功率的取舍:有界重试给你一个确定的失败点,无限等待则用不确定性换取更高的最终成功率。
适合用它和不该用它的场景
适合开启的场景:
- CI/CD 流水线中触发 Claude Code 做代码审查或自动修复
- 本地跑大规模代码迁移、测试生成等长耗时任务
- 在 API 配额紧张的时间段(比如团队共用 key 的高峰期)执行非紧急批处理
不适合的场景:
- 交互式调试——你不需要为了一次请求等上十几分钟
- 已经明确知道 API key 配额耗尽——看门狗等的是临时限流,不是配额重置
- 对任务完成时间有硬性要求的流水线——等待可能让整个 pipeline 超时
关键区分在于:看门狗解决的是"暂时性限流",不是"持续性拒绝"。如果 API 返回的是权限错误或配额耗尽,等待再久也没有意义。
如何给看门狗加上保险丝
让进程无限等待在生产环境中是危险的——如果 API 持续不可用,你的任务会永远挂在那里,占用资源却什么也不做。原文给出了一个实用的做法:在开启看门狗的同时,用外部超时机制设一个上限。
timeout 3600 env CLAUDE_CODE_RETRY_WATCHDOG=1 claude --your-task
这样即使看门狗决定"永远等下去",外部也会在 1 小时后强制结束。
另一种方案是在脚本层面监控进程状态,超过预期时间未产出任何输出就主动 kill 并告警。看门狗负责处理正常的限流等待,外部机制负责处理异常情况,两者配合才算完整。
timeout 是 GNU coreutils 提供的命令行工具,用法为 timeout [时长] 命令,超过指定时长后向子进程发送 SIGTERM 信号终止它,若进程不响应则追加 SIGKILL。示例中的 3600 表示 3600 秒,也可以写成 1h。需要注意几个细节:第一,timeout 包裹 env 赋值是其标准用法,env KEY=VALUE command 能把环境变量注入到子进程中,因此 timeout 3600 env CLAUDE_CODE_RETRY_WATCHDOG=1 claude ... 这条命令的结构是先启动 timeout,再由 timeout 启动 env,由 env 设置变量后执行 claude——这样环境变量只对这一条命令生效,不会污染当前 shell。第二,在 macOS 上默认的 timeout 可能不存在,需要通过 Homebrew 安装 coreutils 后使用 gtimeout。第三,被杀死的进程会返回非零退出码(通常是 124),脚本应当检查这个退出码并触发告警,否则超时会被静默忽略,任务看似"完成"实则被截断。
实测数据说明了什么
原文提到作者做了测量,核心结论是:开启看门狗后,原本因限流而失败的任务能够完整跑完,代价是任务总时长会增加——增加的量取决于限流窗口的长度。
这个权衡的本质是:用时间换成功率。对于夜间批处理这类"跑完就行、不赶时间"的场景,这个交换非常划算。对于需要快速反馈的场景,则需要谨慎评估等待时间是否在可接受范围内。
一个容易被忽略的细节是,看门狗等待期间 token 消耗是暂停的——它只是在轮询 API 状态,不会产生额外费用。失败重试反而可能因为重复发送上下文而多消耗 token。
小结
CLAUDE_CODE_RETRY_WATCHDOG=1 是一个针对特定场景的实用开关:它把 Claude Code 从"试几次就放弃"变成"等到能行为止"。合理使用它的前提是理解自己的任务属于哪一类——是能容忍等待的批处理,还是需要即时反馈的交互。配上外部超时兜底,这个特性可以让无人值守任务真正实现无人值守。
相关推荐

Kimi K3.1实测:开源模型逼近Opus,视频生成意外抢镜
Kimi K3.1在直播实测中完成运动图形、3D渲染、小游戏与视频生成等复合任务。本文分析其2.8万亿参数MoE架构的真实表现、与Opus/GPT的体感差距,以及被官方忽略的视频生成能力,并讨论多模型并用时代的工作流变化。

Sam Altman:人生重大建议,为何仍需来自人类?
OpenAI CEO Sam Altman 谈 AI 建议的边界:AI 能劝阻冲动邮件,但人生重大建议仍应来自人类。他期待 AI 成为会反驳的资深同事,而非谄媚工具。

“黑色十月”:AI挖出史上3%严重漏洞?
Reddit 热帖称过去一个月发现了史上 3% 的严重软件漏洞,被称为「黑色十月」。本文拆解这一说法的统计口径问题,分析 AI 辅助代码审计如何加速漏洞发现,以及开发者和企业该如何应对补丁窗口缩短的挑战。