Claude 多个模型出现高错误率,官方两小时内完成修复

Claude 多模型同时故障约 1 小时 38 分钟,暴露共享故障域下冗余策略的局限。
本文复盘了 Claude 多个模型在 UTC 00:50 至 02:10 期间出现请求错误率升高的事件。受影响模型包括 Claude Mythos 5.1、Fable 5.1 和 Opus 5,官方从首次通报到标记「已解决」历时约 1 小时 38 分钟。恢复过程呈现明显差异:Fable 和 Mythos 系列先于 Opus 5 恢复,暗示不同模型对共享基础设施的依赖程度不同。文章指出,这次故障很可能出在模型共享的基础设施或请求路由层,而非单一模型本身。对开发者而言,核心启示是:多模型冗余不等于高可用,共享故障域会让降级策略失效,跨供应商备份才是真正的冗余。官方给出的精确影响时间窗口也可用于回查日志和补偿失败请求。
故障时间线:从发现到解决的 80 分钟
据故障状态页面记录,Claude 多个模型在短时间内集中出现请求错误率上升。首次通报于 UTC 00:57 发出,状态为「调查中」,受影响模型包括 Claude Mythos 5.1、Claude Fable 5.1 和 Claude Opus 5。
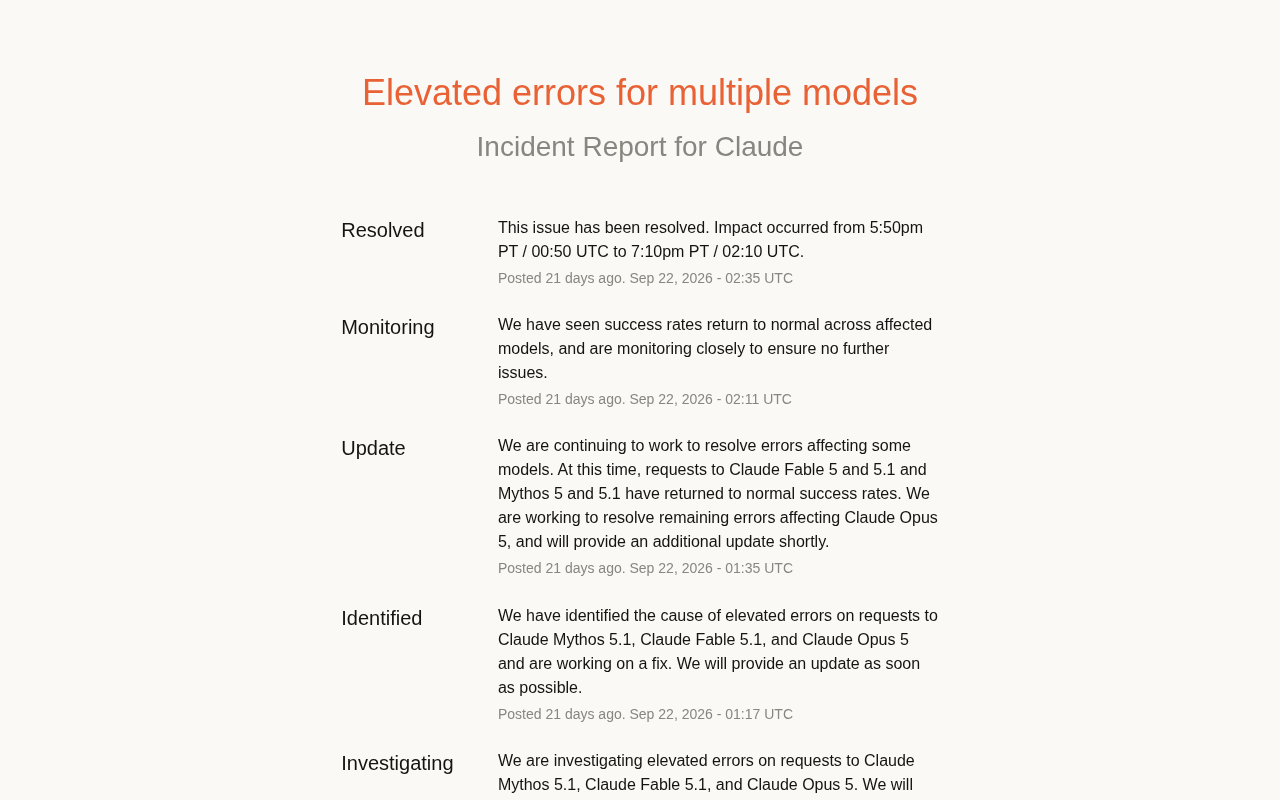
20 分钟后,团队将状态更新为「已定位」,确认找到了导致错误率升高的根因,并表示正在修复。到 UTC 01:35,部分模型率先恢复——Claude Fable 5 及 5.1、Mythos 5 及 5.1 的成功率已回到正常水平,但 Claude Opus 5 仍在处理中。UTC 02:11 官方宣布所有受影响模型的成功率恢复正常,进入监控阶段。UTC 02:35 状态最终标记为「已解决」。
从首次报障到完全恢复,整个过程约 1 小时 38 分钟。
错误率(Error Rate) 在 API 服务语境下,通常指单位时间内返回错误响应的请求占比。与完全宕机不同,错误率升高意味着服务仍在运行,只是部分请求失败,例如返回 HTTP 5xx、限流响应或超时。这种「灰色故障」(Gray Failure)比彻底宕机更难察觉,因为监控面板不会全红,但用户体验已在悄然下降。
服务商发布状态页通报时,往往会区分「延迟升高」「错误率升高」「完全不可用」等不同等级。对开发者而言,错误率指标是触发自身告警阈值的关键输入——当上游错误率超过预设百分比时,就应自动切换到备用方案或启用重试退避。理解这一指标,有助于更精准地解读官方的故障通报措辞。
受影响模型与恢复节奏的差异
这次故障波及的模型数量值得注意。Claude Mythos 5.1、Claude Fable 5.1 和 Claude Opus 5 同时出现错误率升高,说明问题可能出在这几个模型共享的基础设施或请求路由层,而非单一模型本身的推理逻辑。
恢复过程也呈现出明显的先后顺序。Fable 和 Mythos 系列在 UTC 01:35 前就恢复了正常成功率,而 Opus 5 作为更重的旗舰模型,修复耗时更长。这种恢复节奏的差异,通常指向两个可能:要么 Opus 5 依赖了额外的服务组件,要么其流量特征使得错误更容易累积。官方并未披露具体的技术细节。
对使用多模型策略的开发者来说,这类事件提供了一个实际的提醒:当多个模型同时不可用时,简单的模型降级(fallback)策略可能失效。如果备用模型和主模型共享了同一个故障域,切换并不会带来可用性提升。
故障域(Failure Domain) 是评估冗余策略时的核心概念。它指的是一个系统或组件集合中,一旦发生故障就会同时失效的范围。举例来说,两个模型如果部署在同一套负载均衡、鉴权服务或调度队列之上,那么这些共享组件就构成了同一故障域——它们会一起宕机。
在设计高可用架构时,关键原则是避免把主备资源放在同一故障域内。开发者常用的「跨可用区」「跨地域」部署,本质上就是在扩大故障域之间的隔离度。对于依赖多家 AI API 的产品,判断主模型与备用模型是否真正互备,要看它们的请求链路上是否存在任何共享环节:同一云厂商、同一 DNS、同一 CDN,乃至同一认证网关,都可能成为共因故障(Common Cause Failure)的入口。这次 Claude 多模型同时故障,正是共因失效在 AI 服务层的体现。
状态页通报机制的信息价值
这份通报的价值不仅在于记录了一次故障,更在于它展示了 AI 服务商面对线上问题时的沟通节奏:调查→定位→部分恢复→全部恢复→监控→解决,六个阶段在不到两小时内依次推进。
每次更新都给出了明确的受影响模型清单和当前的恢复状态,没有使用模糊措辞。对于依赖 API 构建产品的团队来说,这种颗粒度的通报可以直接用于判断是否需要触发自身的告警或降级逻辑。
官方提到,实际影响时间段为太平洋时间下午 5:50 至 7:10(对应 UTC 00:50 至 02:10),比首次公开通报早了约 7 分钟。这说明内部监控系统在用户感知到问题之前就已经触发了告警,但从告警到对外通报之间仍存在一定延迟。
状态页(Status Page) 是 SaaS 和云服务商对外披露服务健康度的标准工具,常见于 Statuspage、Instatus 等平台。它的核心价值在于提供单一可信信息源,避免用户通过社交媒体或客服渠道零散获知故障。
一份高质量的状态页通报,通常包含时间戳、受影响组件、当前状态等级以及预计恢复时间。状态等级一般从「运营正常」到「调查中」「已定位」「修复中」「监控中」「已解决」逐级演进。开发者可以将状态页接入自动化系统,例如通过 RSS 或 API 轮询,在状态变更时自动触发内部告警或降级逻辑。这次事件中官方给出的六个阶段,正是状态页标准生命周期的典型示例。
对开发者的几点实际参考
多模型冗余不等于高可用。 当故障发生在共享层面时,同一供应商旗下的多个模型可能同时受影响。跨供应商的备份方案才能提供真正的冗余。
关注状态页的更新频率。 从「调查中」到「已定位」只用了 20 分钟,这种响应速度可以作为评估服务商运维能力的参考指标。
利用官方给出的影响时间窗口。 通报中明确了 UTC 00:50 至 02:10 为实际影响区间,开发者可以用这个时间窗口回查自己的错误日志,确认是否有未捕获的失败请求需要补偿处理。
这次故障的修复速度在可接受范围内,但它也暴露了一个事实:即使是头部 AI 服务商,多模型同时故障的风险依然存在,而现有的冗余策略未必能覆盖这种情况。
跨供应商冗余(Multi-Vendor Redundancy) 指的是在不同 AI 服务商之间建立备份路径,而非依赖同一供应商的多个模型。其核心假设是:不同供应商的基础设施、运维团队和故障模式彼此独立,因此同时失效的概率较低。
实现跨供应商冗余需要解决几个工程问题:一是抽象出统一的模型调用接口,屏蔽各家 API 的差异;二是建立一致的提示词与输出格式适配层,确保切换后行为可预期;三是设计自动故障转移(Failover)逻辑,基于健康检查或错误率触发切换。代价则是成本上升、维护复杂度增加,以及不同模型输出质量不一致带来的体验波动。是否值得,取决于业务对可用性的实际要求。
相关推荐

3分钟看懂DeepSeek:从量化私募到开源AI领跑者的崛起之路
3分钟看懂DeepSeek发展史:从幻方量化的算力积累,到V2的MLA推理降本、V3的557.6万美元训练账单、R1开源引爆全球,再到V4与70亿美元A轮融资,梳理深度求索的关键节点与技术路线。

本地文学创作模型PK:Qwen3.8 27B微调版胜出,DeepSeek v4.1表现平淡
B站UP主横向测评七款本地文学创作模型:海明威、HumanLike Chat基于Qwen3.8 27B微调表现最佳,DeepSeek v4.1叙事平淡,东方朔角色混乱垫底。附三道测试题评分与使用建议。

梁文锋的三次豪赌:DeepSeek为何将82%毛利开源?
DeepSeek为何把82%毛利的推理框架DeepInfer开源,又启动千亿融资?从技术路线、国产芯片到组织纯粹性,解析梁文锋的三次豪赌与开源战略背后的商业与理想逻辑。