Claude Fable 5.1 服务降级事件:故障已全面恢复

Claude Fable 5.1 发生约14分钟服务降级,波及多条产品线后已恢复。
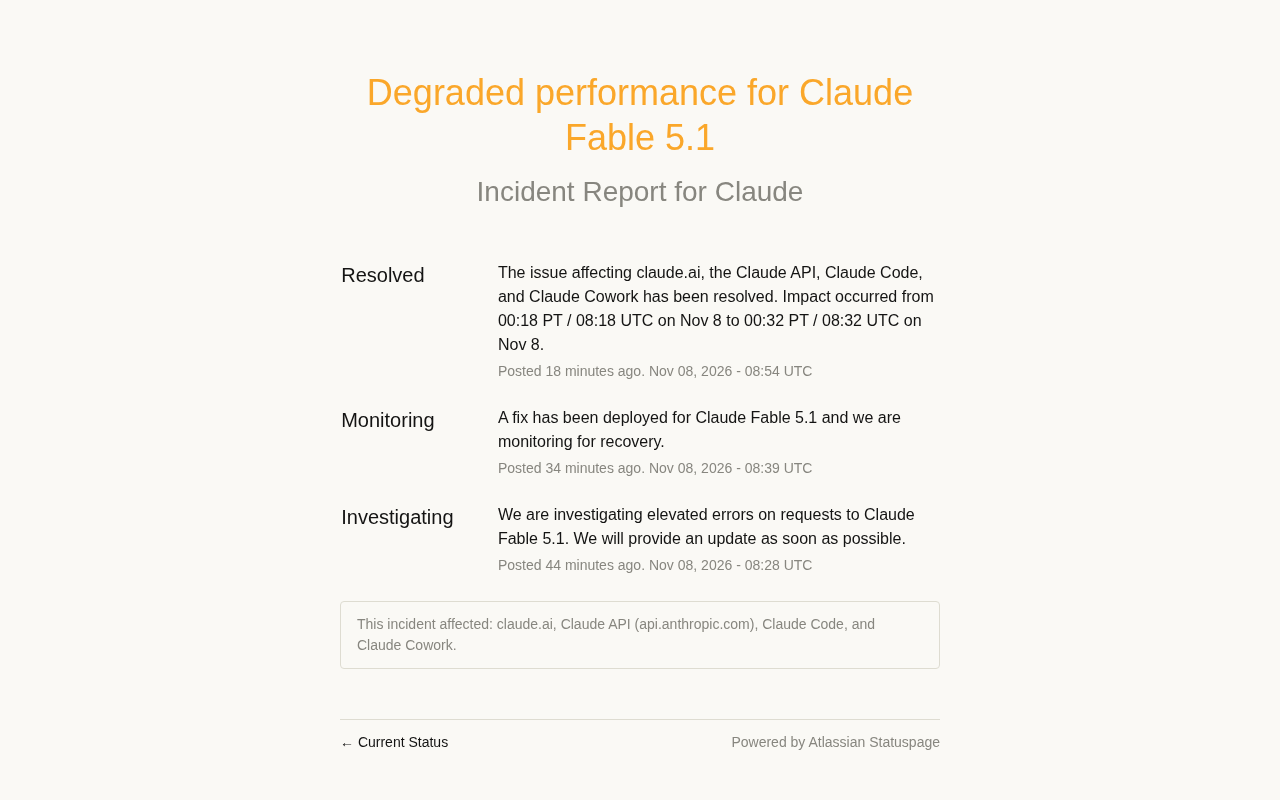
Claude Fable 5.1 近日出现服务降级,影响 claude.ai、Claude API、Claude Code 与 Claude Cowork 等多个产品入口。故障从太平洋时间 00:18 开始、00:32 结束,持续约 14 分钟。官方在 UTC 08:28 首次发布“Investigating”状态,确认调查请求错误率升高问题;08:39 进入“Monitoring”,表示修复已部署并观察恢复情况;08:54 正式标记“Resolved”。由于多产品线同时受波及,问题很可能出在模型服务层或共享推理基础设施,而非单一前端入口。对开发者而言,此类短时故障的影响取决于重试与容错设计,建议配置指数退避重试、订阅状态页通知,并为关键业务准备多模型路由等降级预案。
事件概述
近日,Claude Fable 5.1 出现服务降级,影响范围覆盖 claude.ai、Claude API、Claude Code 以及 Claude Cowork 等多个产品入口。根据官方状态页更新,该问题在经历“调查中”、“监控中”两个阶段后,最终被标记为“已解决”。
从时间线看,故障从太平洋时间 00:18(UTC 08:18)开始,到 00:32(UTC 08:32)结束,持续约 14 分钟。官方在 UTC 08:28 首次发布“Investigating”状态,确认正在调查针对 Claude Fable 5.1 请求的错误率升高问题;UTC 08:39 进入“Monitoring”阶段,表示修复已部署并观察恢复情况;UTC 08:54 正式标记“Resolved”。
影响范围与表现
本次降级并非局限于单一接口。官方明确列出受影响的产品包括 claude.ai(网页端)、Claude API(开发者调用)、Claude Code(编程辅助工具)以及 Claude Cowork(协作场景)。这意味着无论是普通用户、开发者还是企业协作团队,在故障窗口内都可能遇到请求失败或响应异常。
官方将问题描述为“elevated errors on requests”,即请求错误率升高。虽然状态页未披露具体错误类型和受影响请求比例,但从多产品线同时受波及来看,问题很可能出在模型服务层或共享的推理基础设施上,而非某个前端入口的独立故障。
状态页分级机制:主流云服务与 API 平台的状态页通常采用一套固定的状态语义,Anthropic 也不例外。常见分级从低到高依次为 “Investigating”(已确认异常、正在定位根因)、“Identified”(已找到原因、正在制定修复方案)、“Monitoring”(修复已部署、正在观察指标是否稳定)与 “Resolved”(确认恢复、事件闭环)。本次事件跳过了 “Identified” 阶段,直接从 Investigating 进入 Monitoring,说明根因定位与修复部署的间隔很短。理解这套分级有助于判断事件所处阶段:处于 Monitoring 并不等于已恢复,而是“修复已上线但尚未确认稳定”,此时仍可能出现残余错误。
响应过程与恢复
官方的处理节奏相对紧凑:发现异常后先公开“调查中”状态,随后部署修复并进入监控,最终确认恢复。你可能没注意到,修复部署与正式恢复之间间隔约 15 分钟,说明团队在确认修复效果时采取了保守的观察策略。
对于依赖 Claude API 和 Claude Code 的开发者而言,这类短时故障的实际影响取决于重试机制和容错设计。建议在集成时配置指数退避重试,并关注官方状态页的订阅通知,以便在类似事件中快速感知。
指数退避重试(Exponential Backoff):这是应对短时服务不可用的标准客户端策略。其基本做法是:请求失败后不立即重试,而是等待一个初始延迟(如 500 毫秒)再试;若再次失败,则将等待时间按倍数(通常为 2)递增,并叠加随机抖动(jitter)以避免大量客户端在同一时刻集中重试造成“重试风暴”。同时应设置最大重试次数与总超时上限,并对 4xx 类不可重试错误直接放弃。对于本次这类十余分钟的降级,合理的退避参数通常能让请求在故障窗口结束后自动恢复,而无需人工干预。
对用户的建议
短期看,本次事件已闭环,用户无需额外操作。长期看,任何依赖单一模型服务的产品都应具备降级预案:关键业务可考虑多模型路由,非关键任务则可容忍短时不可用。官方状态页是获取此类信息的第一手渠道,建议开发者将其纳入监控体系。
整体而言,这是一次影响面较广但持续时间较短的可用性事件,官方响应流程完整,从调查到解决的信息披露较为透明。
多模型路由与降级预案:多模型路由指在应用层抽象出统一的模型调用接口,背后接入多家或同家不同规格的模型,并根据可用性、延迟、成本或任务类型动态选择后端。其价值在本次事件中体现得很直接:当主模型请求错误率升高时,路由层可自动将流量切换至备用模型或降级到能力较弱但更稳定的版本,保证关键链路不中断。实践中需要注意几点:不同模型的提示词格式、上下文长度与输出风格存在差异,切换时需做输出后处理与质量校验;同时应设定明确的切换阈值与回切条件,避免在主服务恢复后仍长期停留在备用路径上。
相关推荐
 科技前沿
Memorias:用AI传记作家把你的故事变成书
Memorias 是一款 AI 传记作家工具,通过对话式访谈将你的口述故事整理成回忆录,自动映射人物、地点与年份,支持照片与 EPUB/PDF/DOCX 导出,按次付费。
 科技前沿
mamitsu:让社交视频自动转成JSON的API与MCP
mamitsu是一款在Product Hunt上发布的API和MCP服务器,能将社交视频中的画面、音频和配文解析为JSON结构化数据,适用于食谱提取、产品信息抓取等开发者场景。
 科技前沿
GitHub日报·11月08日:Agent 基础设施全面开花
Deep dive into 7 new GitHub trending projects today