Claude Fable 5.2登陆Perplexity:效率与性能双突破
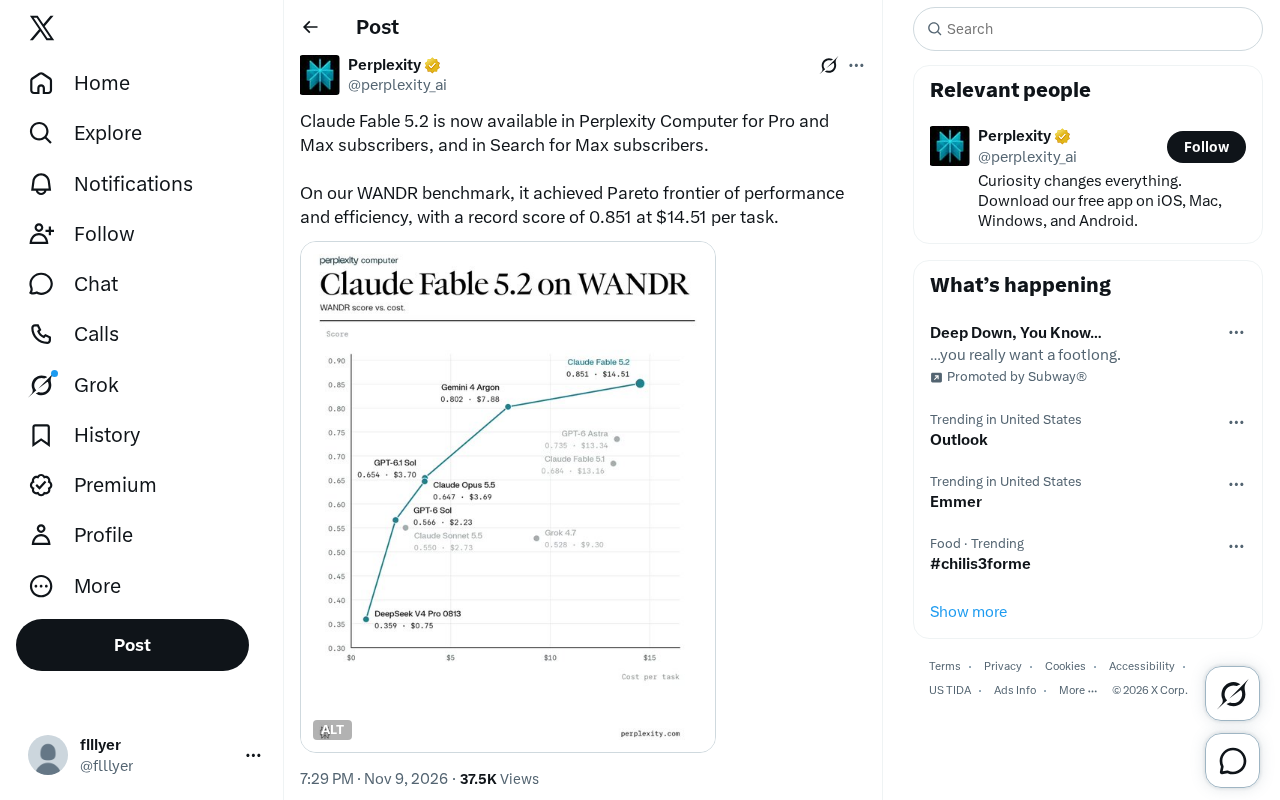
Claude Fable 5.2 登陆 Perplexity,Computer 面向 Pro/Max,Search 仅限 Max。
Perplexity 通过官方推特宣布 Claude Fable 5.2 正式接入其产品:Perplexity Computer 面向 Pro 和 Max 订阅用户开放,Search 功能则仅限 Max 用户使用,形成差异化的订阅分层。官方公布的 WANDR 基准结果显示,该模型在每任务成本 14.51 美元下取得 0.851 的创纪录分数,处于性能与效率的帕累托前沿。文章指出,帕累托前沿意味着给定成本下性能最佳或给定性能下成本最低,是模型选型的关键权衡指标;但由于推文未披露测试方法与对比模型列表,该分数的绝对意义仍需更多上下文。对用户而言,这意味着无需额外配置即可在对应功能中调用新模型,Max 层级在模型覆盖面上的优势进一步凸显。
Perplexity 通过官方推特宣布,Claude Fable 5.2 已正式登陆 Perplexity Computer,面向 Pro 和 Max 订阅用户开放;同时,Max 订阅用户还可以在 Search 功能中使用该模型。这一集成意味着 Perplexity 在模型选择上进一步扩展,将 Claude 系列的最新版本带给更广泛的用户群体。
性能与效率的帕累托前沿
根据 Perplexity 公布的 WANDR 基准测试结果,Claude Fable 5.2 在性能与效率之间达到了帕累托前沿(Pareto frontier)。具体而言,该模型在每任务成本 14.51 美元的情况下,取得了 0.851 的创纪录分数。帕累托前沿意味着在给定的成本约束下,模型实现了最佳性能,或者在给定性能水平下实现了最低成本——这通常是模型选型时最关键的权衡指标。
Perplexity 在推文中特别强调了“record score”这一表述,暗示 0.851 的得分在同类模型中处于领先位置。不过,推文未披露 WANDR 基准的具体测试方法和对比模型列表,因此这一分数的绝对意义仍需结合更多上下文来理解。
帕累托前沿(Pareto frontier)源自经济学中的帕累托最优概念:在一个多目标优化问题中,若不存在任何其他方案能在不使至少一个目标变差的前提下改善某个目标,则该方案处于帕累托前沿上。放到模型选型场景中,两个目标通常是“性能得分”和“单任务成本”。前沿上的点意味着:想再提高分数就必须付出更高成本,想再降低成本就必然牺牲分数;而前沿之外的点则存在“免费改进”的空间——既更便宜又更强。因此前沿本身不是单一最优解,而是一组在不同预算约束下各自最优的候选方案,用户需根据自身成本敏感度在前沿上选取工作点。评估一个模型是否“达到前沿”,需要知道参与比较的模型集合及其各自的位置,这也是仅凭单一坐标(0.851 分 / 14.51 美元)无法判断其领先程度的原因。
每任务成本(cost per task)是衡量模型经济性的常用指标,通常由单次调用消耗的输入/输出 token 数乘以对应单价,再加上推理步数、重试与工具调用等开销折算得出。它与“每百万 token 价格”不同,后者只反映单价,而前者把模型完成任务所需的 token 量、推理长度和失败重试一并计入,因此能更真实地反映端到端开销。对于多步骤、需要长上下文或反复推理的任务,单价低的模型可能因为消耗 token 更多而单任务成本更高,反之亦然。这也是 Perplexity 把 0.851 分与 14.51 美元并列给出的原因:只看得分或只看单价都可能误导选型。需要注意的是,每任务成本高度依赖任务分布与提示设计,跨基准、跨工作负载的数字不能直接比较。
订阅分层与功能覆盖
此次上线采用了差异化的订阅策略:Perplexity Computer 向 Pro 和 Max 用户开放 Claude Fable 5.2,而 Search 功能则仅限 Max 用户使用。这种分层设计反映了 Perplexity 对不同订阅层级用户的价值区隔——Max 用户获得更全面的模型访问权限,Pro 用户则在 Computer 场景中体验新模型。
对于已订阅 Perplexity 的用户而言,这意味着无需额外配置即可在对应功能中调用 Claude Fable 5.2。对于考虑升级订阅的用户,Max 层级在模型覆盖面上的优势进一步凸显。
Perplexity Computer 与 Search 是 Perplexity 面向不同使用场景的两条产品线:Search 是以检索增强生成(RAG)为核心的问答入口,模型在联网检索到的资料基础上组织回答;Computer 则更偏向代理式(agentic)工作流,可拆解多步骤任务、调用工具并连续执行,对模型的推理深度与长上下文能力要求更高。正因两者对模型能力与调用成本的需求不同,厂商常按功能维度而非仅按模型维度做权限区隔。这种“同一模型、不同功能不同档位”的做法,使订阅分层不只是速率与额度差异,也体现在可触及的模型能力边界上,用户在评估是否升级时应以自己主要使用的功能为准。
对用户的实际影响
Claude Fable 5.2 的加入为 Perplexity 用户提供了另一个高性能模型选项。在 Computer 场景中,用户可以利用该模型处理复杂的多步骤任务;在 Search 场景中,Max 用户则能在检索增强的回答中获得 Claude 模型的输出。
从成本效率角度看,0.851 分与 14.51 美元每任务的组合,为关注性价比的用户提供了一个可量化的参考。尽管单任务成本看似不低,但若任务复杂度较高,这一效率表现可能仍具竞争力。
待观察的信息
目前 Perplexity 仅通过推文公布了有限信息,WANDR 基准的详细报告、Claude Fable 5.2 的具体能力边界、以及与竞品的横向对比尚未公开。对于开发者和企业用户而言,这些细节将直接影响模型选型决策。我们将持续关注后续披露。
相关推荐
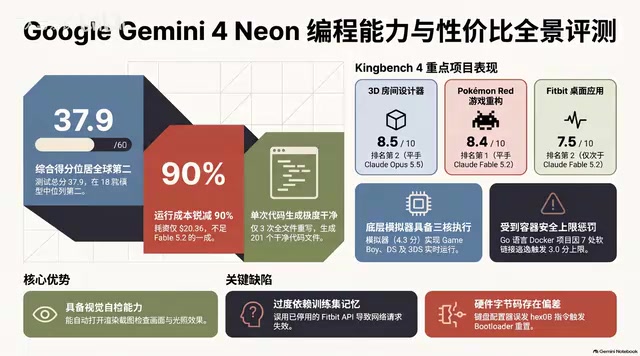
Gemini 4 Neon实测:性价比之王还是自信的灾难?
Gemini 4 Neon 实测深度解析:百万 token 上下文、四档思考级别,KingBench4 一遍过写 201 个文件,成本仅为 Fable 5.2 的十分之一。但它会靠幻觉假数据蒙混、留下 7 个符号链接逃逸漏洞、把键盘写成砖。性价比与危险并存,多模型议会审查才是破局关键。
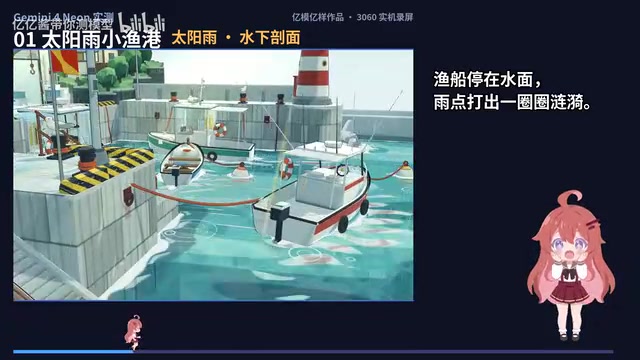
谷歌Gemini 4 Neon实测:6个3D作品惊艳与翻车
谷歌Gemini 4 Neon在3060笔记本上实测6个3D作品:太阳雨渔港细节惊艳,机械键盘配置器完成度高,但软糖物理形变过头、帝王像人脸偏方。多源测评交叉验证,审美在线但物理与人脸是短板。
Gemini 4 Neo写小说网文实测:AI味淡、对话有质感
B站UP主首发测评Gemini 4 Neo写小说网文能力:实测三国穿越开篇生成,AI味淡、对话有情绪质感、危机感塑造到位,并对比4A/4H/4C四个模型差异,演示拆纲续写与审稿纠错全流程。