Claude Managed Agents 实战:ai-newtab 把浏览历史变每日主页

ai-newtab 用 Claude 托管 agent 把浏览历史变成每日新标签页,验证架构的同时暴露隐私与成本缺口。
ai-newtab 是一个用 Chrome 扩展驱动 Claude Managed Agents 生成个性化新标签页的开源项目,整个循环分为采集、提交、生成、渲染四阶段。它的价值在于验证了托管 agent 架构在小体量客户端场景下的可行性——开发者无需自建编排、状态管理和工具调用后端。但代价是用户浏览历史必须离开本地进入第三方 API,敏感信息处理权发生转移。项目的 teardown 记录还指出成本控制的关键在客户端而非 prompt:按天全量重传历史会让 token 消耗线性增长,增量摘要才可持续。安全方面存在四个待补缺口:历史粒度控制、扩展权限粗细、API 密钥存放、返回内容注入风险。门槛降低不等于责任转移。
一个用 Claude 重写新标签页的开源实验
浏览器的新标签页是互联网上访问频率最高的界面之一,却长期停留在「搜索框 + 常用网站图标」的形态。一个名为 ai-newtab 的开源项目尝试改变这一点:它把用户的浏览历史交给 Claude Managed Agents 会话处理,生成一个每日更新的个性化主页,整个流程由 Chrome 扩展驱动。
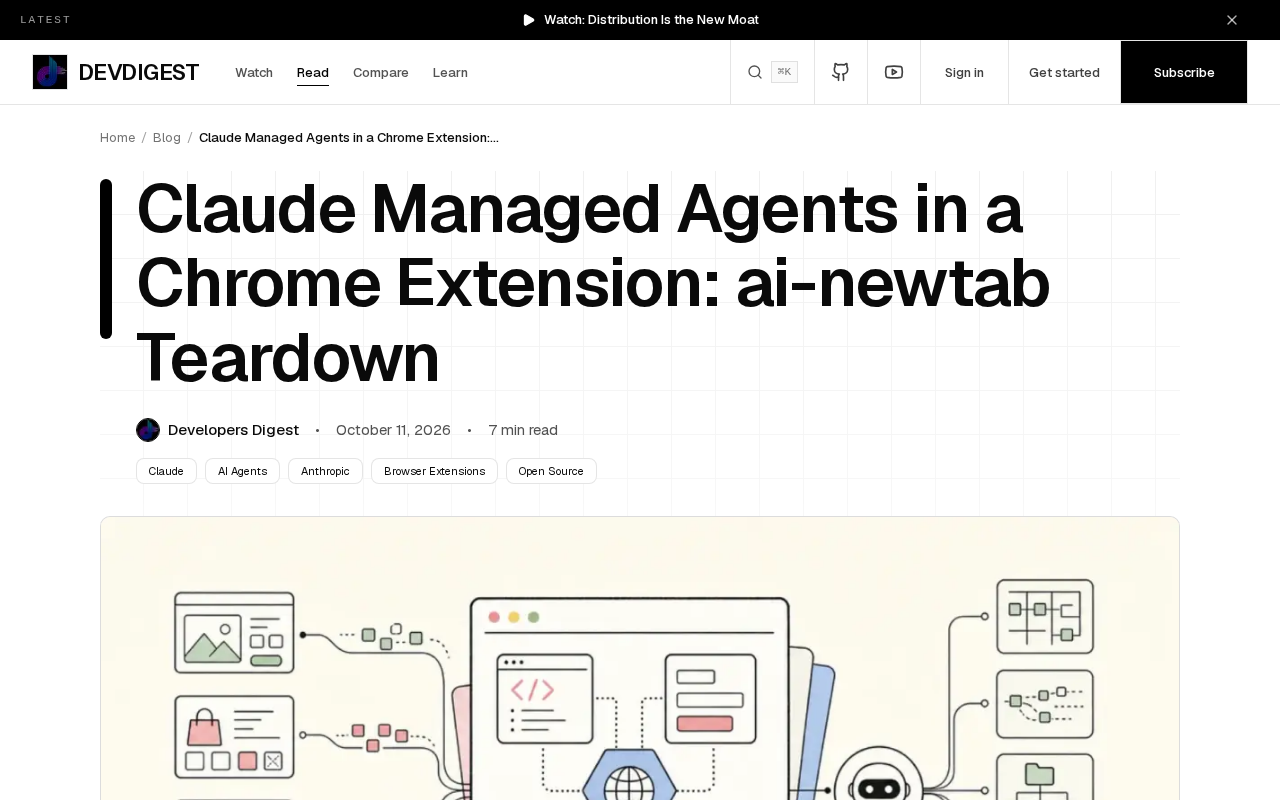
这不是又一个「AI 摘要」插件,而是一次对 Managed Agents 架构在小体量客户端场景下的完整验证。项目源码里的 teardown 记录揭示了几个值得关注的问题:这个循环究竟怎么跑、扩展向 API 发送了什么、成本宣称是否站得住脚,以及在照抄之前必须补上哪些安全缺口。
闭环是怎么跑起来的
ai-newtab 的核心逻辑可以拆成四个阶段。
采集:扩展在本地读取浏览历史,筛选出近期访问的页面。
提交:这些数据被打包,发送到一个 Claude Managed Agents 会话。这里的关键词是「Managed」——开发者不需要自己搭建 agent 编排、工具调用和状态管理的后端,Anthropic 的托管服务承担了这部分工作。
生成:会话根据输入的历史数据,产出当天的首页内容——可能是一组推荐链接、一段概览文字,或者某种主题聚合。
渲染:扩展接收返回结果,替换浏览器默认的新标签页。
这个架构有取巧之处,也有代价。取巧在于,Managed Agents 把 agent 生命周期的复杂度外包给了平台,一个 Chrome 扩展的作者可以用相对少的代码实现「有状态、可迭代」的 AI 功能。代价在于,用户的浏览历史必须离开本地,进入第三方 API。
Claude Managed Agents 是 Anthropic 提供的一类托管式 agent 服务:开发者通过 API 声明任务目标与可用工具,平台负责会话状态持久化、工具调用编排、上下文管理和失败重试等运行时环节。与传统「自己写一个 while 循环 + function calling」的裸调 API 模式相比,托管模式把 agent 的「生命周期」抽象成了平台侧的黑盒,客户端只需提交输入并接收输出。对于 Chrome 扩展这类没有服务端基础设施的小体量场景,这意味着不必自建会话存储、任务队列和状态机,就能获得「有状态、可多轮迭代」的 AI 行为。代价是运行时行为部分不可控,且数据必须经由平台处理。
发往 API 的数据与成本账
disassembly 记录里最值得推敲的是数据流向。扩展把浏览历史发送到 Claude API 是实现功能的前提,但这意味着敏感信息处理权从用户端转移到了服务端。浏览历史能反映的内容远超「你看了什么网站」——它暗示了健康状态、财务情况、政治倾向、人际关系。
成本方面,项目给出了一个成本宣称(cost claim),但从 Managed Agents 的计费结构看,这类「每天一次、带上下文」的会话成本取决于两个变量:每次提交的历史数据量,以及会话维持的状态长度。如果扩展每天把完整历史重新灌入一次,token 消耗会随使用时间线性增长。真正可持续的做法是在客户端做增量摘要,只把变化部分交给 agent。
这一点对想复制这个项目的人尤其重要:成本控制的杠杆在客户端,不在 prompt 里。
Token 成本是理解这类「每日一次 + 带上下文」会话经济性的关键。大模型的计费按输入与输出 token 数结算,而每次把浏览历史灌入会话,历史记录本身就会作为输入 token 被反复计费。如果每天全量重传,输入量随使用天数累积,成本曲线接近线性增长;若在客户端先做去重、聚合或增量摘要,只把「当日新增且经过脱敏的特征」提交,输入量就能维持在一个大致恒定的水位上。此外,会话维持的状态长度也会影响成本——长会话意味着每轮都要携带前序上下文,短会话加冷启动则输入更小但可能牺牲连续性。这两条杠杆都握在客户端手里。
照抄之前要补的安全缺口
teardown 里明确列出了几个尚未闭合的安全缺口,这也是这篇文章最有价值的部分。
历史数据的粒度控制缺失。如果扩展不做域名白名单或敏感站点过滤,银行、医疗、私人邮箱的记录会一并进入 API。
扩展权限范围。Chrome 扩展的 history 权限是粗粒度的,一旦授予,扩展可以读取全部历史。用户很难在「部分授权」和「完全授权」之间做选择。
API 密钥的存放位置。如果密钥打包在扩展里,任何人都能提取;正确做法是经由开发者自建的中转服务,但这又引入了新的信任方。
返回内容的注入风险。AI 生成的首页内容会渲染在特权页面上,如果对 agent 输出不做消毒,理论上存在注入向量。
这几个缺口的共同点是:它们不是 Managed Agents 本身的缺陷,而是把托管 agent 接入客户端时必然要面对的设计决策。Anthropic 负责了 agent 的运行时,但数据边界、权限模型和输出安全仍然是开发者的责任。
浏览器扩展的权限模型值得单独说明。Chrome 扩展通过 manifest.json 声明权限,history 属于「可读取全部浏览历史」的粗粒度权限,用户只能在安装时整体授予或整体拒绝,无法按域名、时间范围或站点类别做部分授权。这意味着一旦扩展获得该权限,它技术上就拥有了读取用户所有历史记录的能力,是否真的只读取「近期访问的页面」完全依赖扩展代码的自觉。对于处理敏感数据的扩展,更稳妥的做法是把权限申请范围压到最小、在客户端做过滤后再上传,或者改用 activeTab、用户主动选择等更细粒度的替代方案,而非默认索要全量历史权限。
托管 Agent 模式对个人开发者的意义
ai-newtab 这类项目的出现,说明 Managed Agents 正在把「agent 应用」的开发门槛从「需要一个后端团队」降到「一个前端工程师就能试」。这在一年前还难以想象——有状态的 agent 循环、工具调用、会话持久化,过去都是自建基础设施的工作量。
但门槛降低的同时,责任并没有一起转移。托管服务解决了「怎么跑」,没有解决「该不该发」「发给谁」「发多少」。ai-newtab 的 teardown 恰好是一个反面教材式的提醒:架构上越省事的地方,往往就是安全上越容易偷懒的地方。
对于想尝试类似方案的开发者,比较务实的路径是:客户端先做数据最小化和脱敏,只上传聚合后的特征而非原始 URL 列表,把 Managed Agents 当作「生成层」而非「数据层」。这样既保留了托管 agent 的便利,又不会把用户最敏感的数据一次性交出去。
相关推荐

WorkBuddy全流程教程:从零搭建AI办公自动化智能体
WorkBuddy 全流程教程精讲:从下载安装、三种工作模式到多模态绘本视频实战,再到专家团搭建智能体与工作流配置,帮你用低成本 AI Agent 实现办公自动化。

WorkBuddy智能体全攻略:7天从入门到自动化实战
基于B站256集WorkBuddy全套精讲课程,系统拆解腾讯AI办公工作台的核心能力:Agent原理、Skill封装、连接器跨平台、定时自动化、知识库与零代码开发,附学习路径建议。

8个AI账号翻车7个:我用AI干活的真实复盘
B站8个AI运营账号仅1个跑通。本文拆解"演AI"与"用AI干活"的本质区别,分析5条视频217万播放背后的产能控制、评论区运营和交付节奏策略。