Claude Opus 5.5 报错激增:官方已修复,11分钟故障复盘
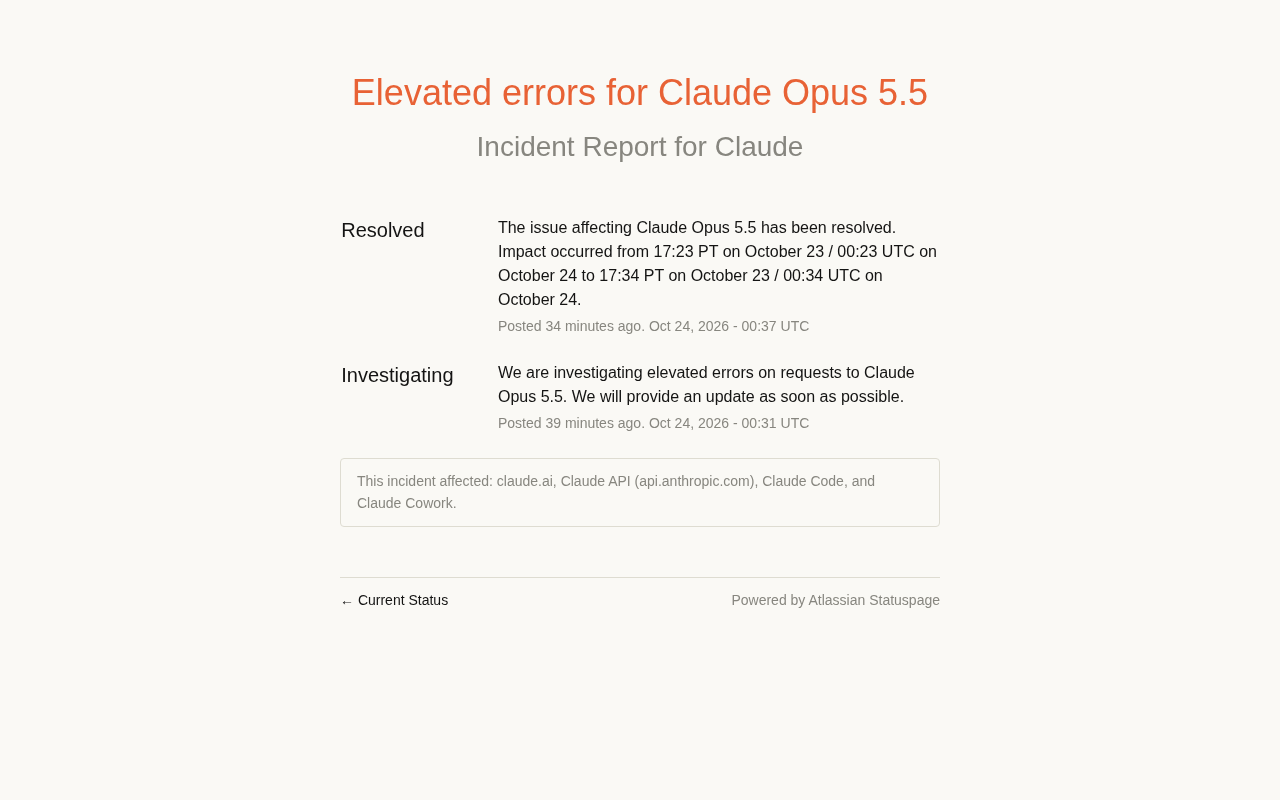
Claude Opus 5.5 出现约11分钟请求错误率上升,官方6分钟内定位并解决。
Claude Opus 5.5 在太平洋时间10月23日17:23至17:34出现请求错误率上升,官方状态页于UTC 00:31发布「Investigating」,6分钟后更新为「Resolved」,实际影响窗口约11分钟。公开信息显示故障仅限Opus 5.5的推理请求,未波及其他模型或平台级服务。对开发者而言,短时错误率抬升仍可能触发重试风暴、队列积压与用户侧失败,文章建议配置备用模型、指数退避重试、状态页订阅及熔断降级,并强调监控应关注错误率突增与百分位而非仅看整体成功率。
事件概述:Claude Opus 5.5 出现异常错误率
根据官方状态页面发布的信息,Claude Opus 5.5 在短时间内出现了请求错误率上升的情况。官方于 UTC 时间 10 月 24 日 00:31 首次发布「Investigating」状态,确认正在调查针对 Claude Opus 5.5 的请求错误激增问题。约 6 分钟后,官方更新为「Resolved」,宣布问题已解决。
从状态页披露的时间线看,实际影响区间为太平洋时间 10 月 23 日 17:23 至 17:34(对应 UTC 10 月 24 日 00:23 至 00:34),持续约 11 分钟。这是一次典型的高优先级、短时故障:发现快、定位快、恢复也快,但对依赖该模型的生产系统而言,十几分钟的中断仍可能造成可见的业务波动。
故障时间线与官方处置
从「调查中」到「已解决」仅用 6 分钟
官方状态页的两次更新构成了本次事件的完整公开记录:
- 00:31 UTC:发布「Investigating」,表示正在调查 Claude Opus 5.5 请求错误率上升的问题,并承诺尽快提供更新。
- 00:37 UTC:发布「Resolved」,确认影响 Claude Opus 5.5 的问题已解决,并给出精确的影响窗口:10 月 23 日 17:23 PT 至 17:34 PT(即 10 月 24 日 00:23 UTC 至 00:34 UTC)。
你可能没注意到,状态页从「调查中」到「已解决」的间隔只有 6 分钟,而实际影响窗口为 11 分钟。这意味着官方在故障发生后很快完成了响应,并在恢复后第一时间补充了影响范围说明。对于大模型 API 服务而言,这种「先确认、后复盘」的披露节奏是相对规范的。
影响范围:仅限 Opus 5.5 请求
官方表述明确指出,受影响的是「对 Claude Opus 5.5 的请求」,即错误率上升发生在该特定模型的推理请求层面。状态页未提及更广泛的平台故障,也未说明是否波及其他模型或 API 端点。从公开信息判断,这是一次针对单一模型服务的局部异常,而非全平台级事故。
「Error Rate」在 API 监控语境下的含义
错误率(Error Rate)通常指在给定时间窗口内,返回错误状态码(如 HTTP 5xx 或模型层面的超时、限流)的请求数占总请求数的比例。对于大模型 API,错误率上升可能源于推理集群过载、下游依赖故障、区域网络抖动或模型服务本身的异常。官方使用「elevated errors」而非「outage」,说明错误率偏离了正常基线但服务并未完全不可用。团队在解读状态页时,应结合自身监控中的错误码分布(如 429 限流与 500 内部错误)判断故障性质,因为不同错误类型对应的重试策略和降级方案截然不同。
对开发者的实际影响与应对建议
11 分钟窗口足以触发生产告警
对于将 Claude Opus 5.5 接入生产环境的团队来说,11 分钟的错误率抬升并非可以忽略的小事。常见的连锁反应包括:重试风暴导致队列积压、上游服务超时、用户侧出现失败提示,以及监控系统触发 PagerDuty 类告警。如果业务逻辑中没有对模型调用失败做降级处理,短时故障也可能演变为用户可感知的服务中断。
多模型冗余与重试策略仍是必修课
这次事件再次说明,单一模型依赖存在固有风险。工程上可考虑的缓解手段包括:
- 配置备用模型:在 Opus 5.5 报错率超阈值时自动切换至其他可用模型,保证核心链路不中断。
- 指数退避重试:对幂等请求采用带抖动的退避重试,避免瞬时重试放大后端压力。
- 订阅官方状态页:将状态页 RSS 或 webhook 接入告警体系,比等待用户投诉更早发现问题。
- 熔断与降级:为模型调用设置熔断阈值,触发后走缓存结果或简化流程。
指数退避与抖动(Exponential Backoff with Jitter)
指数退避是一种重试策略:每次重试的等待时间按指数增长(如 1s、2s、4s、8s),并设置最大重试次数和上限,避免客户端在服务恢复前持续高压打满后端。抖动(Jitter)是在等待时间上叠加随机量,防止大量客户端在同一时刻同步重试形成「重试风暴」。对于大模型 API,建议仅对幂等请求(如纯文本生成且不依赖会话状态)启用自动重试,并对流式响应设置独立的超时与中断处理逻辑,以免重试导致重复计费或上下文错乱。
熔断器模式(Circuit Breaker)
熔断器是一种保护性设计:当对某个下游服务(此处为 Opus 5.5 的 API)的失败率超过阈值时,熔断器从「关闭」转为「打开」状态,后续请求直接快速失败或走降级路径,不再真正调用下游;经过一段冷却时间后进入「半开」状态,放行少量探测请求,若成功则恢复关闭状态。熔断器能防止故障期间线程池或连接池被耗尽,并为备用模型切换争取时间。实现时需注意阈值、冷却窗口与半开探测量的调优,避免过于敏感导致正常波动被误判为故障。
从一次短故障看大模型服务的可用性现状
大模型 API 的可用性正在成为工程团队选型时的硬指标。一次 11 分钟的故障本身并不罕见,真正值得关注的是三个维度:故障披露的透明度、恢复速度,以及影响范围的界定清晰度。本次事件中,官方在状态页给出了精确到分钟的影响窗口,这对需要做故障归因和 SLA 核算的团队是有价值的输入。
另一个容易被忽视的点是「错误率抬升」与「完全不可用」之间的区别。官方措辞是「elevated errors」,说明并非所有请求都失败,而是失败比例高于正常水位。这类部分失败对监控的挑战更大:平均值可能看起来正常,但尾部错误率已经伤及部分用户。团队在设置告警时,应关注错误率的百分位与突增检测,而不只是整体成功率。
常见问题
Claude Opus 5.5 现在还能正常使用吗?
根据官方状态页最新更新,问题已解决,服务已恢复。
这次故障持续了多久?
官方给出的影响窗口为太平洋时间 10 月 23 日 17:23 至 17:34,约 11 分钟。
是否波及其他 Claude 模型?
公开状态信息仅提及 Claude Opus 5.5 的请求错误率上升,未说明波及其他模型。
相关推荐

FlyEnv 插件实测:可视化运行 llama.cpp 与 GGUF 模型管理
FlyEnv 推出 llama.cpp 官方插件,提供多个 Metal 运行时并存管理、公共 GGUF 仓库索引与模型文件类型标注,以及上下文、线程、GPU 层数等推理参数可视化配置,支持模板与投机解码随模型保存,一键启动本地 LLM 推理服务。

前端如何进阶AI智能体开发?从OpenClaw拆解系统级Agent架构
从B站公开课演示的OpenClaw出发,拆解系统级AI智能体的三层架构与通用公式,分析前端开发者基于TypeScript切入Agent开发的路径、插件化设计与安全记忆层难点,附面试回答框架。
WorkBuddy实战:AI Agent如何自动批量转换与归档文件
通过B站UP主珊瑶老师的实测,对比豆包与WorkBuddy在文件批量转换任务中的表现,解析AI Agent如何从“给方案”到“直接执行”,附完整操作流程与积分消耗参考。