Claude Opus 5.5对决GPT-6:一场实测中的降维打击

实测显示Claude Opus 5.5在3D建模与交互生成上全面领先GPT-6轻量档,但两者并非同量级对决。
本文基于B站UP主横向实测,对比Claude Code的Opus 5.5与ChatGPT的GPT-6(轻量档)在高思考强度下的表现。三项测试任务——Blender茶壶建模、森林城堡漫步场景、GTA风格小游戏——中,Opus 5.5在完成度、动态交互(NPC行走、水流动画)和系统逻辑完整性上均明显领先,GPT-6则多停留在静态几何体层面。算力消耗上两者均出乎意料地低(7% vs 5%)。此外,两家平台的账号限流透明度差异也引发讨论:Claude直接封号vs ChatGPT隐性限流导致404,对重度付费用户的可预期性影响截然不同。需要指出的是,本次对比并非同量级,GPT-6使用的档位推理深度甚至不及上一代最低思考档,因此结论需在此背景下解读。
凌晨时分,Anthropic的Claude Code和OpenAI的ChatGPT几乎同步推送了新模型——前者带来Opus 5.5,后者祭出GPT-6系列。两款旗舰同台竞技本应是棋逢对手,但经过一轮实测,结论却意外地一边倒:Opus 5.5展现出令人震惊的3D生成与交互能力,而GPT-6在同类任务上表现只能用"稀疏平常"来形容。
本文基于B站UP主的横向实测,拆解这场"并不平等的对决"背后的能力差距。
测试设置:高思考强度下的正面对比
这次测试双方均开启高思考强度配置。Claude Code一侧使用Opus 5.5,ChatGPT一侧使用GPT-6。需要说明的是,GPT-6在本轮使用的是其系列中的一个档位(视频中称"6售",推测指轻量/低算力档),而OpenAI官方也坦言这一档位的推理深度可能还不及上一代模型的最低思考档。
换句话说,严格意义上这并非同量级对决。UP主坦言,Opus 5.5更合理的对手应该是上一代的高端模型,但为了测试"新对新",才让两者同台。这也正是标题"并不平等的对决"的由来。
案例一:提壶骑自行车的Blender建模
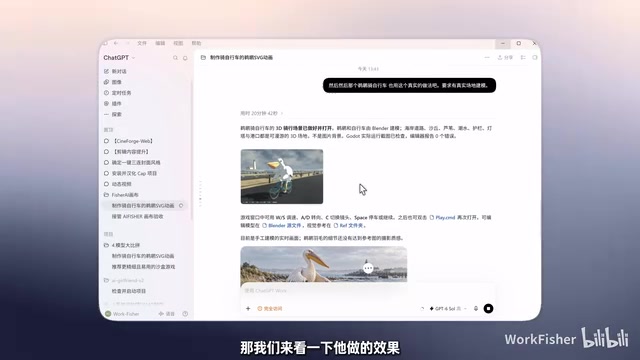
第一个测试是社区熟悉的"茶壶骑自行车"场景——这个题目因为极易生成畸形结构而成为模型能力的试金石。本次要求两款模型调用Blender完成真实建模。
结果上,GPT-6生成的模型在结构合理性上明显吃力,细节粗糙;而Opus 5.5同样调用Blender完成生成,成品的完成度和真实感要高出一截。UP主的判断是,二者在这类空间建模任务上"某种意义上并不是一个层级的模型"。
Blender是一款开源的三维图形软件,支持建模、骨骼绑定、动画、渲染等完整3D制作流程。AI调用Blender通常通过生成Python脚本(Blender内置bpy模块)来驱动建模操作,而非直接操纵图形界面。"茶壶骑自行车"这类题目之所以成为模型能力的试金石,在于它要求模型理解非常规的空间拓扑关系——茶壶的壶嘴、壶盖与自行车车架之间的咬合方式在现实中并无参照,模型必须自行推理出合理的结构约束,稍有偏差就会产生穿插或悬空的畸形几何体。这不仅考验代码生成能力,更考验模型对三维空间的隐式推理。
案例二:森林小城堡场景的质感与交互
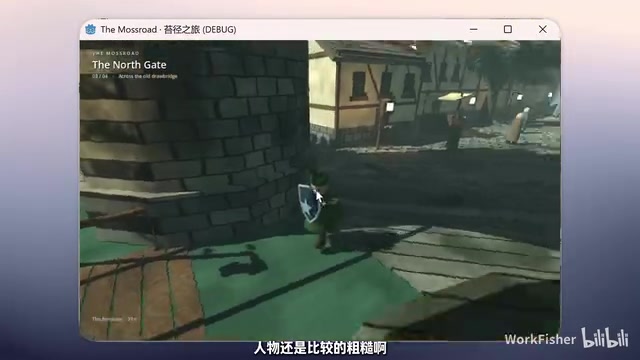
第二个测试要求搭建"森林+小城堡"的漫步场景。GPT-6的产出算不上差——该有的元素基本齐全,但人物依然停留在粗糙的几何形状,没有做出交互(即便提示词中明确要求了交互),整体"无功无过"。
Opus 5.5在相同提示下的表现则丰富得多:场景里出现了雾谷、漫步小道、小城堡等层次分明的元素。更关键的是交互能力——城堡里的NPC会走动(虽然可能只是简单循环),喷泉有水流动画,甚至还有一个"卖瓜/摆摊"的角色带着动作,被UP主形容为"很灵性"。
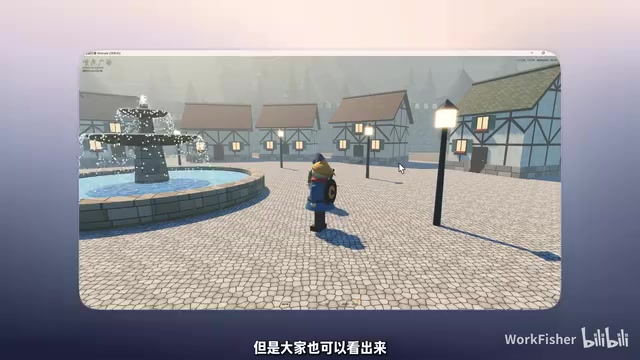
这种从静态几何体到动态可交互场景的跨越,是本次测试中两款模型差距最直观的体现。
案例三:GTA风格小游戏的系统完整度
第三个案例是构建GTA风格的开放场景游戏。Opus 5.5生成的版本实现了多项系统级交互:角色可以进入房子、上车开车、查看电视、打开冰箱、上下楼层。虽然房间布置相当简陋("家徒四壁"、冰箱空空),但整套交互逻辑是跑通的,开车时还配上了怀旧音乐与夕阳氛围。这些系统性功能展现出模型在复杂逻辑编排上的能力。
GTA(Grand Theft Auto)风格游戏在AI测试场景中常被用作"系统复杂度压力测试",因为它要求同时实现多个相互耦合的子系统:角色移动与碰撞检测、载具驾驶逻辑、室内外场景切换、可交互道具状态管理等。AI要在单次提示中生成可运行的完整代码,需要在逻辑编排层面保持各系统的接口一致性,任何一处状态变量命名冲突或事件循环设计失误都会导致整体崩溃。因此,能"跑通"所有交互路径本身就是对模型长上下文代码规划能力的有效度量,而不仅仅是代码风格或单一函数的生成质量。
算力消耗:省到让人意外
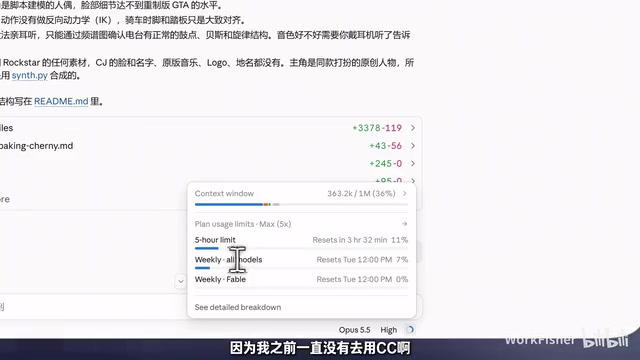
消耗量对比给出了另一个维度的结论。Opus 5.5从零开始完成三个项目后,消耗量仅为7%,UP主直呼"没想到这么省"。GPT-6一侧则更极致,整轮测试只用了约5%,在纯算力效率上占优。
不过UP主也点出一个微妙之处:有时模型过度"省算力"并不是好事,可能意味着推理深度被压缩。Opus 5.5在高完成度与低消耗之间的平衡,反而是它这次最让人惊艳的地方。
这里的"消耗量"通常指API调用中的Token用量或平台侧显示的计算额度百分比,而非用户设备的本地算力。对于Claude Code这类以代码生成为主的场景,每次生成完整项目会产生大量输出Token,7%的消耗意味着在套餐额度内仍有充裕余量。值得注意的是,高思考强度模式(Extended Thinking)会在输出前产生大量内部推理Token,这部分在计费上的处理方式各平台不同——Anthropic将thinking tokens单独计价且通常折扣计入,这可能是Opus 5.5实际显示消耗偏低的原因之一,并非单纯意味着推理量少。
账号可用性之争:真小人还是伪君子
测试之外,UP主还抛出一个对用户体验更现实的问题。他持有三个ChatGPT 20X账号,其中两个被限流路由,解除后再试却全部显示404——没有明确封号,却与封号无异。
相比之下,Claude Code虽然以"喜欢封号"著称,但至少是明面上直接处理。由此引出那句贯穿全片的调侃:"你更喜欢真小人,还是伪君子?"这其实指向了AI服务商在限流、可用性透明度上的治理风格差异,对重度付费用户而言,可预期性本身就是价值。
限流(Rate Limiting)与路由降级是大型AI平台在高峰期管理资源的常见手段。"路由"在此语境下指平台将用户请求调度到不同质量或负载的后端模型实例,被限流路由的账号可能在不知情的情况下使用到性能更低的版本。ChatGPT出现的404响应通常表示请求被服务端拒绝但未附带明确说明,这与主动封号在用户体验上的区别在于:前者缺乏明确的申诉或恢复路径,用户无法判断是临时故障还是账号状态异常,可预期性极低。对重度付费用户而言,服务可用性的透明度直接影响工作流的可靠性,这也是为何"治理风格"本身会成为平台选择的重要维度。
小结
这场对决在模型档位上确实不对等,但结论足够清晰:在3D建模、场景交互、游戏系统这类复杂生成任务上,Claude Opus 5.5展现出明显优势,且算力消耗出奇地低。GPT-6对应档位的表现则偏保守,更像一款强调效率的"量大管饱"型模型。对于看重生成质量与交互完整度的创作者,Opus 5.5是本轮更值得期待的选择;而账号可用性与服务透明度,则是选择平台时同样不可忽视的现实因素。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。