Claude Opus 6疑泄露:多款下一代模型暗测中

Anthropic、OpenAI、Google 下一代模型暗测迹象密集,竞赛聚焦 agentic 与长上下文。
文章梳理了近期三家头部 AI 公司下一代模型的暗测线索。Anthropic 方面,Claude Opus 5.5 请求被大量路由到未公开 checkpoint,性能明显提升,并以约 2700 万 tokens 生成 JavaScript 逐帧动画,展示纯代码路径在程序化视觉上的竞争力。OpenAI 的 GPT-6.1 Sol 将默认上下文从 272K 提升至 500K tokens,订阅用户不额外付费。Google 则出现 Gemini 4 的 Argon 与 Barium-B 两个 checkpoint 对比,后者表现更优。文章还引用 Karpathy 的估算,指出前沿模型的重度使用者仅约 2000 万人,AI 能力认知存在巨大信息差,并提醒部分流传故事需核实。
最近一段时间,Anthropic、OpenAI、Google DeepMind 三家同时在“暗测”下一代模型的消息密集出现。从社区流传的路由异常,到开发者在 IDE 里发现新 checkpoint,再到 3D 场景与程序化动画的演示,这些碎片拼在一起,构成了一个相当有信息量的信号:一场围绕下一代旗舰模型的竞赛,正在测试通道里悄悄推进。
Claude Opus 新 checkpoint:是 5.6 还是 Opus 6?
据多位用户反馈,他们在 Claude Code 中选择 Opus 5.5 发起请求时,有一定比例被路由到了一个“神秘的 Opus Next checkpoint”,社区传言这一比例至少达到一半。这些用户普遍表示,输出质量相比已有的 Opus 5.5 有实质性提升。
目前命名尚未确认,社区猜测落在 Opus 5.6 甚至 Opus 6 系列上。还有一个间接线索:这个模型出现在了 OpenCode 的模型目录中——通常这类闭源模型在新版本发布前的内测阶段,会以这种方式短暂现身。
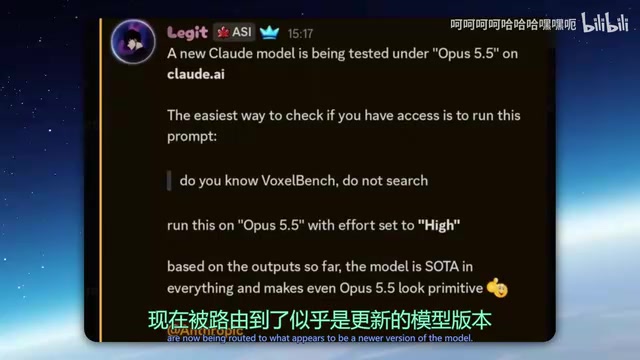
视频里给出了一个粗糙但有趣的探测方法:在 Claude Code 中把 thinking effort 调到 high,然后问模型是否知道“voxelbench”这个较新的事物,并明确要求不要使用工具搜索。如果模型能在不联网的情况下认出来,说明它的知识截止时间比 Opus 5.5 更晚,大概率就是新 checkpoint。需要强调的是,这只能作为参考信号,并非确凿证据。
27M tokens 的程序化动画演示
支撑“能力跃升”判断的,是一段用 JavaScript 逐帧绘制人类一生的动画。据称整个过程只用了两条提示、大约四行指令,执行两小时,在最高思考强度下消耗了约 2700 万 tokens。
真正值得注意的不是动画本身有多好看,而是它的生成路径:Opus 系列并没有针对视频或音频数据做过训练,模型是纯粹通过代码来“渲染”视觉内容的。在物理表现和细微视觉细节上,这种做法已经能和一些专用图像、视频生成模型掰手腕。对于可交互视觉、程序化广告素材这类场景,这条路线可能比传统生成模型更具成本优势。
checkpoint 是机器学习模型训练过程中的一个中间快照:训练不是一次完成的,而是按批次反复迭代参数,每隔一段时间就把当前权重保存成文件,这些文件就是 checkpoint。厂商在正式发布前,常会把不同训练阶段的 checkpoint 部署到小流量通道做 A/B 测试,用户通过 API 或产品界面访问时,可能被路由到不同版本——这正是文中“路由异常”“神秘 checkpoint”的技术来源。也因此,同一个模型名背后可能存在多个能力不同的快照,社区常用知识截止时间、tokenizer 指纹、上下文长度等特征来反推具体版本。
程序化生成(procedural generation) 指用算法和代码规则而非预先制作好的素材来生成内容,常见于游戏中的地形、植被和动画。与扩散模型直接“画”出像素不同,程序化路径让模型输出可执行的 JavaScript,再由浏览器逐帧渲染出画面。这条路线的好处是可交互、可参数化、可复现,且不依赖视频训练数据;代价是需要模型具备很强的长程代码规划与调试能力。文中 2700 万 tokens 的消耗,说明模型在生成过程中进行了大量内部推理、试错和代码修订,这也是判断其 agentic 能力的一个侧面指标。
GPT-6.1 Sol:默认上下文翻倍到 500K
OpenAI 的“28 天连续发布”进行到第 7 天,带来了一项很实在的更新:GPT-6.1 Sol 在 Codex 和 ChatGPT Work 中的默认上下文窗口从 272K tokens 提升到 500K tokens,增幅约 84%,并且官方表示后续还会继续扩大。
对长时间运行的编码 agent 来说,这个变化的意义在于减少上下文压缩和摘要的频率——模型可以更完整地记住代码、对话和项目细节,很多情况下反而降低了总 token 消耗。更关键的是,通过订阅使用时不额外收取长上下文费用,相当于默认额度接近翻倍而成本不变。
上下文窗口(context window) 指模型单次请求中能“看到”的最大 token 数量,包含系统提示、对话历史、代码文件与工具返回结果。窗口越大,模型越能保持长任务的连贯性,但注意力计算成本随长度快速增长,因此厂商通常对超长上下文单独计费。文中“减少上下文压缩和摘要的频率”指的是:窗口不足时,agent 框架必须把旧内容压缩成摘要再喂给模型,这会丢失细节并引入额外 token 开销;窗口扩大到 500K 后,很多项目可以整段保留,反而更省。
Karpathy 的观察:我们活在两个 AI 世界里
前特斯拉 AI 总监、OpenAI 创始成员 Andrej Karpathy 在 X 上分享了一组估算,精准描述了当前的分裂状态:约 60 亿人几乎没怎么接触过大语言模型,10 到 20 亿人只是浅层使用,真正用前沿模型做复杂编程、数学和专业工作的约 2000 万人,而能接触到最先进系统内部权限的,可能只有约 5000 人——他们在用成千上万个 agent 协作推进大型软件项目、科学发现和数学问题。
他把差距归结为三点:任务的难度、AI 擅长的领域(编程和数学尤其突出)、以及你能否拿到最强的模型。用 ChatGPT 总结邮件的人,和在编码 agent 里把数周工作量压缩到数小时的人,体验到的几乎是两种技术。日常泡在演示视频里的从业者容易忘记,这种能力对大多数人来说仍然遥远——所谓 AI 泡沫,某种程度上是认知上的信息差。
agentic coding 指让模型以自主 agent 的形式完成编码任务:它不仅能补全代码,还能读取仓库、运行测试、根据报错反复修改,并在多轮工具调用中维持目标。这类能力高度依赖长上下文、工具调用协议和稳定的指令遵循,也是当前各家暗测模型竞争的核心方向。文中反复出现的“长时间自主运行的 agent 任务”“agentic 能力”,正是指模型在无人干预下持续工作数小时、消耗数千万 tokens 仍不跑偏的能力,这与单轮问答的体验有本质区别。
Google 的多线并进:Gemini 4 系列 checkpoint 混战
Google DeepMind 这边的测试痕迹更零散,也更密集。有开发者注意到,通过反重力(Anti-Gravity)路由的 Gemini 3.8 Flash 突然能认出某个此前完全不认识的新概念,而同一模型通过 API 和 Gemini Chat 访问时却依然不认识——这通常意味着反重力通道指向了一个更新的 checkpoint。
关于 Gemini 4,社区正在对比两个 checkpoint:较早的 Argon 和更新的 Barium-B。早期比较显示 Barium-B 明显优于 Argon 版本,有推测认为它可能就是 Gemini 4 Carbon 更新。目前 Gemini 4 系列的候选命名已经出现 Carbon、Argon 以及 Flash 等多个分支,不排除同批发布的可能性。
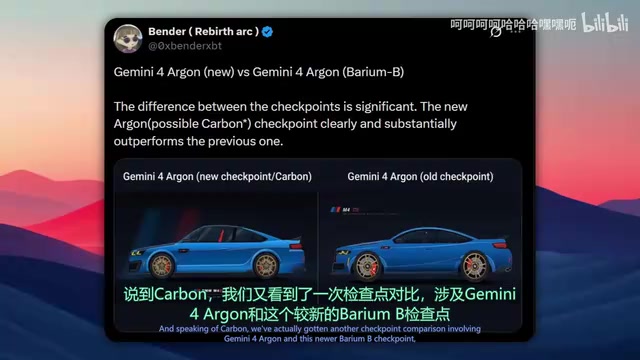
Argon 的演示素材包括 Vizier 国际象棋、岛屿建造器和微观世界生态箱,都是可交互的实时程序化生成。有说法称 Argon 的发布被推迟,原因正是 Google 在继续加码其 agentic coding 能力、塞入新的 checkpoint。
其他值得留意的暗测模型
- Hermes Agent 上的 MissingNo:限时免费开放的编码与推理模型,社区通过 262K 上下文、131K 最大输出、5 级推理以及 tokenizer、空间 token 和工具调用模板的指纹比对,怀疑它是 Reflection AI 的 BEAM 501B A23B。
- Arena 上的 stealth 图像模型 6-7:输出风格与此前 Grok Imagine Image 2.0 高度相似,被认为可能是新一代 XEI 图像模型。
- Anthropic 内部代号 Arborio 与 Iggy:Arborio 的图标指向 Claude Health,可能把美国区移动端的健康体验搬到网页;Iggy 带太阳图标并标注为 preview,被猜测是 Anthropic 的常驻主动式 agent,类似 OpenAI 的 proactive agent 方向。
两个被广泛传播、但需要核实的故事
Vibe coding 游戏上 Steam:一款完全用 Opus 写出来的类“锅铲战争”游戏据称正在热卖,视频作者认为如果这类作品收入突破百万美元量级,会成为游戏行业的一个转折点——但注意,素材中并未给出可验证的具体营收数字,这仍属于流传中的说法。
赛博朋克 2077 跑在 Windows XP 上:这条一度病毒式传播的说法,后续被指实际是在 Windows 10 上运行一个把界面伪装成 XP 的 mod,所谓用 Opus 5.5 重新编译、跑到 25 到 30 帧的说法并不成立。视频作者自己也承认最初信以为真。这恰好说明,当 AI 编程演示越来越强,伪造和真实之间的边界也在变模糊,读者需要多留一道核实工序。
小结
这一轮泄露和暗测有几个共同特征:模型尚未官宣,但路由异常、模型目录现身、checkpoint 命名对比等间接证据彼此印证;演示重心从纯文本转向程序化 3D 场景、可交互模拟和长时间自主运行的 agent 任务;而厂商选择在正式发布前反复迭代 checkpoint,说明这轮竞争的焦点已经落到 agentic 能力和长上下文工程上。在官方确认之前,一切仍应视为传言,但方向足够清晰。
相关推荐

AI能直接读懂神经网络权重:模型能力已超出预期?
Reddit开发者实验显示,语言模型能直接阅读神经网络权重并推断其功能。Astra、Opus 5.5和Muse Spark 1.3均通过测试,引发对模型泛化能力与训练来源的讨论。

印度微短剧市场爆发:EloElo获NBCUniversal 8000万美元投资
印度社交娱乐平台EloElo获NBCUniversal 8000万美元投资,加码微短剧平台StoryTV。StoryTV月活超3300万,印度微短剧市场正吸引全球资本关注。

多旋翼无人机声学检测:融合手工特征与预训练嵌入
研究揭示无人机声学检测中随机划分导致数据泄漏,提出源不相交评估协议下融合手工声学特征与YAMNet嵌入的堆叠集成方法,准确率达95.29%,为低成本无人机探测提供可靠基准。