Claude 识别败血症前兆,Reddit 用户称 AI 救了自己一命

Reddit 用户因 Claude 及时识别败血症征兆而获救,引发对 AI 健康预警价值与边界的讨论。
一名 Reddit 用户深夜出现排尿困难、血尿和意识模糊,向 Claude 描述症状后,Claude 判断可能是尿路感染引发的败血症并强烈建议立即急诊。医生证实,若等到次日早上就医,他很可能已发展为败血症休克。事件展示了大型语言模型在模式识别与紧急症状关联上的潜力,但也暴露其局限:无法体检或检测,判断带有运气成分,不能替代专业诊断。文章由此讨论 AI 健康助手的辅助定位、系统提示的约束作用,以及用户不应因 AI 提醒而延误就医的原则。
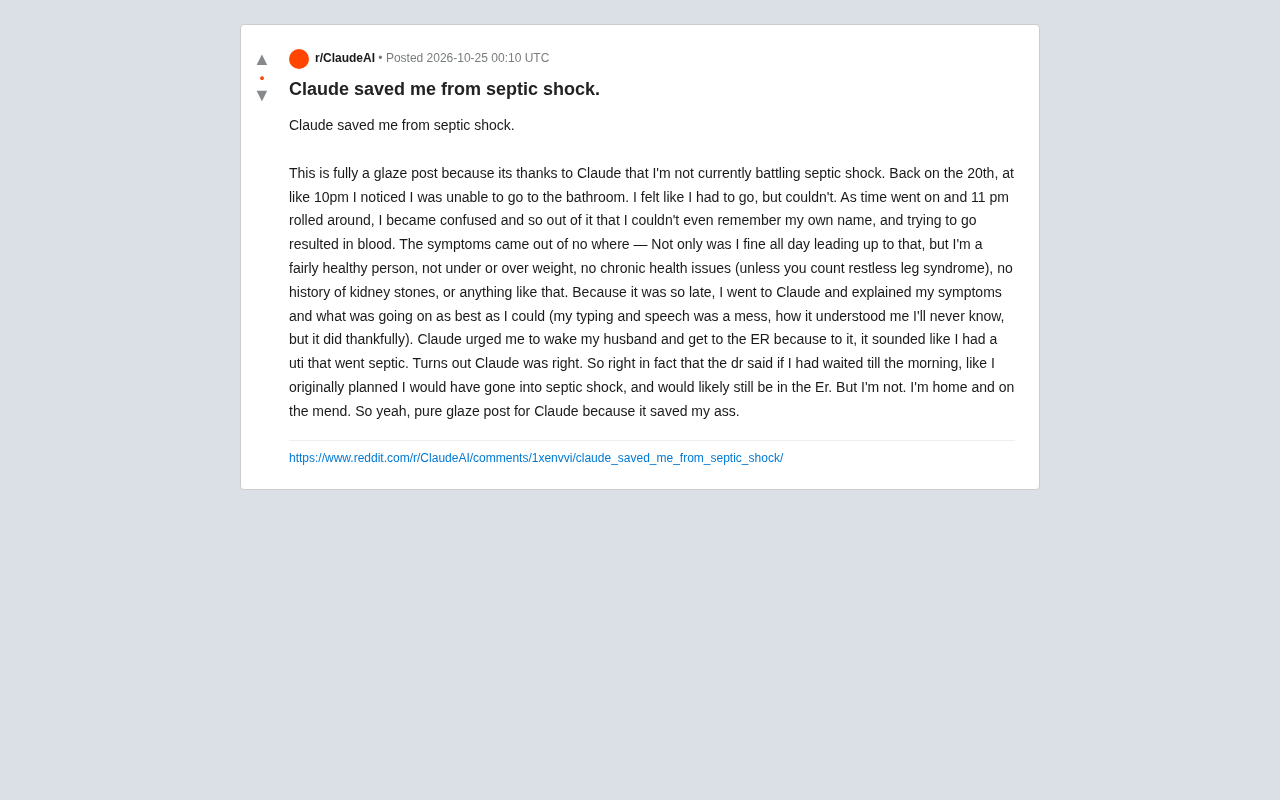
一位 Reddit 用户发帖称,自己因 Claude 的及时提醒而避免了一场可能致命的败血症休克。这则帖子迅速引发热议,也让我们重新审视 AI 在紧急健康场景中的潜在价值与边界。
事件回顾:深夜突发症状,AI 成为第一求助对象
据 Reddit 用户描述,事发当晚 10 点左右,他发现自己无法正常排尿,尽管有强烈的便意。随着时间推移,症状迅速恶化:到 11 点,他变得意识混乱,甚至记不起自己的名字,尝试排尿时还出现了血迹。这些症状来得毫无征兆——他当天白天一切正常,平时身体健康,没有慢性疾病(除了不宁腿综合征),也没有肾结石病史。
由于时间太晚,他选择向 Claude 描述自己的症状。尽管当时他的打字和表达已经混乱不堪,Claude 仍然理解了他的情况,并强烈建议他立即叫醒丈夫前往急诊室,因为 Claude 判断这可能是尿路感染引发的败血症。
医疗验证:医生确认 AI 判断准确
用户听从了 Claude 的建议,前往急诊。医生的诊断证实了 Claude 的判断:如果按照他原计划等到早上再就医,他很可能已经发展为败血症休克,甚至可能仍在急诊室抢救。如今,他已经回家休养,身体正在恢复。
这则帖子在 Reddit 上获得了大量关注,许多用户对 Claude 的准确判断表示惊讶。发帖者本人也直言,这是一篇“纯粹的赞美帖”,因为 Claude 救了他一命。
败血症与败血症休克是理解本事件严重性的关键医学背景。败血症(Sepsis)指机体对感染产生失调的免疫反应,导致危及生命的器官功能障碍;当循环系统崩溃、血压急剧下降时即进展为败血症休克(Septic Shock),死亡率可达 30%–40% 以上,且每延迟一小时使用抗生素,死亡风险就显著上升。尿路感染是常见诱因之一,尤其当细菌侵入血流时。典型警示信号包括意识改变、排尿困难、血尿、呼吸急促和心率加快。本例中“意识混乱、记不起自己名字”是器官灌注不足与全身炎症反应的标志,属于需要立即急诊干预的红色警报,而非可等到次日的轻症。
AI 在健康预警中的潜力与局限
这起事件展示了大型语言模型在识别紧急医疗状况方面的潜力。Claude 能够从混乱的描述中提取关键信息(排尿困难、血尿、意识模糊),并将其与败血症的典型症状关联起来,这体现了 AI 在模式识别和知识整合上的优势。
然而,这并不意味着 AI 可以替代专业医疗诊断。首先,该用户的症状组合本身就具有明确的指向性,AI 的准确判断有一定运气成分。其次,AI 无法进行体格检查或实验室检测,其建议应始终被视为参考而非诊断。更重要的是,在紧急情况下,直接拨打急救电话或前往医院仍然是首选。
大型语言模型(LLM)的模式识别能力来自其对海量文本的统计学习,而非医学推理或体征感知。它可以把“排尿困难+血尿+意识模糊”这类症状组合与训练语料中的败血症描述进行语义匹配,从而给出风险提示;但它无法测量体温、血压、血氧,也无法做尿常规或血培养。因此,LLM 在健康场景中的合理定位是“分诊提示器”而非“诊断工具”:其价值在于缩短用户从症状出现到寻求专业帮助的时间,而不是给出确定性结论。理解这一区别,有助于解释为何同一模型在不同症状描述下可能给出不一致的建议。
行业启示:AI 健康助手需要更严谨的设计
这起案例为 AI 健康助手的设计提供了重要参考。一方面,AI 需要具备识别紧急症状并引导用户寻求专业帮助的能力;另一方面,开发者必须明确 AI 的辅助定位,避免用户过度依赖。目前,包括 Claude 在内的主流模型都在系统提示中强调“不能替代专业医疗建议”,但实际使用中,用户往往会将 AI 视为第一咨询对象。
对于普通用户而言,这则故事提醒我们:在身体出现异常时,及时就医永远是第一原则。AI 可以作为信息辅助工具,但不应成为拖延就医的理由。
系统提示(System Prompt)与安全对齐是当前主流模型约束医疗建议的主要手段。开发者通常会在系统层加入“不提供诊断、不替代医生、紧急情况请拨打急救电话”等指令,并通过强化学习与人工反馈(RLHF)降低模型给出危险建议的概率。但这类约束是概率性的,并不能保证模型在每一种紧急表述下都触发就医提醒。更严谨的设计思路包括:识别高危症状关键词时强制插入固定安全模板、在对话中主动追问持续时间与伴随症状、以及明确区分“信息参考”与“医疗建议”的界面提示。对用户而言,这意味着不应把模型的一次正确判断当作可复制的可靠性保证。
结语
Claude 在这次事件中扮演了关键角色,但它的成功更多是“及时提醒”而非“医疗诊断”。AI 在健康领域的应用前景广阔,但责任边界需要清晰界定。对于科技行业来说,如何在提升 AI 能力的同时确保用户安全,将是一个持续讨论的课题。
相关推荐
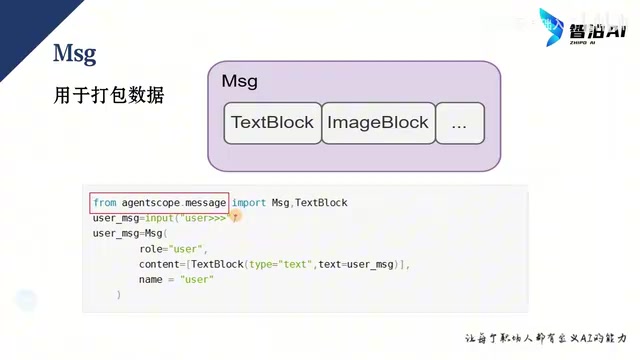
AgentScope 2.0保姆级教程:从零搭建企业级多智能体
基于B站教程详解阿里AgentScope 2.0多智能体框架:Message核心设计、模型与Agent配置、Event流式输出机制,附两个可运行对话Agent实例代码解析,适合从零入门企业级智能体开发。
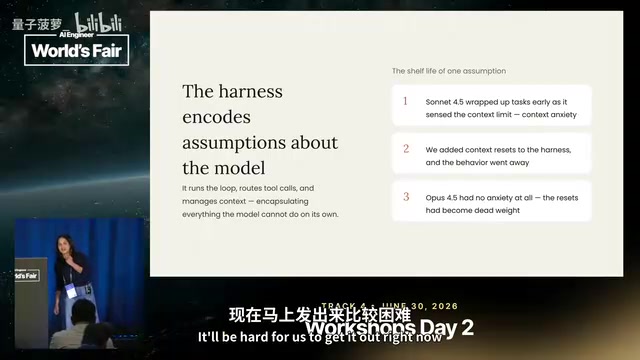
Anthropic解耦Claude智能体大脑与双手的架构演进
Anthropic在AI Engineer大会复盘Claude Managed Agents架构演进:从单容器「宠物」架构转向会话日志、Harness大脑与沙箱双手彻底解耦,首个token延迟降低约90%,凭证不进沙箱以抵御提示注入。
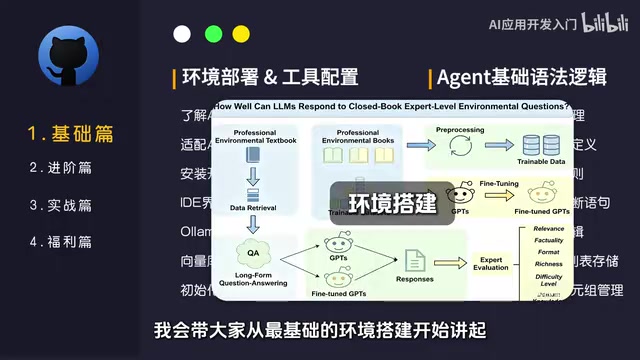
B站748集AI Agent开发教程:从入门到企业级实战全解析
解析B站748集AI Agent开发教程的四阶段框架:基础篇讲大模型原理与API调用,进阶篇覆盖RAG、Tool Use、记忆管理与多智能体协作,实战篇落地智能客服、办公自动化等项目,并给出学习路径与避坑建议。