Claude Sonnet 4.6定价全解析:性能逼近Opus,成本仅六成

Claude Sonnet 4.6 维持 $3/$15 定价,性能逼近 Opus,缓存与批处理可再降本 50-90%。
Claude Sonnet 4.6 延续 Sonnet 系列的性价比路线,标准定价为输入 $3/百万 token、输出 $15/百万 token,与上一代持平,但性能已逼近 Opus 4.6,成本仅为其六成。文章拆解了完整的计费体系:提示缓存读取低至 $0.30/MTok,静态提示词场景可降本约 90%;Batch API 提供五折优惠,且可与长上下文费率叠加,组合价回到标准档水平;长上下文 200K 阈值按总输入 token(含缓存读写)计算,越线后整单按 $6/$22.50 计费。此外,网络搜索、代码执行等工具调用有独立计费,需单独核算。文章建议上线前用真实请求验证 token 比例和缓存命中率,以建立可靠的预算基线。
Claude Sonnet 4.6 的定价策略延续了 Sonnet 系列的性价比路线:输入 $3/百万 token,输出 $15/百万 token,与上一代 Sonnet 4.5 完全持平。但真正值得关注的是,它在多项基准测试中已经逼近甚至追平 Opus 级别的表现,而成本仅为 Opus 4.5 的 60%。对于正在做模型选型的团队来说,这组数字背后藏着一套需要仔细拆解的计费逻辑。
核心价格:标准、缓存与批处理
标准 API 调用按 $3/MTok 输入、$15/MTok 输出来计费。一次典型的 500 token 输入、300 token 输出的请求,成本约为 $0.0060——确实不到一美分。
但真正拉开成本差距的是两个杠杆:提示缓存和 Batch API。
| 计费档位 | 输入 | 输出 |
|---|---|---|
| 标准 | $3.00/MTok | $15.00/MTok |
| Batch API | $1.50/MTok | $7.50/MTok |
| 缓存写入(5分钟) | $3.75/MTok | — |
| 缓存写入(1小时) | $6.00/MTok | — |
| 缓存读取 | $0.30/MTok | — |
| 长上下文 >200K(标准) | $6.00/MTok | $22.50/MTok |
| 长上下文 >200K(Batch) | $3.00/MTok | $11.25/MTok |
缓存读取的价格是标准输入的十分之一,这意味着静态系统提示词的重复调用成本可以被压到极低。原文给出了一个直观的算例:10,000 token 的系统提示词,每天处理 1,000 次请求,不做缓存每天 $30,做缓存后每天约 $3.04,降幅约 90%。
提示缓存:最被低估的成本杠杆
缓存的定价结构值得单独拆开看。写入缓存要加价——5 分钟缓存是基础输入价的 1.25 倍($3.75/MTok),1 小时缓存是 2 倍($6.00/MTok)。但读取只要 $0.30/MTok。这套设计的经济含义很明确:写入成本是一次性的,读取优惠是持续性的,调用频次越高,缓存的价值越大。
选择哪种缓存时长取决于调用模式。高频、突发性的短会话适合 5 分钟缓存;后台处理管线、间隔较长的批处理任务、智能体循环则更适合 1 小时缓存。在代码层面,给静态内容打上 cache_control 标记后,从响应的 usage 对象里可以分别读到 cache_creation_input_tokens 和 cache_read_input_tokens,据此验证缓存是否命中。
这里有一个容易被忽略的细节:缓存写入和读取的 token 都会计入长上下文的 200K 阈值判断。也就是说,即使主体内容走了缓存,只要总输入 token 超过 200K,整个请求仍会按长上下文费率计费。
提示缓存(Prompt Caching) 是一种让模型在多次请求间复用相同前缀内容的机制。它的工作原理是:当请求中某段前缀(如系统提示词、few-shot 示例、长文档)被打上 cache_control 标记后,服务端会将其计算出的 KV 缓存(注意力机制中的键值状态)持久化存储;后续请求若前缀完全一致,可直接读取缓存,跳过重复的预填充计算。这既省去了重复计算的时间(降低延迟),也大幅减少了按输入 token 计费的成本。缓存有生存期,过期后需重新写入,因此对高频复用的静态内容收益最大。
Batch API 是 Anthropic 提供的异步批处理接口,允许将大量请求打包提交,在 24 小时内(通常更快)返回结果,以换取统一的五折价格优惠。它适合对延迟不敏感的任务,如离线分类、内容审核、大规模数据富化。由于批处理请求不占用实时推理资源,服务商可将计算调度到空闲时段,从而让利给用户。
Batch API 与长上下文:两套折扣的叠加规则
Batch API 提供统一的五折优惠,代价是异步处理——结果在 24 小时内返回,通常远快于此。内容审核、大规模文档分类、夜间数据富化这类对延迟不敏感的场景,用 Batch API 能直接砍掉一半成本。原文的算例是:100 万份文档,每份 500 输入 token 加 100 输出 token,Batch 模式下总成本 $1,500,折合每份文档约 $0.0015。
长上下文的规则则需要多留意一层。通过 context-1m-2025-08-07 beta 头开启 1M 上下文窗口后,输入超过 200K token 的请求,输入涨到 $6/MTok,输出涨到 $22.50/MTok。关键在于,这个 200K 阈值看的是总输入 token,包含标准输入、缓存写入和缓存读取三部分之和。一旦越线,整个请求的所有 token 都按高价计费。
好消息是 Batch API 的五折可以和长上下文叠加:长上下文加 Batch 的组合价是输入 $3/MTok、输出 $11.25/MTok,恰好回到标准档位的水平。批量处理大文档时,这是控制成本的关键手段。
长上下文(Long Context) 指模型单次请求可处理的 token 窗口大小。Claude Sonnet 4.6 默认支持 200K token 上下文,通过 context-1m-2025-08-07 beta 头可扩展至 1M token。但超过 200K 的部分需要额外的内存与计算资源,因此计费采用阶梯定价:总输入 token 超过 200K 时,整个请求(而非仅超出部分)都按更高的长上下文费率计费。这里的“总输入 token”包含标准输入、缓存写入和缓存读取三部分之和,是容易被忽略的计费细节。
Batch API 与长上下文的叠加 是成本优化的关键组合。Batch API 的五折优惠适用于所有请求,包括长上下文请求,因此长上下文加批处理的组合价可降至输入 $3/MTok、输出 $11.25/MTok,恰好回到标准档水平。这意味着批量处理大文档(如合同分析、长报告摘要)时,可以同时享受异步折扣和长上下文支持,而无需支付溢价。
工具调用有额外账单
token 费用之外,部分工具自带独立计费。网络搜索按 $10/千次收费,每次搜索调用计一次,无论返回多少条结果,搜索报错不计费。网络抓取工具本身免费,只按进入对话的内容计 token。代码执行工具在与网络搜索或抓取捆绑使用时免费;独立使用时每组织每月有 1,550 小时免费额度,超出部分每容器每小时 $0.05,最小计费单位为 5 分钟。
计算机使用功能会带来固定 token 开销:系统提示词增加 466–499 token,每个工具定义增加 735 token。这些数字单看很小——735 token 按 $3/MTok 算只有 $0.0022——但截图 token 才是大头,每张截图按分辨率不同大约消耗 2,000–5,000 token,多轮会话中会快速累积。
横向对比:Sonnet 4.6 到底值不值
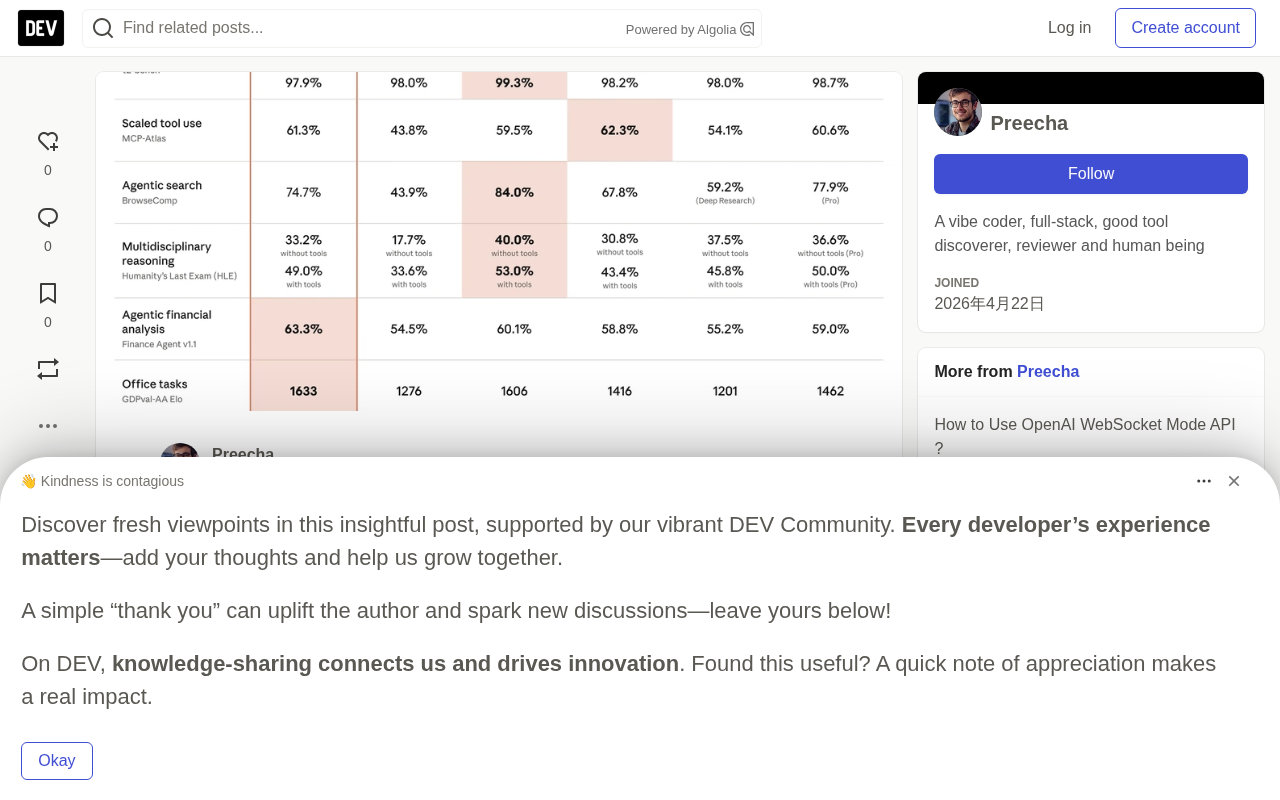
把 Sonnet 4.6 放进整个 Claude 产品线里看,定位就很清晰了。它的输入输出价格是 Opus 4.6 的 60%,但 SWE-bench Verified 得分 79.6%,与 Opus 4.6 的约 80.8% 差距不到 1.5 个百分点;OSWorld 计算机使用测试中,两者分别是 72.5% 和 72.7%,几乎打平。在用户偏好对比中,早期测试者在 59% 的正面对决里更青睐 Sonnet 4.6 而非 Opus 4.5。
| 模型 | 输入 | 输出 | 缓存读取 |
|---|---|---|---|
| Claude Sonnet 4.6 | $3.00 | $15.00 | $0.30 |
| Claude Haiku 4.5 | $1.00 | $5.00 | $0.10 |
| Claude Opus 4.6 | $5.00 | $25.00 | $0.50 |
| Claude Opus 4.1 | $15.00 | $75.00 | $1.50 |
Opus 4.6 的溢价只在两种情况下说得通:需要 128K 的最大输出 token(Sonnet 4.6 是 64K),或者面对需要极限推理能力的新颖任务。绝大多数编码、分析、文档处理和智能体工作流,Sonnet 4.6 都能以六成价格交付接近 Opus 的结果。
与 Haiku 4.5 的关系则是分工而非替代。Haiku 4.5 适合路由、分类、简单提取这类高频低复杂度任务;Sonnet 4.6 承接复杂代码生成、多步智能体和长推理链。原文提到,这种混合路由的模式通常比全部用 Sonnet 4.6 便宜 60–80%。
SWE-bench Verified 是评估大模型软件工程能力的权威基准,包含 500 个来自真实开源项目的 GitHub issue,要求模型生成能通过测试的代码补丁。它比原始 SWE-bench 更严格,经过人工验证确保问题描述清晰、测试可靠。79.6% 的得分意味着模型能独立解决近八成真实代码修复任务,是衡量编码智能体实用性的关键指标。
OSWorld 是评估计算机使用(Computer Use)能力的基准,模拟真实操作系统环境(如虚拟机中的浏览器、办公软件),要求智能体通过截图和鼠标键盘操作完成多步任务。72.5% 的得分反映模型在真实 GUI 环境中的操作准确率,与 Opus 4.6 的 72.7% 几乎持平,说明 Sonnet 4.6 在智能体工作流中已具备接近旗舰模型的可靠性。
上线前先算清楚账
定价表看懂了,不代表预算算得准。实际成本取决于输入输出的 token 比例、缓存命中率和是否走批处理,这些只有跑真实请求才能验证。原文建议在写生产代码之前,先用 API 调试工具发起试调用,从响应体的 usage 对象里读出 input_tokens、cache_creation_input_tokens、cache_read_input_tokens 和 output_tokens 四个数值,逐项乘以对应费率。
一个实际例子:某次请求输入 523 token、缓存写入 5,000 token、输出 312 token,首调用成本约 $0.025;后续缓存命中后降到约 $0.006。把这组数字乘以预估的调用量,得到的才是可用的预算基线,而不是拍脑袋的估算。
相关推荐

2026年AI编程工具横评:Claude、ChatGPT、Gemini谁最强?
2026年五款主流AI编程工具横评:Claude Code、ChatGPT Codex、Gemini、DeepSeek和GitHub Copilot在真实项目、定价与代码质量上的全面对比,帮你决定每月20美元该花给谁。

ChatGPT Codex克隆任意软件?实测风险与真相
YouTube短视频宣称用ChatGPT Codex或Claude Code即可克隆Adobe、Excel、Figma等软件并终身免费使用。本文拆解其技术可行性、法律风险与私信引流套路,说明AI编程工具真正适合的用法。

Kilo Code免费安装但API收费:成本估算与配置指南
Kilo Code 开源 AI 编程代理安装免费,但接入的 AI 模型按 token 收费。本文详解 VS Code 扩展与 CLI 配置步骤,并用假设用量演示 API 成本估算方法,对比按量付费与订阅制的选择逻辑。