Claude Sonnet 5.5 成本实测:仅为 Opus 5.5 的四分之一?
实测显示换用 Sonnet 比装插件更能省 token,轮次与模型选择才是成本主杠杆。
文章记录了一位创作者用同一个 45 行待办应用任务,系统测试不同 Claude Code 配置的成本差异。基线 Opus 5.5 + Medium 平均约 44 美分,但两次运行波动达 16 美分,说明单次结果不可靠。日志显示约 94% 的 token 花在 agent 反复重读相同文件上,写代码仅占 2%,因此减少轮次才是省钱核心。换用 Sonnet 5.5 仅花 11 美分且通过全部检查;低努力等级省钱但引入自动检查漏掉的视觉问题,高努力等级多花 39% 却无收益;流行的极简提示插件实测仅省约 12%,被噪声淹没;分步新开会话反而让成本翻倍。结论是最有效的策略朴素可靠:明确任务换 Sonnet、保持中低努力、一次给全需求、留在同一会话。
引言:省 token 的技巧满天飞,但数字在哪里?
最近关于如何节省 Claude 使用额度的建议铺天盖地——从 Anthropic 官方发布的模型选择指南,到各种“让你再也不会撞上 token 上限”的视频。但大多数建议要么不给具体数字,要么只基于单次运行的经验。于是,一位 YouTube 创作者决定自己动手,用同一个真实任务测试不同配置的成本差异。
测试任务很普通:一个 45 行的 JavaScript 待办事项应用,要求支持截止日期、逾期任务标红,以及一个能记住选择状态的逾期过滤器。基线配置是 Claude Code 的默认模型和努力等级——Opus 5.5 配合 Medium 档位,这也是 Anthropic 官方指南建议大多数工作的起点。
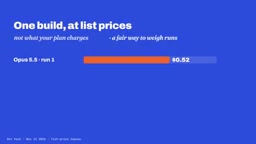
按 Anthropic 的标价计算,这次构建消耗了 52 美分的 token。但同一任务再跑一次只花了 36 美分,所以默认配置的平均成本约为 44 美分。这个波动本身就是一个重要信号:单次运行的结果并不可靠。
成本都花在哪了?重读文件才是大头
分析第一次运行的日志发现,约 94% 的 token 消耗在 agent 反复重读对话中的相同文件上。真正写出的代码——也就是页面顶部的产物——只占约 2%,尽管写操作的单 token 成本最高。重读虽然因为缓存而单价较低,但每一轮都会重新执行一遍,并多写一点内容。
所以真正推高总成本的是轮次数量。那些真正有效的省钱技巧,本质上都是在减少轮次。这也解释了为什么单纯压缩输出文字收效甚微——因为大部分钱花在了输入侧的重复读取上。
Agent 的“重读”机制与缓存定价
Agent 类工具(如 Claude Code)每一轮交互都会把当前对话历史连同工具读取的文件内容重新发送给模型。为了降低这种重复输入的成本,Anthropic 提供了提示缓存(prompt caching):重复出现的前缀部分按缓存读取价计费,通常远低于首次输入价。但缓存只降低单价,不减少发送量——轮次越多,被重复发送的 token 总量仍线性增长。这就是为什么文章观察到重读占了 94% 的消耗:单价便宜,次数太多。理解这一点很关键,它意味着优化方向应是“少发几轮”(缩短任务、减少无效工具调用),而非单纯压缩单轮文本。
换模型:最大的单项节省
第一个测试的变量是模型。Sonnet 5.5 的每 token 价格是 Opus 的一半,而且它用更少的轮次就完成了任务。同一个功能只花了 11 美分,约为默认配置的四分之一,并且通过了全部九项检查,成品看起来也基本一样。
Anthropic 的成本页面提到 Sonnet 能很好地处理大多数编码任务且比 Opus 便宜,其模型视频则更谨慎一些,建议将 Sonnet 用于范围明确的任务,强调其每 token 价格减半。但两者都没有说明在真实任务上到底能省多少——而在这个测试中,大约是用一次构建的价格完成四次。
如果只能改一件事,换模型是回报最高的选择。
Opus 与 Sonnet 的定位差异
在 Anthropic 的 Claude 模型家族中,Opus 是能力最强、单价最高的旗舰档,Sonnet 定位为能力与成本平衡的中间档,Haiku 则是速度最快、最便宜的小模型。三者每百万 token 的输入/输出价格通常呈倍数差距,且 Sonnet 往往在“范围明确、规格清晰”的编码任务上已足够可靠。这解释了测试结果:同一任务 Sonnet 不仅单价减半,还用更少轮次完成,形成双重节省。代价是面对高度模糊、需要大量探索性推理的任务时,Sonnet 可能不如 Opus 稳健——因此“换模型”并非无条件适用,而是取决于任务的可描述程度。
努力等级:低档省钱但有代价,高档多花钱没效果
努力等级是第二个变量。根据 Anthropic 公布的某个公开编码基准数据,低努力等级的成本约为高等级的三分之一,得分低约八分。在实际测试中,低档确实省钱——不到默认配置的一半,对于能清晰描述的小任务值得一用。
但这也是唯一一次结果看起来更差的运行:标题漂移到了每行的中间位置,而九项自动检查全都没发现这个问题。只有人眼才能看出来。
反方向调整则完全不划算:高努力等级花了 61 美分,比默认高出 39%,而应用看起来一模一样。在这个规模的任务上,额外的“思考”没有带来任何可见的收益。Claude Code 自己的用量界面甚至会建议从 Max 降到 High,另一行则提示精简指令文件——后者在测试中也被证明有效。
努力等级(Effort Level)是什么
努力等级是 Claude Code 等工具暴露给用户的推理预算开关,通常分为 Low、Medium、High、Max 等档位。它并不改变模型本身,而是控制模型在回答前进行内部推理(扩展思考)的深度与工具调用的积极程度。高档位会让模型花更多 token 反复推敲、尝试更多方案,因此单价与轮次都可能上升;低档位则更快更省,但更容易在细节上“抄近路”。文章中的现象——低档省钱却出现标题错位、高档多花 39% 却无可见改进——正是这一机制的典型表现:收益取决于任务是否真的需要深度推理,而简单 CRUD 类任务往往不需要。
第三方插件与“极简提示”:效果被夸大了
社区里流行各种附加插件,最热门的一个在 GitHub 上有约 12 万星标,声称通过让 Claude 像穴居人一样说话来削减 65% 的 token。相关视频和帖子更是宣称能省 90% 甚至一半。
测试者没有安装任何人的代码,而是尝试了其背后的思路:在项目的指令文件中加一行,要求 Claude 保持简洁。两次运行平均便宜了约 12%。听起来不错,但默认配置本身在两次相同运行之间就波动了三分之一,误差棒相互重叠。
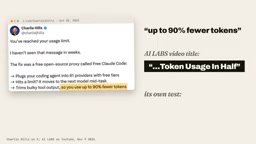
独立核查也大多指向同一结论。科技新闻网站 Implicator 汇总的测试显示,该类工具实际削减的输出约为 20%,而非 65%。一家销售竞品的公司做的基准测试确实发现了 19% 的账单降低。而一篇分析了数千次 Claude Code 运行的研究论文发现,压缩工具反馈给 Claude 的内容反而让账单高出约 7%,因为那里的主要成本在缓存上。
换句话说,压缩文字最多只是小节省,在本次测试中甚至被噪声淹没。
“穴居人式”提示与输出压缩的原理与局限
这类工具的思路是修改系统提示或指令文件,要求模型用极简、省略冠词和连接词的风格作答,从而减少输出 token。问题在于,如前文成本分析所示,输出通常只占总消耗的极小比例,大部分开销在输入侧的重复读取与轮次上。因此即使输出被压缩 60%,总账单的降幅也远小于宣传数字;而当模型因指令变短而理解偏差、需要更多轮澄清时,节省还可能被抵消甚至反转。独立测试普遍显示实际降幅在 20% 上下,且被运行间的自然波动掩盖,这与文章结论一致。
新开会话:最反直觉的结论
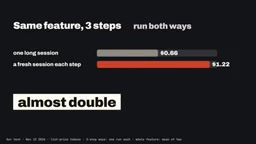
“每次新任务都开新会话”是流传最广的建议之一。Anthropic 的文档确实说清除会话不花钱。但测试者把同一个功能拆成三步,分别用两种方式运行:
- 一个长会话完成三步:66 美分
- 每一步都开新会话:1.22 美元,几乎翻倍
长会话版本甚至也比一次性要求完整功能更贵。原因在于测试者自己的指令文件——被意外读取——要求 Claude 用截图检查工作,而测试环境阻止了截图,Opus 的回复甚至说它无法运行应用、让用户自己试。每个新会话都重新尝试这些被阻止的检查,最后一步仅添加一个过滤器就花了 33 轮。
真正有效的策略:无聊但可靠
综合所有测试,最省钱的组合其实相当朴素:
- 能一句话描述清楚的任务,换用 Sonnet——这是回报最高的单项改动。
- 努力等级留在 Medium 或 Low,前提是你自己会检查屏幕。
- 一次性要求完整功能,而不是拆成多步。
- 保持在一个会话里,因为 Anthropic 文档说清除会话是给不相关的工作用的。
测试者最后表示,在所有构建出的应用中,那个 11 美分的 Sonnet 版本是他愿意留下的。如果明天就要撞上额度上限,他会先换模型,而不是先装插件。
额度池本身也在缩水
还有一个容易被忽略的变量:额度上限本身并不稳定。据测试者引用,Anthropic 曾宣布将 Claude Code 的每周限额提高 25%,但同一天一项临时的 50% 提升结束,因此官方确认的读者注释将其描述为 17% 的削减。即使这些习惯能帮你省下一些,池子本身也可能缩小。
这意味着省钱策略的价值不仅在于绝对值,更在于它给了你应对规则变化的缓冲空间。
结语
这项测试的核心启示是:在 token 成本这件事上,最大的杠杆来自架构选择(用哪个模型、用多少轮次),而不是安装各种声称能“砍半”的插件。单次运行的数据波动极大,任何没有多次重复的建议都值得怀疑。Sonnet 5.5 在这个真实任务上确实做到了约为 Opus 默认配置四分之一的成本,且质量没有肉眼可见的下降——这可能是目前最可靠的省钱手段。
相关推荐
多模态图像编辑的安全盲区:文本敏感、视觉失明
EditSafetyBench基准测试Gemini、GPT、Qwen等图像编辑系统,发现文本-视觉安全错配:系统对不安全提示拒绝率高,对不安全图像却大幅放行,呼吁多模态联合安全护栏。
GLiDE:从推理教师蒸馏的快速校准决策模型
GLiDE 是一系列从推理教师蒸馏而来的决策模型,参数覆盖 0.4B 到 27B,通过移除因果掩码和软目标蒸馏实现单次前向的快速校准决策,27B 模型隐藏集得分 71.52,校准误差 2.0%,延迟 92.9ms。
用Claude Code几分钟搭建专业网站:五步实战指南
详解如何用Claude Code在几分钟内搭建专业网站:从规划提示词、精准迭代、MCP接入图片生成,到参考图重做设计与一键发布上线的完整五步流程。