Claude Sonnet 5.5 与 Fable 5.2 报错事件复盘
Claude 多模型短时错误率升高,13 分钟修复,但披露信息有限。
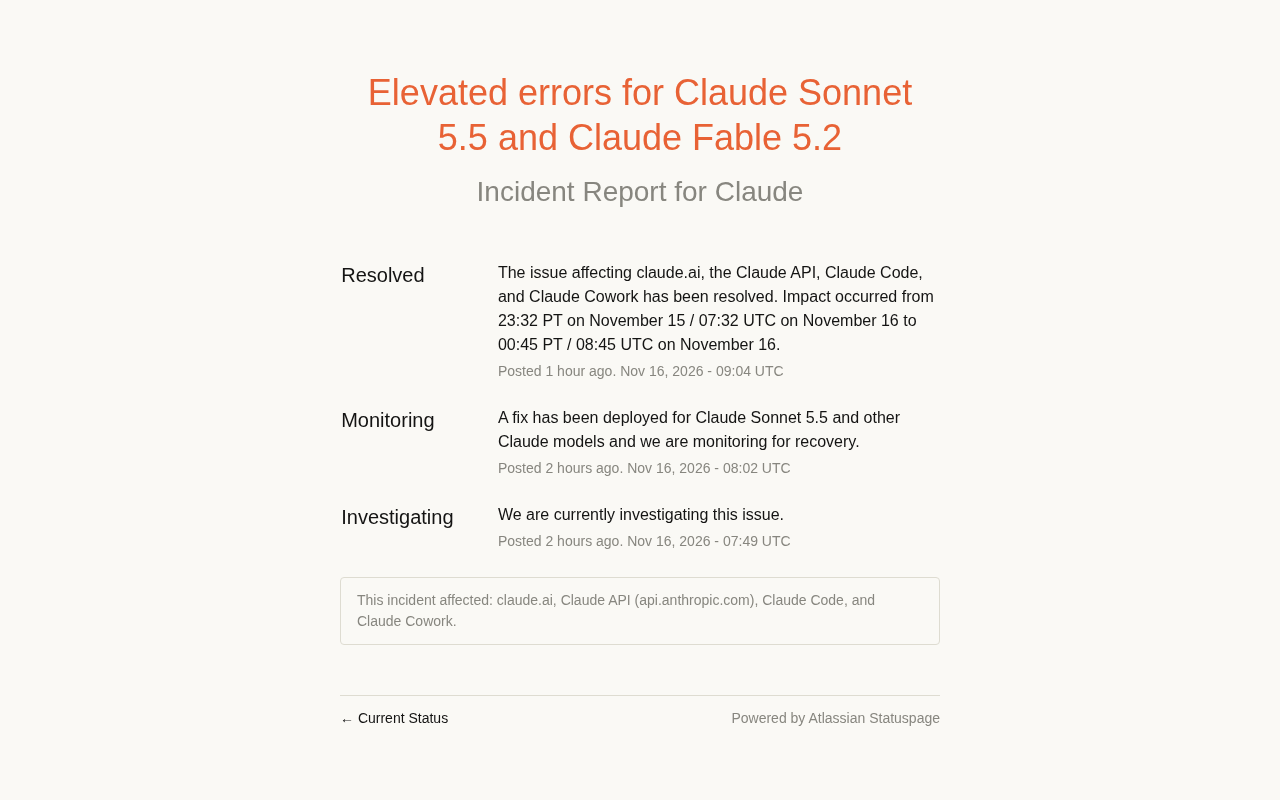
11 月 16 日 UTC 07:49,Anthropic 状态页报告 Claude Sonnet 5.5 与 Claude Fable 5.2 等模型错误率升高,08:02 即部署修复并进入 Monitoring,全程约 13 分钟。官方措辞表明故障波及多个 Claude 模型而非单一模型,但未披露根因、影响范围、错误码与受影响请求比例,也未出现 Resolved 更新,企业用户事后复盘信息不足。对开发者而言,此类短时故障通常表现为请求失败、超时或 5xx 响应,难以精确定位失败请求是否源于本次事件。文章建议订阅状态页 RSS、对幂等请求配置指数退避重试、准备多模型降级预案并记录请求 ID,以此检视自身对第三方 AI 服务的容错设计。
事件概述
根据 Anthropic 官方状态页的 RSS 推送,Claude Sonnet 5.5 和 Claude Fable 5.2 等模型在 UTC 时间 11 月 16 日 07:49 出现错误率升高的情况。官方于 08:02 更新状态为“Monitoring”,表示修复已部署并正在监控恢复情况。整个过程从“Investigating”到“Monitoring”间隔约 13 分钟,属于短时故障。
故障时间线与处理动作
状态页记录了两个关键节点:
- 07:49 UTC — Investigating:官方确认正在调查该问题,但未披露具体错误类型或影响范围。
- 08:02 UTC — Monitoring:修复已部署,进入监控恢复阶段。
从措辞看,“A fix has been deployed for Claude Sonnet 5.5 and other Claude models”说明此次故障并非单一模型问题,而是波及多个 Claude 模型。Sonnet 5.5 被点名,Fable 5.2 出现在标题中,暗示两者可能是受影响最直接或用户反馈最集中的模型。
对开发者的实际影响
对于依赖 Claude API 构建应用的开发者,这类短时错误率升高通常表现为请求失败、超时或返回 5xx 状态码。由于官方未公布具体错误码和受影响区域,开发者难以在事后精确定位自己的失败请求是否由本次事件引起。
值得关注的是,状态页只提供了“错误率升高”(Elevated errors)这一笼统描述。对于生产环境中的团队,这意味着需要依赖自身的监控和重试机制来判断影响面。建议在集成 Claude API 时配置指数退避重试,并对状态页 RSS 设置订阅提醒。
指数退避重试(Exponential Backoff with Jitter) 是指客户端在请求失败后,以指数级增长的间隔(如 1s、2s、4s、8s……)重新尝试,并叠加随机抖动(jitter)以避免大量客户端在同一时刻集中重试形成“重试风暴”。对调用 Claude 这类云端推理 API 的开发者而言,短时错误率升高往往在数分钟内自愈,指数退避能在不加重服务端压力的前提下平滑度过故障窗口。实践中还需注意:只对幂等请求(如 GET 或带幂等键的 POST)重试;设置最大重试次数与总超时上限(例如 3 次、30 秒);对 4xx 类客户端错误(如 401、429 中的配额超限)采用不同策略;并区分 5xx 服务端错误与网络超时。
5xx 状态码 属于 HTTP 语义中的服务端错误类别(500 Internal Server Error、502 Bad Gateway、503 Service Unavailable、504 Gateway Timeout 等),表示请求已到达服务端但处理失败或上游不可用,与 4xx 的客户端错误相对。文中“请求失败、超时或返回 5xx”正对应此类现象:模型服务过载或后端依赖异常时,网关通常返回 503/504。由于官方未公布具体错误码,开发者必须依赖自身日志中的状态码分布、请求 ID 与时间戳来反推失败是否落在本次故障窗口内。
状态页沟通的透明度问题
本次事件的信息披露相当简略:没有说明根因、没有给出受影响请求的百分比、也没有区分不同模型的恢复进度。对于企业用户而言,这种颗粒度可能不足以支撑事后复盘。
从积极角度看,13 分钟内完成从调查到部署修复的转变,响应速度值得肯定。但“Monitoring”状态本身不包含恢复确认,读者无法从该条更新中判断服务是否已完全恢复。后续是否还有“Resolved”更新,原始素材未体现。
状态页(Status Page)与 RSS 订阅 是 SaaS 厂商对外披露服务健康度的标准渠道,通常包含组件级状态(Operational / Degraded Performance / Partial Outage / Major Outage / Under Maintenance)与事件时间线。事件生命周期一般遵循 Investigating → Identified → Monitoring → Resolved 四阶段:Investigating 表示已确认异常并在排查;Identified 表示已定位根因;Monitoring 表示修复已部署、正在观察恢复;Resolved 表示事件关闭。本文事件跳过了 Identified 阶段直接进入 Monitoring,且未出现 Resolved,这是评估信息披露完整度时值得留意的细节。通过 RSS/Atom 订阅状态页,值班系统可在数秒内收到推送并触发告警路由,比人工轮询更可靠。
给团队的操作建议
- 订阅状态页 RSS:比手动刷新更快获知故障,尤其适合值班场景。
- 客户端重试策略:对幂等请求启用重试,避免短时故障放大为业务事故。
- 多模型降级预案:本次事件波及多个 Claude 模型,说明单模型依赖存在风险,可考虑配置备用模型或备用供应商。
- 记录请求 ID:便于在官方后续公布细节时进行关联分析。
小结
这是一次典型的短时模型服务故障,官方响应及时但信息披露有限。对于开发者,重点不在于事件本身,而在于借此检视自身对第三方 AI 服务的容错设计是否到位。
相关推荐
Gemini 4双模型曝光,Genie 4世界模型上线,AI研发自我加速
11月19日AI晚报汇总:DeepMind Gemini 4 Sodium传闻曝光,Cursor上线Gemini 4 Neon拿下CursorBench 4.1 63.7%;Genie 4世界模型上线支持实时编辑与原声音频;WorkBuddy接入GPT-6.2系列;OpenAI披露AI芯片设计提效与RSI研究指标。
HY Roundtable:本地开源多智能体圆桌,让多个大模型盲评互怼审论文
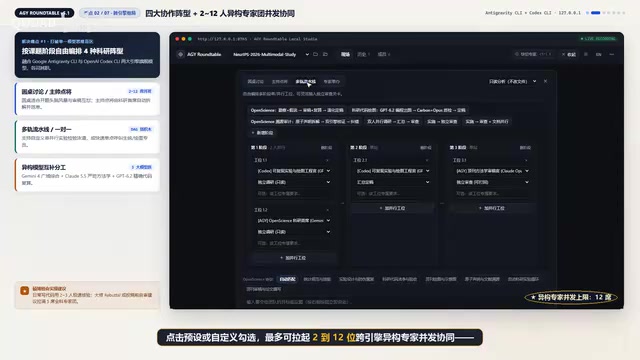
HY Roundtable 是一款本地开源多智能体圆桌工具,把 Gemini 4、Claude Opus 5.5 与 GPT 6.2 请进本地研讨室,通过盲评互怼、交叉质询与代码复算,在投稿前揪出论文硬伤,并内置 Open Science 协议校验统计与配图。
GPT 6.2、Fable 5.2、Gemini 4 实测:一张图生成游戏UI谁最强
B站UP主实测GPT 6.2、Fable 5.2、Gemini 4用一张游戏原图生成完整UI:功能都能跑通,但设计还原度和交互质感差距明显。Fable 5.2表现力最佳却出现死循环事故,GPT 6.2均衡但图标跑偏,Gemini 4观感廉价。附LGUI Agent工作流与引擎导出方案解析。