Claude Sonnet 5.5即将发布:性能直追Opus,OpenAI神秘智能体"O"预热
Sonnet 5.5灰度曝光剑指GPT-6,OpenAI与MiniMax同期动作,AI编程与智能体竞争白热化。
Anthropic的Claude Sonnet 5.5已在Claude Code中进行灰度测试,爆料显示其性能可对标GPT-6,同时定价低于Opus 5.5,延续了Sonnet系列"高性价比"的产品策略,预计美东时间周二下午正式发布。与此同时,OpenAI放出代号"O"的常驻型AI助手预告,将在29号开发者大会亮相,指向从"问答式"向"任务执行式"智能体的产品转型。国内方面,MiniMax发布主打快速Bug修复的轻量模型M3.1 Flash Preview。三方密集动作表明,当前AI厂商的竞争重心正加速向AI编程辅助与智能体两大方向集中,开发者面临更丰富选择的同时,也需要根据成本与场景做出更精细的工具取舍。
Claude Sonnet 5.5灰度测试曝光
据B站UP主EverAI爆料,Anthropic的新模型Claude Sonnet 5.5目前正在Claude Code中进行灰度测试,网友发现其身影后引发广泛讨论。消息称,该模型大概率将在美国时间周二下午2点正式发布。
从流出的测试信息看,Sonnet 5.5的定位相当激进:测试用户透露其性能已经能够与GPT-6等旗舰模型正面较量,同时在价格上比Opus 5.5便宜不少。这种"性能向上对齐、价格向下打"的策略,延续了Anthropic在Sonnet系列上一贯的产品思路——用更低的成本提供接近顶级模型的能力,覆盖高频的日常开发与生产场景。
需要提醒的是,以上信息目前仍属于爆料与灰度测试阶段,模型的具体命名、发布时间和实际性能均以官方公布为准。
性能对比:直追Opus,剑指GPT-6
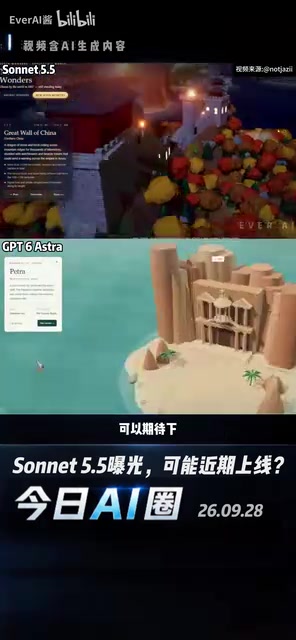
爆料中最受关注的一点,是Sonnet 5.5在相同提示词下与竞品的直接对比。测试者展示了它生成3D交互应用的效果,并与GPT-6等模型的表现进行了对照,画面质量与交互完成度都被认为值得期待。
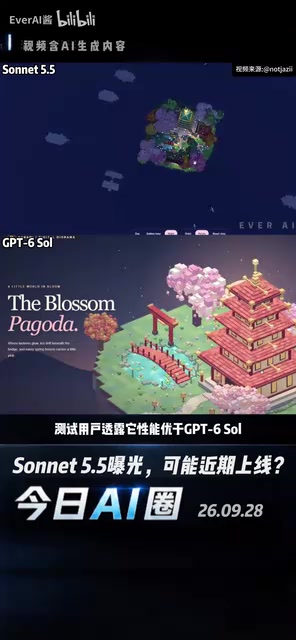
如果爆料属实,这意味着Sonnet 5.5可能在保持较低定价的前提下,把能力推到接近Opus 5.5的水平。对于以代码生成、Agent工作流为主的开发者来说,这样的性价比组合极具吸引力——毕竟在实际项目中,模型调用成本往往是决定能否大规模落地的关键变量。
不过,单一来源的对比测试容易受到提示词选择、任务类型的影响,最终能否"打赢GPT-6"还需要更多独立评测来交叉验证。在官方基准数据公布前,理性看待这些早期对比结论更为稳妥。
OpenAI神秘智能体"O"预热开发者大会
另一边,OpenAI同样动作频频。据消息人士透露,OpenAI正在筹备一款常驻型AI助手,代号为"O"。另一边,OpenAI官方账号放出了一张"O"形态的角色海报进行预热,为29号的开发者大会造势。
从"常驻AI助手"这一定位推测,"O"很可能不是一个单纯的对话模型,而是能够长期驻留、主动执行任务的智能体(Agent)形态产品。这也符合当前行业从"问答式AI"向"任务执行式AI"演进的整体趋势。
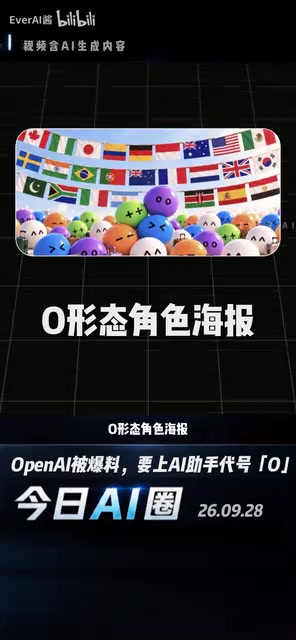
如果OpenAI在开发者大会上正式推出这一智能体,加上Anthropic的Sonnet 5.5几乎同期发布,两大厂商在Agent与代码能力上的正面竞争将进一步升温。
「常驻型AI助手」与传统聊天机器人的核心区别在于持久性与自主性。传统对话模型每次会话结束后状态清零,需要用户主动发起下一轮交互;而常驻型智能体(Persistent Agent)可以维持跨会话的记忆与上下文,在后台持续监听或定时触发任务,无需用户每次手动召唤。典型能力包括:自动监控邮件并按规则回复、定期汇总信息推送、在代码仓库发生变更时自动触发审查流程等。这种形态对操作系统级权限(文件读写、网络访问、应用调用)的依赖程度远高于普通聊天模型,因此也带来更复杂的安全与隐私挑战。目前微软Copilot、Google Gemini的部分功能已在探索类似路径,若OpenAI的"O"在开发者大会上落地,将是行业在「主动式AI」方向上的一次重要产品验证。
MiniMax发布M3.1 Flash Preview
国内方面,MiniMax放出了新的文本模型M3.1 Flash Preview,定位为日常开发场景。
从产品命名中的"Flash"不难看出,这款模型主打速度。官方强调其在代码开发中可用于快速修复Bug,突出响应速度与稳定性。这类轻量、高频、低延迟的模型,正是当下开发者工具链中不可或缺的一环——不追求解决最复杂的问题,而是把常见任务做得又快又稳。
结合Sonnet 5.5、OpenAI "O"以及MiniMax M3.1的密集动态可以看出,无论海外还是国内,AI厂商的竞争焦点都在快速向"编程辅助"和"智能体"两大方向集中。对开发者而言,这意味着可选工具越来越多,也越来越需要根据成本与场景做出精准取舍。
模型命名中的「Flash」源自Google在Gemini系列中首先推广的分级命名惯例:Ultra/Pro对应旗舰能力,Flash对应高速低延迟的轻量版本。这一命名逻辑已被业界广泛借鉴,暗示该模型在推理速度与成本上做了针对性优化,通常以更小的参数规模或更激进的量化策略换取更低的首字节响应时间(TTFT)。对于需要实时补全、快速Lint修复的IDE插件或CI/CD流水线而言,50ms与500ms的响应差距往往直接影响开发体验。Flash级模型并不追求在困难推理或长上下文任务上超越旗舰模型,而是在「够用即可」的高频场景下把性价比做到极致,与旗舰模型形成互补的产品矩阵。
相关推荐

前端转AI Agent开发:一线架构师解析职业路径与红利
一线AI架构师解析前端转AI Agent开发的行业变化与落地路径:纯前端岗位为何消失、Agent+全栈为何成为招聘主流,以及Agent开发工程师、FDE、远程接单三条转型路线和对应学习策略。

AI Agent开发课程怎么选?五条避坑指南
机械转行开发者踩坑两年总结的AI Agent开发课程筛选清单:完整交付链路、可写进简历的项目、真实开发视角、更新频率、陪跑反馈五个维度,附具体判断方法和避坑要点。

扣子(Coze)智能体搭建入门:零代码开发AI Agent实战指南
扣子(Coze)是字节跳动推出的一站式AI应用开发平台,支持零代码拖拽搭建AI智能体。本文基于B站教程梳理扣子的核心概念、三大优势、国内版与国际版差异,以及智能体与应用的区别,帮助初学者快速入门AI Agent开发。