Claude Sonnet 5.5将发布,国内大厂紧急对标Meta Muse
AI圈密集动态:Claude新版临近、Muse引燃智能体争夺战、推理成本压缩与硬件安全底座同步推进。
本文梳理了9月28日前后AI产业的一批集中动态。旗舰模型层面,Claude Sonnet 5.5灰度测试扩大,Gemini 4.0预计10月中下旬发布,头部模型迭代周期持续压缩。产品层面,Meta Muse以"主动型个人智能体"姿态上线两周即登顶App Store,直接触发字节、腾讯在中秋假期紧急对标,国内个人智能体赛道进入抢滩阶段。工具链层面,Fireworks Amber-E将推理Token用量降低约40%,DeepSeek 0.2系列从堆功能转向模块化智能体平台,推理经济性与工程化成熟度同步提升。安全层面,英伟达发布OpenShell+Sentry方案,实现芯片层毫秒级行为隔离。商业化层面,荣耀联合中国移动推出可用话费支付的Token套餐,探索AI普惠化路径。整体竞争焦点正从"模型有多强"转向"智能体能否安全、经济、持续地自主干活"。
近期AI圈动作密集,从旗舰模型迭代到个人智能体产品竞赛,再到安全平台与商业化套餐,几乎每个环节都在同步加速。本文梳理9月28日前后的一批关键动态,还原当前AI产品竞争的真实节奏。
Claude Sonnet 5.5 或将发布
据爆料人Lyra此前消息,Claude Sonnet 5.5 可能在北京时间29日凌晨2点前发布。目前该版本的灰度测试范围已明显扩大,正在向更多用户推送——这通常是正式上线前的最后信号。
从Anthropic的迭代节奏看,Sonnet系列一直定位为性能与成本平衡的主力模型,5.5的到来意味着中端模型能力将再上一个台阶。对于大量依赖API调用的开发者和企业而言,Sonnet级别模型的更新往往比旗舰Opus更具实际影响,因为它直接关系到日常任务的调用成本与响应质量。
值得关注的是,几乎同一时间窗口,Gemini 4.0也被曝出计划于10月中下旬发布,目前最新检查点为9月24日的Baryon B。头部大模型的密集换代,正在把竞争推向更短的迭代周期。
Meta Muse引爆个人智能体赛道
Meta Muse是Meta推出的一款个人AI智能体,能够理解用户的长期目标,并主动代劳执行多步骤的复杂任务。上线仅两周左右,它便在App Store登顶下载榜,下载量超越ChatGPT——这个成绩说明市场对"主动型智能体"的需求已经被彻底激发。
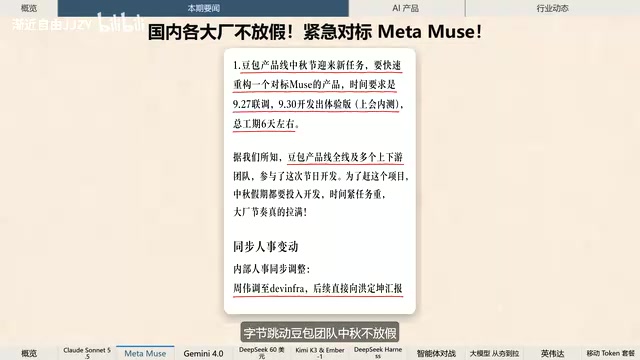
Muse暂时不对国内开放,但它的成功迅速触发了连锁反应。字节跳动的兜包团队中秋不放假,利用约6天时间重构一款对标Muse的产品;腾讯轻量云团队动作更快,已经上线国产版Muse Lite——Viola,直接提供一台7x24在线的专属云电脑,配合云端Hermes Agent。注册即送一个月免费试用加4500 AI积分,原价约10美元每月。
国内大厂在假期期间紧急赶工对标海外爆款产品,本身就是一个信号:个人AI智能体正从概念阶段进入抢滩登陆的市场争夺战,谁先把"能自主干活的助手"做到可用,谁就能占据先发优势。
个人AI智能体(Personal AI Agent)与普通聊天机器人的核心区别在于"自主性":普通助手被动响应单条指令,而智能体能将用户的长期目标拆解为多个子任务,自主规划执行顺序,并在过程中调用外部工具(如浏览器、日历、文件系统)。Muse所展示的"主动型智能体"范式,依赖对用户偏好与上下文的持续记忆,能跨会话理解"帮我每周整理工作报告"这类需要反复执行的意图,而非仅仅回答一次性问题。这一模式的技术难点在于长期记忆管理、任务中断与恢复,以及多步骤执行中的错误修正,这也是为何国内团队选择以"云电脑+常驻Agent"的架构(如Viola的Hermes Agent)来对标——让智能体7×24小时在线运行,绕开手机端本地算力的限制。
开源与推理效率的持续进化
模型层之外,工具链和推理效率的优化同样密集。基于OpenCode,DeepSeek广告 V4.1 Flash的60美元定价被设为永久后,CommandCode GOAT也跟进将4.1 Flash的60美元设为永久,进一步压低了开发者的使用门槛。
Fireworks Research发布了专用模型Amber-E,基于KimiK3构建,能生成更短的推理轨迹,Token用量减少约40%,同时保持同等质量。
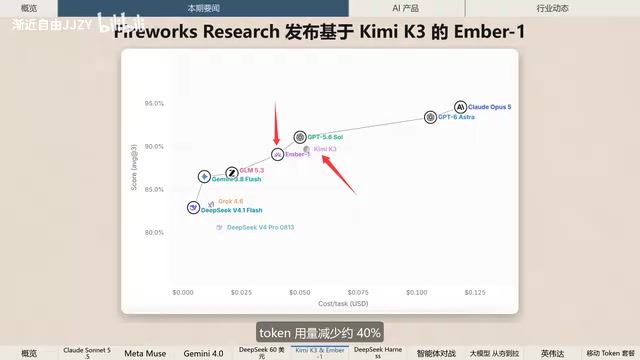
Token用量减少四成而质量不降,这类优化对高频调用场景意义重大——它意味着同样的预算可以支撑更多任务,直接改善智能体长时间运行的经济性。
DeepSeek官方也发布了0.2.0系列的首个候选版本。此前的0.1系列不断给Hermes加能力,而0.2系列开始把这些能力整理成一个模块化、可靠、可以长期运行agent的平台。从"堆功能"到"做平台"的转变,标志着开源智能体框架正在走向工程化成熟。
推理轨迹(Reasoning Trace)是大语言模型在生成最终答案前,逐步输出中间思考过程的Token序列,常见于Chain-of-Thought(思维链)提示或专用推理模型中。这些中间步骤虽能提升复杂任务的准确率,但会消耗大量额外Token,直接推高调用成本。Amber-E的核心贡献在于"轨迹压缩":通过训练让模型以更简洁的路径完成推理,去除冗余步骤,使Token用量下降约40%而答案质量不降。对于需要大量调用推理模型的智能体场景(如循环规划、自我反思),这种优化的经济价值远超单次对话——在长时间自主运行中,Token成本往往是制约智能体规模化落地的主要瓶颈之一。
AI模型对战与真实排名
有意思的是,模型能力的横向比较也开始变得更透明。ShowHN项目Tiny AI Arena上线,让多个AI模型以智能体对战形式同场竞技,并公开战绩。排行榜显示,Claude Sonnet 5出战21场,胜率43%居首;Fable 5.1以32%胜率、平均名次1.88紧随其后。
知名LLM测评用户Mia也发表了对前沿云端和本地AI模型的排名:S档只有一个Opus 5.5,A档只有一个Fable 5.1,Astra位于B档,并与三家开源模型并列。
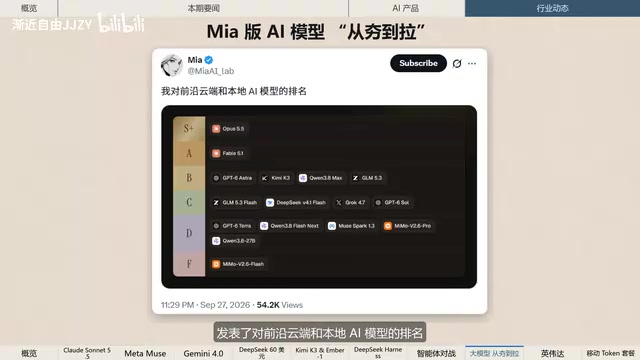
由于这位博主自己部署了大量开源模型,不存在服务端降质的问题,因此其对开源模型的体感评价具有额外参考价值。这类由独立用户主导的评测,正在成为官方跑分之外的重要补充。
智能体安全与商业化落地
随着智能体自主性增强,安全问题被摆上台面。英伟达发布了开放式AI智能体安全平台,包含OpenShell安全软件与NVIDIA Sentry看门狗系统。OpenShell可对运行在CPU上的AI智能体设定边界,支持开源、闭源模型及第三方硬件;Sentry运行于Bluefield 4 DPU上,能在芯片层面独立监控智能体行为,一旦检测到突破限制的行为,可在毫秒内将其隔离并停止运行。目前Anthropic、SpaceX等公司已与其合作采用。
在芯片层实现独立监控,是一种"硬约束"思路——不依赖模型自身的对齐,而是从底层硬件划定不可逾越的边界,这对于将要大规模部署的自主智能体尤为关键。
商业化方面,荣耀CEO李健宣布与中国移动联合首发Token套餐,包含智能服务与通信服务,支持头部AI自由搭配及多款AI应用按需组合,可通过话费支付。套餐共三档,价格169元每月起,另有加油包5000万Token起,首批在杭州、郑州等6个城市试点发售。把Token消费打包进话费套餐,是运营商探索AI普惠化的一次值得关注的尝试。
英伟达的Bluefield 4 DPU(数据处理单元)是一种独立于主机CPU与GPU之外的专用芯片,最初设计用于网络与存储加速。将Sentry安全监控运行在DPU上,意味着即使主机侧的AI模型或操作系统被攻破或行为失控,监控层本身依然能正常运转并执行隔离指令——这是"带外监控"架构的核心优势。相比依靠模型自身输出"我不会做有害的事"的软对齐方案,硬件级隔离提供了一道与模型行为完全解耦的物理防线。随着自主智能体被部署到工厂控制、航天等高风险场景(SpaceX已参与合作),此类芯片层的强制约束机制将成为大规模商用部署的合规基础设施前提。
结语
从模型迭代、个人智能体竞赛,到推理效率优化、安全底座与商业化套餐,这一批动态勾勒出AI产业当前的整体走向:竞争焦点正从"模型有多强"逐步转向"智能体能否安全、经济、可靠地长期干活"。接下来Claude Sonnet 5.5与Gemini 4.0的正式表现,值得持续跟进。
相关推荐

无GPU也能跑大模型?老旧DDR3服务器的本地推理性价比探讨
一场Reddit讨论探讨了无GPU本地部署大模型的可行性:用老旧DDR3多路服务器靠内存带宽跑Qwen 3.8 Flash,以及4bit量化、KV缓存与上下文长度的实用权衡与电费成本争议。

拓扑域外泛化:让AI预测系统从未见过的动力学突变
NeurIPS论文提出拓扑域外泛化方法,通过特征分离与物理稀疏先验修复分层DSR模型缺陷,使AI能在不知控制参数的情况下预测系统分岔与动力学突变,适用于PLRNN和Neural ODE。

用不好AI Agent是你的错吗?破解AI工具焦虑的实用指南
用不好AI Agent是你的能力问题吗?本文从产品成熟度、使用预期和场景匹配三个角度剖析AI工具使用困境,提供破解AI焦虑的实用方法与选型建议。