Claude服务遭遇404错误:AI服务稳定性问题与应对策略

Reddit用户反映Anthropic Claude服务出现404错误,折射出AI基础设施稳定性挑战与开发者容错设计的重要性。
一篇Reddit帖子记录了用户同时遭遇404页面与Claude API错误的情况,引发对AI服务稳定性的讨论。文章从技术层面解析了404错误在AI服务语境下的多种成因——涵盖部署问题、负载均衡故障、CDN异常及API网关变更——并指出大型语言模型服务因计算资源密集、流量峰值难预测、迭代部署频繁等特性,比传统Web应用更易出现波动。针对开发者和企业用户,文章建议通过重试与指数退避、服务降级、多供应商冗余及完善监控告警体系来构建容错能力,同时提醒普通用户遇到故障时应优先查阅官方状态页而非仅依赖社区求证。
事件概述
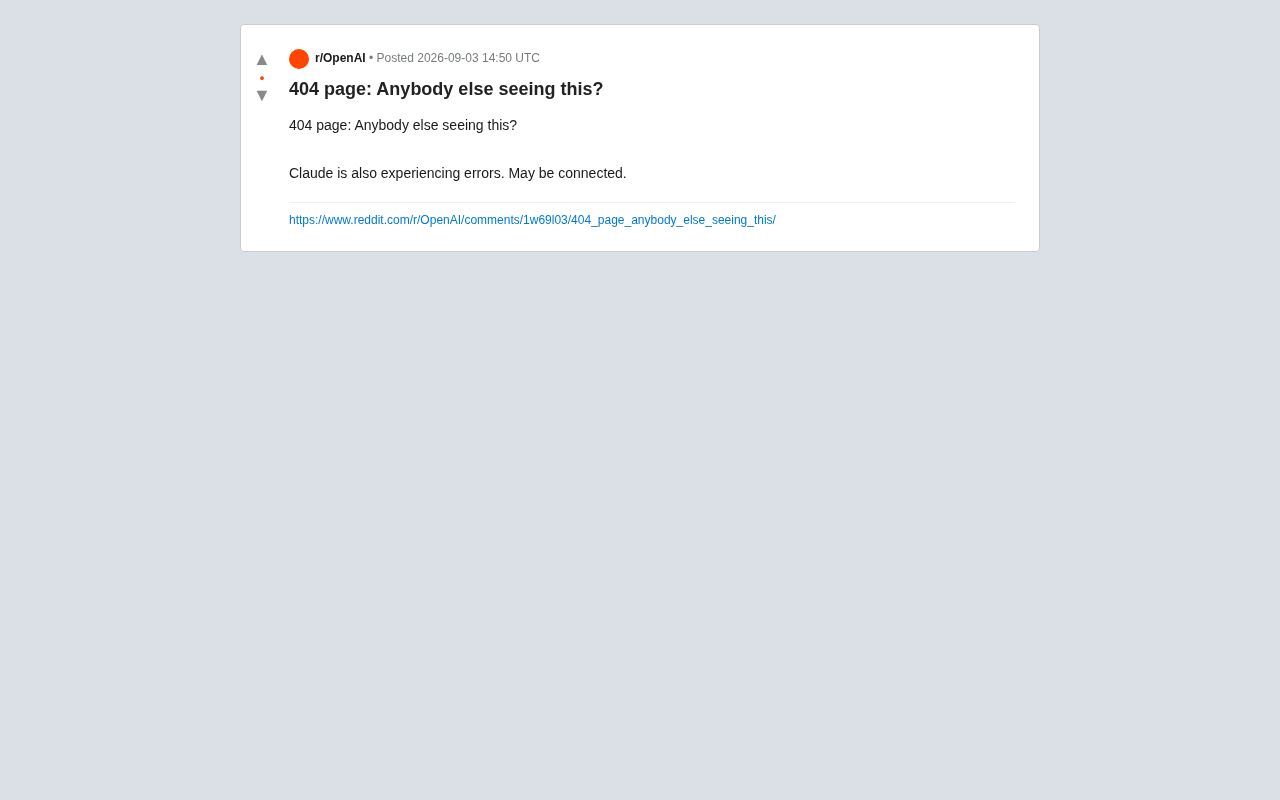
近期,Reddit社区中有用户发帖询问:"是否有其他人也遇到了404页面?"("404 page: Anybody else seeing this?")。发帖者进一步指出,Anthropic旗下的Claude AI服务同时也出现了错误提示,并推测这两个问题可能存在关联。
虽然这只是一条简短的社区求助帖,但它触及了当前AI服务领域一个日益受到关注的话题:大型语言模型服务的稳定性与可用性。当越来越多的开发者和普通用户将日常工作流建立在AI工具之上时,任何一次服务中断都可能引发连锁反应。
404错误在AI服务中意味着什么
技术层面的解读
404是HTTP状态码中最为人熟知的一种,代表"页面未找到"(Not Found)。当用户访问某个页面却收到404响应时,通常意味着服务器无法定位到请求的资源。
在AI服务的语境下,404页面的出现可能有多种深层原因:
- 服务端部署问题:新版本上线或回滚过程中,部分路由配置可能出现临时错误
- 负载均衡故障:请求被错误地路由到不可用的后端节点时,也可能返回404
- CDN节点异常:内容分发网络的某个节点出现问题,导致特定地区的用户无法正常访问
- API网关配置变更:服务端点调整期间,旧路径可能短暂失效
发帖者提到的"Claude也在报错"这一细节尤为关键。如果404页面与Claude的API错误同时发生,那么问题很可能出在Anthropic的核心基础设施层面,而非单纯的前端页面问题。
对用户体验的影响
对于普通用户而言,404页面往往令人困惑——他们无法判断是自己的操作有误,还是服务本身出了问题。这种不确定性正是社区求证行为的根源:通过询问"是否有其他人遇到",用户希望快速确认这是否为普遍性故障。
AI服务稳定性的现实挑战
大模型服务为何更容易出现波动
与传统Web应用相比,大型语言模型服务面临着独特的稳定性挑战:
- 计算资源高度密集:每一次推理都需要消耗大量GPU算力,容量规划的难度远超普通应用
- 流量峰值难以预测:突发的用户增长或热点事件可能在短时间内压垮服务
- 模型迭代部署频繁:Anthropic等公司持续更新模型版本,部署过程本身就存在引入故障的风险
- 依赖链条复杂:从前端界面、API网关到推理引擎,任何一个环节出问题都会影响整体可用性
无论是Claude、ChatGPT还是其他AI服务,都曾不时出现过服务中断事件。这提醒我们,尽管这些服务已相当成熟,但底层基础设施仍在快速演进,稳定性并非理所当然。
善用官方状态页判断故障范围
对于遇到类似问题的用户,最可靠的做法是查看Anthropic的官方状态页面(Status Page)。官方状态页会实时更新服务健康状况,标注各组件的运行状态。当出现404或API错误时,第一时间查看官方通告,往往比在社区中求证更为高效准确。
此外,第三方监控平台如Downdetector也能帮助用户快速判断是否为大范围故障。
开发者与企业用户的应对策略
构建完善的容错机制
对于将Claude API集成到产品中的开发者而言,此类事件是一个重要提醒:不应假设第三方AI服务永远可用。合理的架构设计应包括以下几个层面:
- 重试与指数退避策略:在遇到临时错误(如404、500、503)时自动重试,并逐步增加间隔时间,避免加剧服务端压力
- 服务降级方案:当主服务不可用时,切换到备用模型或提供有限但可用的功能
- 多供应商冗余:对于关键业务场景,考虑同时接入Claude、OpenAI等多家AI服务提供商,实现故障自动切换
- 请求超时控制:设置合理的超时阈值,防止用户长时间等待无响应
建立监控与告警体系
企业级应用应建立完善的监控体系,实时追踪AI服务的响应状态、延迟和错误率。一旦检测到异常指标上升,能够及时触发告警并启动应急预案,最大限度减少对终端用户的影响。
建议关注的核心指标包括:
- API响应时间的P95/P99分位值
- HTTP错误码(4xx/5xx)的出现频率
- 请求成功率的实时变化趋势
结语
这条简短的Reddit帖子看似只是一次普通的故障求证,却折射出AI时代基础设施的脆弱性与重要性。随着大型语言模型深度融入生产环境,服务稳定性已不再是可选项,而是核心竞争力的组成部分。
对于用户而言,遇到404或类似错误时保持冷静、查阅官方状态页是最明智的做法;对于开发者和企业,则应未雨绸缪,在架构层面构建足够的容错能力。唯有如此,才能在享受AI技术红利的同时,将服务中断带来的风险降至最低。
相关推荐

Arsaze:把Cursor的Tab补全带到视频剪辑
Arsaze是一款AI原生视频编辑器,把Cursor的Tab补全交互带入视频剪辑:剪一次按Tab即可重复风格,还能删除转录文字来裁剪片段。本文解析其工作流、账户限制与评测结论。

GitHub会消亡吗?开源维护者倦怠与AI时代的协作危机
Lex Fridman播客讨论开源维护者倦怠与GitHub的困境:海量拉取请求压垮核心维护者,AI加剧代码膨胀。文章以数学期刊审稿与庞加莱猜想验证为类比,剖析知识生产中验证环节为何必须刻意缓慢,以及开源社区如何避免维护者退出的失败模式。

别再做千篇一律的AI网站:3个工具让编码Agent脱胎换骨
介绍三个提升AI编码Agent能力的工具:FFmpeg skill让Claude Code和Cursor本地剪辑视频,Hallmark用50套设计主题解决AI网站千篇一律的问题,Jailbreaks提供25种以上模型的提示词配置,并分析技能化扩展的共同逻辑。