ClaudeMem:让Claude、ChatGPT、Grok共享记忆的AI Agent记忆层

ClaudeMem为多个AI Agent提供本地优先的共享记忆层,消除人工交接上下文的成本。
文章介绍了一款名为ClaudeMem的工具,它针对多Agent用户的核心痛点——每个AI模型彼此“失忆”,切换工具就得人工搬运上下文。演示中,创作者在ClaudeCode完成“社区清扫”的代码工作后,让ChatGPT通过ClaudeMem读取结果并生成信息图,展示了Agent之间无需人工中转的协作方式。ClaudeMem坚持workflow agnostic,作为后台观察者运行,不改变用户现有习惯;安装仅需一条npx命令,支持T3 Code、DeepSeek、GrokBot等接入。安全上采用本地优先架构,支持自建Docker与开源服务器部署。创作者将其定位为“面向所有Agent的通用记忆适配器”,并设想未来由单一编排者Bot实现更高层级协调。
跨Agent协作的痛点:每个AI都在"失忆"
你在Claude里推进一个项目,切换到ChatGPT时它对你的进度一无所知,下周再用GrokBot,前两个Agent做过什么它同样茫然。这种割裂感几乎是每个多Agent用户都经历过的日常。
YouTube频道介绍了一个名为ClaudeMem的解决方案:它为所有Agent维护一份共享记忆,让一个Agent的工作成果可以被另一个Agent直接读取和延续。你可以在一个模型里启动项目,换到另一个模型继续,再换第三个、第四个,它们通过ClaudeMem彼此"知情"。视频由AI自动化公司Zapier呈现,ClaudeMem的创作者亲自演示了使用流程。
演示:从Claude的代码工作到ChatGPT的信息图
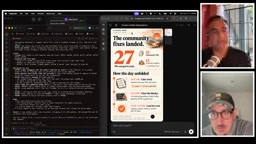
演示场景很具体。创作者在ClaudeCode中运行了一个"社区清扫"技能,自动找出可合并的PR、确认改动符合要求、撰写文档并跟进相关人员。问题在于,Claude输出的结尾部分缺乏上下文,人很难一眼看懂发生了什么。
于是他转向ChatGPT,要求它基于Claude的工作生成移动端友好的信息图,指令是让ClaudeMem去取"社区清扫的最新结果"。生成的信息图清晰呈现了关键数据:25个社区PR落地、13位贡献者、2个维护者修复;11:47进行盘点,12:13 PostHog依赖导致构建失败,后续工作持续推进。ChatGPT并不知道Claude做过什么,但通过ClaudeMem它拿到了全部素材。
这个例子的价值不在于信息图本身,而在于它展示了一种新的协作范式:Agent之间不再需要人工搬运上下文。
PR(Pull Request) 是代码协作平台(如GitHub)中的核心机制:开发者不直接修改主干代码,而是先在自己的分支上完成改动,再发起一个“合并请求”,由维护者审核、讨论、测试后再合入主分支。文中的“社区清扫”技能所做的“找出可合并的PR、确认改动符合要求”,本质上是自动化执行开源项目中最耗时的一环——鉴别哪些贡献已经可以合入、哪些还需要补充文档或反馈。对不熟悉开源流程的读者来说,理解PR审核的繁琐程度,才能体会这种自动化对维护者时间成本的节省意义。
工作流无关:不改变你现有习惯的记忆层
创作者反复强调的设计理念是"workflow agnostic"——ClaudeMem是一个后台观察者,你不需要学习新的操作方式来使用它,它只是让你当前的工作方式变得更好。
这个取舍有其现实考量。创作者的原话大意是:如果一个工具需要你专门去学,那就是一场赌博——它到底会帮到你,还是会让你今晚没法回家吃饭?把记忆做成后台静默运行的基础设施,而不是又一个需要投入学习成本的产品,是ClaudeMem区别于多数Agent工具的地方。
安装与多Agent接入
安装过程被压缩成一条命令:npx claudemem install。执行后工具会询问你使用哪些Agent,勾选即可完成连接。
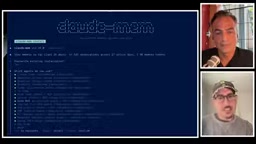
目前已支持的接入对象包括T3 Code、DeepSeek广告、GrokBot等,其中GrokBot是较新加入的,也可以通过grok-mem.ai或直接对Agent说"install ClaudeMem"来完成配置。这种"让Agent自己安装"的路径,与它后台静默的产品定位一致。
安全与部署:本地优先,云端可选
把全部Agent记忆交给第三方云服务,是演示中提出的尖锐问题。创作者的回答是分层的:付费云版本有安全保障;同时ClaudeMem从诞生之初就是本地优先的——这正是它最初被做出来的原因。用户可以运行自己的Docker实例实现更强的隔离,开源服务器也可以自行部署到远程环境。
对开发团队而言,这个设计意味着记忆数据的控制权可以留在自己手里,而不是被迫托管。
本地优先(local-first) 是一种软件架构理念:数据的权威副本存放在用户自己的设备或自建服务器上,云端同步只是可选的增强能力,而不是运行的前提。与“云端优先”相比,本地优先在隐私、延迟和离线可用性上占优,代价是用户需要承担一定的部署与维护责任。Docker 则是把应用及其依赖打包成标准化容器的工具,一条命令即可在任意机器上复现相同运行环境,因此常被用来实现“数据不出自己掌控”的自托管部署。文中提到的自建Docker实例,正是这一路线的具体落地方式。
实际用法:按任务选模型,交接由记忆层完成
创作者描述了自己的真实工作流:在ClaudeCode里搭建work state tracker,同时通过ChatGPT的work tab远程处理大量工作,研究在一边做,成果拿到另一边去完善。核心逻辑是"为每个任务挑最合适的模型",而它们之间的协调全部由ClaudeMem承担。
由此省掉的是人工交接成本——不用再在笔记里记录"这件事我是在ChatGPT里做的还是Claude里做的"。几个月前的想法可以直接进入当前工作,只需要问一句就行。
下一步:从共享记忆到单一编排者
演示中提出的进阶问题是:Agent之间会不会自己互相交接任务,比如Claude把设计项目交给ChatGPT,ChatGPT完成后交回Claude编程?
创作者的回答指向另一个方向:他设想的是一个类似GrokBot的单一编排者Bot,作为用户对话的统一入口,实现更高层级的控制。而ClaudeMem自身的定位被明确为"面向所有Agent的通用记忆适配器"。这一定位决定了它不试图成为调度中心,而是成为调度得以发生的前提——没有共享记忆,任何编排都只是空谈。
对同时使用多个AI编程与对话工具的人来说,ClaudeMem解决的是一个基础但长期被忽视的层:不是更强的模型,而是模型之间的记忆连续性。
编排者(orchestrator)模式 是多Agent系统中的常见架构:由一个主控Agent负责拆解任务、分派给专长不同的子Agent,并汇总结果,用户只与这个统一入口对话。它与“对等交接”(Agent之间直接互相移交任务)是两种不同的协调思路。编排者的优势在于全局可见性与可控性,但前提是所有参与者都能访问同一份状态与上下文——这恰好解释了为什么创作者认为共享记忆层是编排的先决条件,而不是可以后补的附加功能。
相关推荐

育儿付费从何时成为常态?职场妈妈与托育变迁
育儿付费何时成为常态?本文梳理从70-80年代托育中心兴起、90年代联邦补贴挂钩工作要求,到污名下降与成本上升的演变,并探讨倡导者推动托育与带薪产假追赶其他国家的25年努力。

AI智能体最该接管的任务是什么?Reddit热议
Reddit热议:你最希望AI智能体完全接管哪项任务?跨应用数据迁移、CRM更新、报告生成位列榜首,但可靠性不足和信任鸿沟成为自动化落地的最大障碍。

产品市场匹配的红色警报:顶级VC与Superhuman创始人实战指南
Iconiq、Sapphire Ventures投资人与Superhuman创始人Rahul Vohra分享产品市场匹配(PMF)的红色警报与实战方法,包括40%失望度法则、留存曲线和获客成本等关键指标。