Claude平台用量数据加载报错事件的复盘与启示

Anthropic 用量页面故障约1小时40分钟,Messages API 未受影响,暴露计费数据可用性风险。
Anthropic 的 platform.claude.com 用量页面及 Admin API 的 usage report 端点发生高频率错误,持续约1小时40分钟。官方状态页明确表示 Messages API 请求未受影响,故障仅限于用量数据读取链路。文章分析指出,用量查询走的是日志管道、统计存储和报表查询层等独立依赖,与推理路径完全不同,因此可被隔离。对开发者而言,事件提示不应只依赖平台面板做成本监控,建议在应用侧自行记录 token 计数并做交叉校验,同时为 Admin API 调用设计重试与缓存降级逻辑。用量与计费数据的可用性正从“nice to have”变为与推理可用性同等重要的基础设施指标。
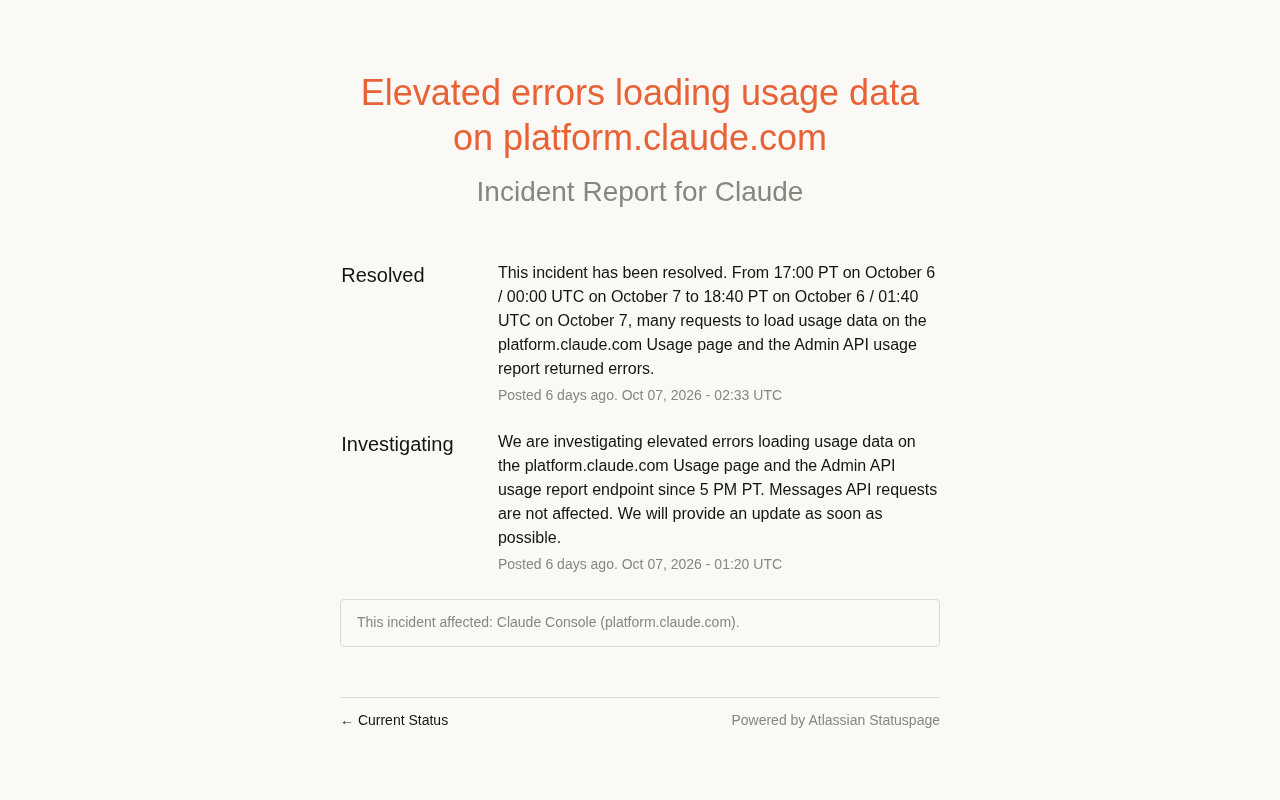
当开发者打开 Anthropic 的 platform.claude.com 用量页面,却发现自己团队的 token 消耗、调用统计全都加载不出来时,这种焦虑并不亚于一次线上故障。Anthropic 官方状态页记录的一次事件,恰好暴露了现代 AI 平台在“可观测性”层面的一个薄弱环节。
事件全过程还原
根据 Anthropic 状态页的两次更新,这次故障的时间线相当清晰:
- 发现与调查阶段:团队在 UTC 时间凌晨 01:20(太平洋时间下午 5 点)发布状态更新,确认
platform.claude.com的 Usage 页面以及 Admin API 的 usage report 端点出现“高频率错误”。 - 影响范围界定:状态页特别强调,Messages API 请求未受影响——换句话说,模型推理本身照常运行,出问题的是“查看账本”这条链路。
- 解决与复盘:UTC 02:33 发布已解决通告,故障窗口从太平洋时间 10 月 6 日 17:00 持续到 18:40,约 1 小时 40 分钟。
这种“模型在用、数据看不到”的状态,对依赖用量数据做成本核算和配额管理的团队来说,实际影响其实不小。
UTC 与太平洋时间的对应关系:文章中提到状态页的更新时间使用了 UTC 和太平洋时间(PT)两种表示。UTC(协调世界时)是全球通用的时间基准,而太平洋时间在 10 月处于夏令时(PDT,UTC-7),因此 UTC 01:20 对应太平洋时间前一日 18:20(下午 6 点 20 分),而非文章所述的下午 5 点——后者更接近 UTC 00:00。理解这一时区换算,有助于准确还原故障窗口的真实起止时刻,避免跨团队沟通时对“故障持续了多久”产生歧义。在跨国协作的 SRE 场景中,统一以 UTC 记录事件时间线是行业惯例。
Admin API 与 Messages API 的区别:Messages API 是面向模型推理的接口,开发者通过它发送对话请求并获取补全结果;Admin API 则是面向组织管理的接口,用于查询成员、密钥、用量报告等运维数据。两者在 Anthropic 的架构中属于不同的服务边界,拥有独立的限流、鉴权和后端依赖。因此,Admin API 的 usage report 端点故障并不必然波及推理请求——这也解释了状态页为何能明确划分影响范围。
为什么“看用量”这件事会出问题
Usage 页面和 Admin API 的 usage report,本质上是一个读多写少、但链路很长的数据聚合系统。它要把跨区域的调用日志聚合、去重、按组织/项目维度汇总,再通过前端或 API 暴露出去。
对比 Messages API 这条“写路径”,用量查询走的是完全不同的服务依赖。前者只要推理集群和网关健康就能工作,后者还额外依赖日志管道、统计存储和报表查询层。这解释了为什么状态页能明确说“Messages API 不受影响”——它们压根不在同一条关键路径上。
对开发者而言,这提示了一个常被忽略的风险:你的监控面板可能是最脆弱的那一环。当用量数据不可用时,团队既无法判断当前消耗是否异常,也无法及时触发预算告警。
读多写少与数据聚合系统:“读多写少”描述的是这类系统的访问模式——调用日志的写入是持续、稳定的(每次 API 调用产生一条记录),而用量查询的读取则集中在报表刷新、账单核对、告警轮询等场景,读请求量可能远高于写入量,但对延迟和一致性的要求也更高。更关键的是,用量查询需要在海量日志上做聚合、去重、按维度汇总,这通常依赖列式存储或 OLAP 引擎,与推理服务所用的低延迟键值存储完全不同。
可观测性(Observability):可观测性指通过日志、指标、追踪三类数据推断系统内部状态的能力。在 AI 平台语境下,它不仅包括平台自身的运维监控,也包括向用户暴露的用量、配额、错误率等面板。当可观测性链路本身失效时,用户会陷入“黑箱”状态——既不知道系统是否正常,也无法验证自己的判断。这正是本次事件的核心风险:推理正常但账本不可见,等于失去了成本与配额的控制感。
开发者应该从中吸取什么
事件本身已解决,但有几条实践值得留下来:
- 不要只依赖平台面板做成本监控。可以在应用侧自行记录 token 计数,和平台数据做交叉校验,面板偶发不可用时不至于两眼一抹黑。
- 为 Admin API 调用设计降级逻辑。如果你的财务或告警系统定时拉取 usage report,建议对返回错误做重试与缓存兜底,而不是让整条流程直接中断。
- 关注状态页,但别只盯状态页。Anthropic 在这次事件中做到了及时更新调查进展与解决结果,这种透明度值得肯定。但对团队来说,更重要的是把这类信息接入自己的告警渠道。
平台可靠性的一面镜子
Anthropic 在这次事件中的处理方式相对规范:先确认问题、明确影响边界(Messages API 不受影响)、给出时间窗口、再宣布解决。这种把“影响范围”讲清楚的沟通,比单纯说“我们正在修复”更有价值。
从更宏观的角度看,随着越来越多企业把关键业务跑在大模型 API 上,用量与计费数据的可用性,正在从“nice to have”变成和推理可用性同等重要的基础设施指标。一次短暂的用量页面故障,也许不会影响你的产品功能,但它会直接影响你对成本的掌控力。对平台方和开发者来说,这都是一次值得记住的提醒。
相关推荐

WorkBuddy全流程教程:从零搭建AI办公自动化智能体
WorkBuddy 全流程教程精讲:从下载安装、三种工作模式到多模态绘本视频实战,再到专家团搭建智能体与工作流配置,帮你用低成本 AI Agent 实现办公自动化。

WorkBuddy智能体全攻略:7天从入门到自动化实战
基于B站256集WorkBuddy全套精讲课程,系统拆解腾讯AI办公工作台的核心能力:Agent原理、Skill封装、连接器跨平台、定时自动化、知识库与零代码开发,附学习路径建议。

8个AI账号翻车7个:我用AI干活的真实复盘
B站8个AI运营账号仅1个跑通。本文拆解"演AI"与"用AI干活"的本质区别,分析5条视频217万播放背后的产能控制、评论区运营和交付节奏策略。