Claude全面加水印:付费用户也无法关闭,检测权限却只给少数人

Claude 水印扩围全球且不可退出,标记「处理过」却只让机构验证,误伤普通人。
Anthropic 将 Claude 隐形文本水印从 11 月 3 日起扩展至 Mythos 5、Opus 4.7、Opus 4.6 和 Sonnet 4.6,全球适用且付费用户无法退出。水印嵌于用词选择的统计模式中,人工不可见,但触发条件宽泛:校对、翻译、润色同样会被标记,非英语母语者和阅读障碍者受影响最大。矛盾在于验证能力仅向监管机构、媒体、研究人员、教育机构及有合规义务的企业开放私有预览,普通用户无法自查。社区还指出水印可通过其他模型改写去除,对恶意使用者约束有限,而水印窃取研究预示第三方检测器跟进后误判风险上升。
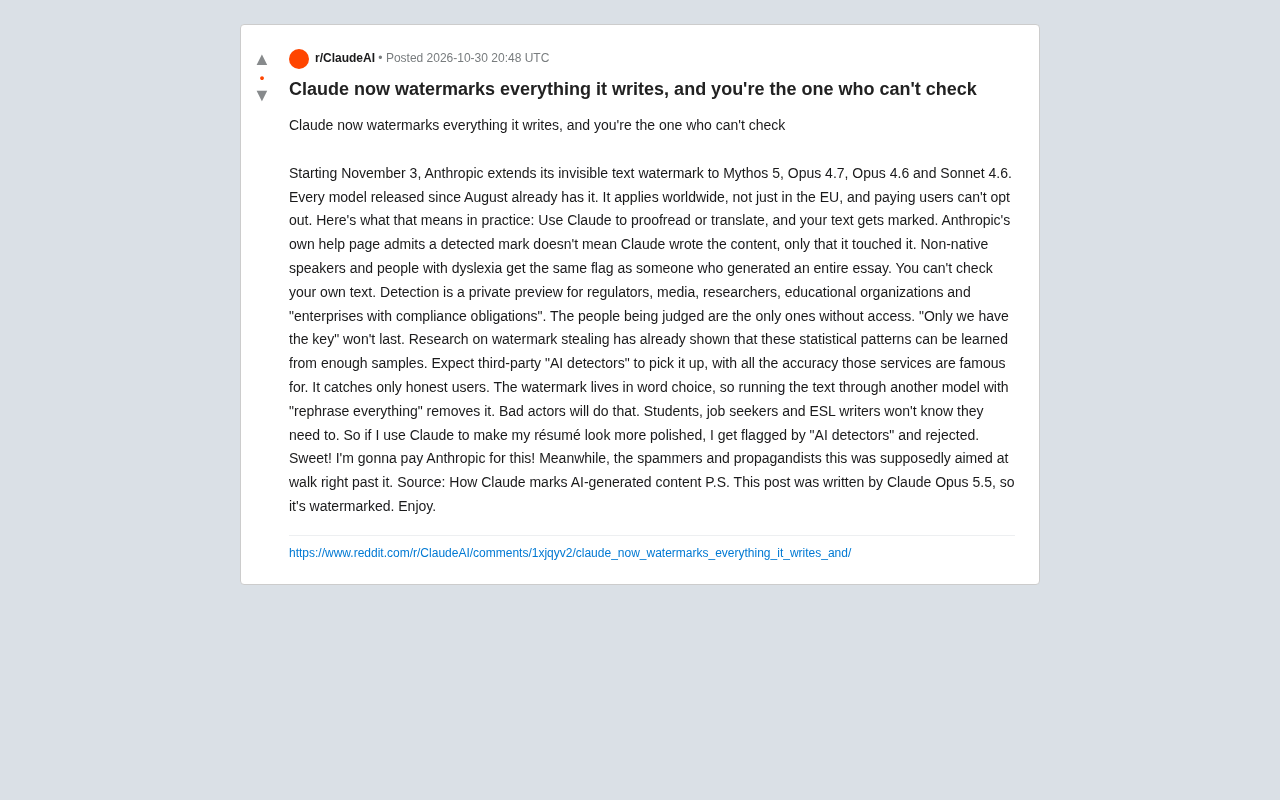
Anthropic 的文本水印策略又扩张了一步。根据 Reddit 社区流传的一份整理,从 11 月 3 日起,Claude 的隐形文本水印将覆盖 Mythos 5、Opus 4.7、Opus 4.6 和 Sonnet 4.6,而自 8 月以来发布的所有模型本就已经内置这一机制。更关键的是两点:全球范围适用(并非仅限于欧盟),且付费用户无法选择退出。
这条消息之所以引发争议,不在于水印本身,而在于水印背后的权力不对称——标记是悄悄打上的,验证能力却被锁在少数机构手里。
水印到底标了什么:从「生成」扩张到「触碰」
按照帖子中的描述,水印嵌入在文本的用词选择中,是一种统计层面的隐形标记,人工阅读时不可见。这与常见的「AI 检测器」思路不同:后者是基于文本特征的猜测,而官方水印在理论上具备可验证性。
校对和翻译也算被标记
问题的微妙之处在于触发条件。Anthropic 自己的帮助页面承认:检测到标记并不意味着这段内容由 Claude 撰写,只能说明 Claude 处理过它。这意味着,如果你只是用 Claude 润色简历、校对语法或翻译一段文字,原始内容也会被一并打上水印。
帖子特别指出,非英语母语者和阅读障碍人群会承受不成比例的后果——他们使用 AI 辅助润色的场景最多,却和「让模型从零生成一整篇论文」的人拿到同样的标记。
无法自查的尴尬
普通用户拿到一段被水印处理的文本后,没有任何手段确认它是否带有标记。检测能力目前是私有预览,仅开放给监管机构、媒体、研究人员、教育机构和「有合规义务的企业」。
用帖子作者的原话说:被评判的人,恰恰是唯一没有访问权限的人。
文本水印属于统计水印(statistical watermarking)的一种:模型在生成每个 token 时,会依据一个只有厂商掌握的密钥对候选词表做伪随机划分,并轻微提升某一子集(常被称为「绿名单」)的采样概率。单看一句话几乎无法察觉,但在一段足够长的文本中,绿名单词的出现比例会稳定高于随机基线,检测方据此计算统计显著性即可判定水印存在。这与基于困惑度、句式特征等启发式信号判断的「AI 检测器」有本质区别——后者是概率猜测,前者在密钥保密的前提下可给出统计意义上的置信度。也正因如此,水印的鲁棒性与可检测性始终是一对矛盾:扰动越大越容易被发现,但对改写、翻译、同义替换的抵抗力也越弱。
「私有预览」是 AI 厂商常用的一种受限发布机制:功能已经可用,但只对少数合作方开放接口或白名单,以便在真实场景中收集反馈、控制滥用风险,同时保留随时调整政策的余地。放到水印检测的语境下,这种安排意味着检测权成了一种准入资格——谁能验证、验证结果如何被采信,取决于厂商与机构之间的合作关系,而非公开可复核的技术标准。与之形成对照的是学术界推动的开放检测方案(如开源水印检测库),其思路是让任何人持密钥即可验证,从而避免「判定权集中于单一主体」。目前尚无迹象表明 Anthropic 会走这条路。
水印的实际防护效果存疑
如果这套机制真能准确区分 AI 生成内容,代价或许还能接受。但社区讨论指出了几处结构性漏洞。
「只有我们有密钥」不会长久
帖子提到,关于水印窃取的研究已经证明,这类统计模式可以从足够多的样本中被学习出来。也就是说,密钥的独占性只是时间问题。第三方「AI 检测器」迟早会跟进——而这类服务在准确率上的口碑,大家心知肚明。
「水印窃取」(watermark stealing)是 2024 年以来的一类针对性研究:攻击者在无法获得密钥的情况下,通过大量查询带水印的模型输出,训练一个替代检测器来逼近原水印的判定边界,从而在外部复现检测能力,甚至反推密钥的部分信息。这类工作说明水印的安全性依赖于「密钥 + 有限查询」的双重假设,一旦模型被大规模公开调用,第二道防线就会松动。更现实的隐忧在于误判:第三方检测器往往缺乏原厂校准,假阳性率不可控,而它们恰恰最可能被招聘系统、在线教育平台等高风险场景采购。
它只拦得住老实人
水印存在于用词选择层面,因此把文本丢进另一个模型并要求「全部改写」,就能有效去除标记。恶意使用者会这么做,做垃圾信息和宣传渗透的人也会这么做。
真正不会这么做的,是不知道需要这么做的学生、求职者和 ESL 写作者。
这正是帖子作者的核心不满:用 Claude 把简历改得更体面,结果被「AI 检测器」判定并拒之门外,同时还要为这项服务付费;而水印原本想拦截的垃圾信息制造者,轻轻松松就绕过去了。
从信息隐藏的角度看,水印的鲁棒性取决于攻击者愿意付出多少改写代价。简单的同义替换、句序调整通常不足以清除统计信号,但「用另一个模型完整复述一遍」属于洗稿式攻击(paraphrase attack),会重新采样几乎每一个 token,使原有偏置彻底失效。这也是水印研究的经典结论:面向开放文本的统计水印,很难同时做到对良性编辑稳健、对恶意改写免疫。真正能提高门槛的是叠加多种信号(如生成日志、C2PA 内容凭证等来源元数据),但那些方案要求平台端配合,而非仅靠文本本身。
一个值得关注的行业信号
跳出这条具体政策,Anthropic 的做法反映了一个更广泛的趋势:内容溯源正在从「技术可选项」变成「平台默认项」,而默认项的受益者和承担者并不对称。
对内容平台、教育机构和招聘方来说,水印提供了一种看上去权威的判定依据;但对个人创作者和普通用户来说,它增加了无法自证清白的风险——你既看不到标记,也无法申诉或移除。
帖子末尾有一个耐人寻味的注脚:作者声称这篇帖子本身由 Claude Opus 5.5 撰写,因此也带有水印。无论这是玩笑还是事实,它都点出了一个悖论——当水印覆盖范围足够广,标记本身的区分度就会下降,最终所有人都可能「有嫌疑」。
对于依赖 AI 辅助写作的用户,短期内可行的做法是:对重要文本(简历、申请材料、正式发表内容)保留人工改写环节,不要让模型直接输出最终版本;同时留意使用场景中是否明确禁止 AI 参与。至于水印验证何时向公众开放、以何种形式开放,目前还没有时间表。
相关推荐

合理使用制度为何对AI时代人人有益
从Hacker News讨论出发,解析合理使用(Fair Use)原则在AI训练与内容创作中的法律逻辑、争议焦点及其对创作者与技术生态的双重影响。

Salesforce 3.75亿美元收购Rune,AI物流技术补强国防业务
Salesforce 据报道以 3.75 亿美元收购国防科技初创公司 Rune,这家 AI 物流公司的技术将用于补强 Salesforce 的 Missionforce 国防平台,也延续了 Salesforce 近期的并购节奏。

Mistral Large 4开源万亿参数,微软6万员工自愿离职
Mistral Large 4 开源万亿参数多模态模型,编码智能体评测得分 48;闪迪财报显示 AI 推理重塑 NAND 需求;谷歌 Gemini 上线应用内文件编辑,OpenAI 上调 Codex 额度,微软向 6 万员工提供自愿离职方案。