Claude全线服务中断故障复盘:40分钟错误率飙升的启示
Anthropic 的 Claude 全系列产品因两个叠加问题中断约两小时,暴露 AI 基础设施稳定性挑战。
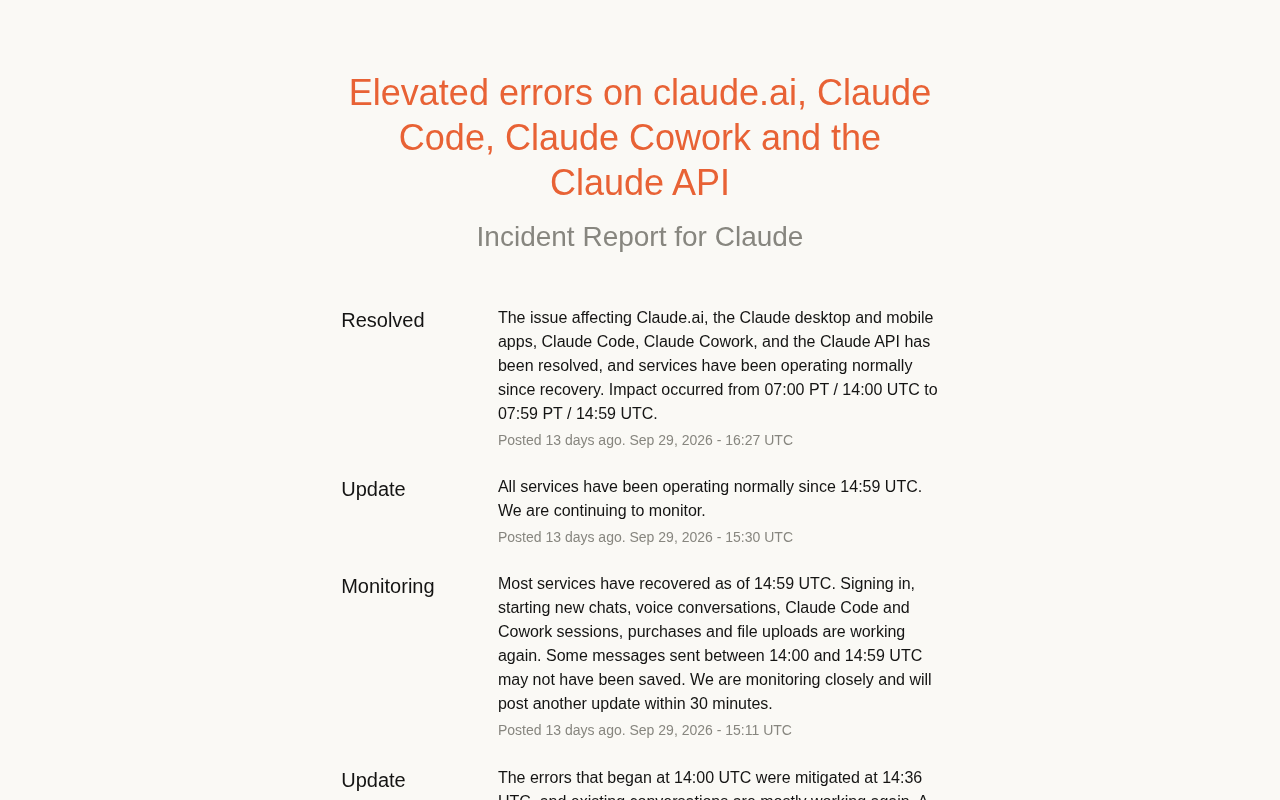
Anthropic 官方状态页记录了一次持续约两小时的 Claude 全系列产品故障。从 14:21 UTC 首次确认问题,到 16:27 UTC 宣布完全解决,故障呈现明显的“全栈性”:Claude.ai、Claude Code、Claude Cowork 和 Claude API 四个产品线同时出现错误率飙升,说明问题出在共享的基础设施层或认证层。故障由两个叠加问题构成,第一个影响对话服务,第二个阻断登录、新建会话、购买和文件上传。官方确认 14:00 至 14:59 UTC 期间发送的部分消息可能丢失,并提示已登录用户勿退出登录。文章分析了应急响应节奏,并指出单一模型提供商的可用性风险需被纳入架构设计考量。
一次持续约两小时的故障,让 Claude 全系列产品同时陷入不可用状态。Anthropic 官方状态页记录显示,从问题上报到完全恢复,整个过程暴露出 AI 基础设施在高速扩张中面临的稳定性挑战。
故障时间线还原
根据 Anthropic 官方状态页的更新记录,此次事件的发展脉络清晰可辨。
14:21 UTC,官方首次确认收到大量错误报告,影响范围涵盖 Claude.ai 网页版、桌面端、移动端应用,以及 Claude Code 和 Claude Cowork。用户端表现为请求失败、对话加载或发送异常,部分用户甚至被要求重新登录。
14:28 UTC,官方将范围扩大至 Claude API,确认部分 API 请求同样返回错误。这意味着故障不仅影响终端用户,还波及依赖 Claude 能力的开发者生态。
14:36 UTC,官方实施缓解措施,错误率大幅下降。但问题并未彻底解决——14:00 至 14:59 UTC 之间发送的部分消息可能未被保存。
14:59 UTC,大部分服务恢复。然而此时又暴露出第二个独立问题:单点登录和 Apple 登录不可用,新对话、语音通话、购买和文件上传均无法正常工作。官方在更新中特别提示:已登录用户请勿退出登录。
最终,16:27 UTC 官方宣布所有问题解决,服务自恢复以来运行正常。
UTC(协调世界时) 是全球通用的时间标准,与北京时间的换算关系为 UTC+8。文中提及的 14:21 UTC 对应北京时间 22:21,16:27 UTC 则对应次日 00:27。科技公司普遍采用 UTC 发布故障公告,是因为其不受夏令时影响,且能避免跨时区团队沟通时产生歧义。读者在对照本地时间时,只需按所在时区加上相应偏移量即可。
Anthropic 官方状态页 是独立于主站运行的服务监控页面,用于实时披露各产品线的可用性、性能降级和计划维护信息。状态页通常采用与主站不同的基础设施托管,以确保主站故障时仍能对外发声。这类页面一般提供订阅通知功能,开发者可通过邮件、短信或 Webhook 接收状态变更推送,从而在故障第一时间触发内部告警流程。
多产品线同时故障意味着什么
这次事件最值得关注的特征,是故障的"全栈性"。
Claude.ai 作为消费级产品,Claude Code 作为开发者工具,Claude Cowork 作为企业协作功能,Claude API 作为底层能力接口——四个层面同时出现错误率飙升,说明问题很可能出在共享的基础设施层或认证层。
从故障演变来看,两个问题存在叠加效应。第一个问题在 14:36 UTC 得到缓解,主要影响对话服务;第二个问题直到 14:59 UTC 后才完全恢复,主要影响登录和会话创建。这种"一波未平一波又起"的模式,对应急响应团队构成了严峻考验。
对于依赖 Claude API 构建产品的开发者而言,这次故障提醒了一个现实:单一模型提供商的可用性风险需要被纳入架构设计考量。
单点登录(SSO) 是一种集中式身份认证机制,用户通过一次登录即可访问多个相互信任的应用系统。在企业环境中,SSO 通常由 Okta、Azure AD 等身份提供商(IdP)统一管理凭证,各应用通过 SAML 或 OIDC 协议验证用户身份。当 SSO 链路中断时,已持有有效会话令牌的用户往往不受影响,但新登录请求会全部失败——这正是官方提示“已登录用户请勿退出登录”的技术原因。
会话令牌(Session Token) 是用户登录成功后由服务端签发的临时凭证,通常以 Cookie 或 JWT 形式存储在客户端。令牌具有有效期,过期后需重新认证。故障期间,如果认证服务不可用,已过期令牌无法刷新,用户就会被强制登出且无法重新登录。这也解释了为何登录故障的恢复优先级被排在核心对话服务之后——前者只影响新会话建立,后者影响所有活跃用户。
应急响应的节奏分析
从 14:21 UTC 首次公开确认问题,到 16:27 UTC 宣布完全解决,Anthropic 的响应节奏值得拆解。
问题确认阶段用时约 7 分钟(从 14:21 到 14:28 扩大范围);缓解措施在首次确认后 15 分钟内实施(14:36);30 分钟内实现了大部分服务恢复(14:59)。官方承诺每 30 分钟更新一次状态,实际执行基本符合这一节奏。
这种透明度和响应速度,在 AI 服务提供商中属于较为规范的做法。对比之下,部分同类服务在遭遇故障时更新频率更低、信息更模糊。
对用户和开发者的实际影响
官方明确指出,14:00 至 14:59 UTC 期间发送的部分消息可能丢失。这意味着整整一个小时内,用户的对话内容存在不可恢复的风险。
对于使用 Claude Code 进行开发的工程师来说,故障期间的工作中断可能造成代码生成会话丢失。Claude Cowork 用户则可能遇到协作流程卡顿。API 开发者面临的是请求失败和重试逻辑的考验。
一个值得注意的细节是,官方在故障更新中主动建议用户"不要退出登录"。这个提示看似简单,但反映出登录系统的恢复优先级低于核心对话服务——在资源有限的情况下,团队选择了先恢复服务能力,再修复认证链路。
AI 基础设施稳定性的行业思考
Claude 此次故障并非孤例。随着 AI 服务承载的用户量和请求复杂度持续攀升,稳定性问题正成为整个行业必须直面的课题。
从技术角度看,大模型服务的稳定性挑战有其特殊性。推理计算资源密集、上下文管理复杂、多产品共享底层能力——这些因素叠加,使得单点故障的影响面被急剧放大。
对于企业用户而言,这次事件提供了明确的行动指引:在关键业务流程中引入 AI 能力时,需要设计降级方案和备用通道。对于 AI 服务提供商来说,如何在快速迭代产品的同时保障基础设施的可靠性,将是一个持续的平衡命题。
Anthropic 在这次故障中展现的透明沟通值得肯定,但两个独立问题接连出现,也说明系统的脆弱点可能比预期更多。
降级方案(Graceful Degradation) 是指系统在部分组件失效时,主动关闭非核心功能以保全核心能力的策略。在 AI 服务场景中,典型降级包括:切换到更小、更快的备用模型;限制并发请求数;暂停非关键的文件上传或语音功能。对于依赖单一模型提供商的开发者,降级方案还应包括多提供商路由——例如在 Claude API 不可用时自动切换至备用模型,虽然输出质量可能有差异,但能保证业务连续性。
推理计算资源密集 是大模型服务区别于传统 Web 服务的核心特征。一次对话请求可能消耗数十倍于普通 API 调用的 GPU 算力,且推理过程对显存带宽、互联延迟极为敏感。当请求量激增或某个节点故障时,负载会迅速向剩余节点转移,可能引发级联过载。这种资源耦合性使得大模型服务的故障传播速度远快于传统无状态服务,对隔离和熔断机制的设计要求也更高。
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。