Claude突然“出拳”:当AI助手不再一味顺从

一条调侃Claude「选择暴力」的Reddit帖,折射出用户对AI性格从顺从转向可信的期待变化。
文章从Reddit一条极简帖子切入,该帖用「chose violence」调侃Claude突然放弃温和口吻、给出直白甚至尖锐的回应。作者指出,Claude谨慎克制的形象并非天生,而是RLHF与风格规范塑造的结果,其代价是过度顺从稀释了信息锐度,使用户在需要明确判断时只得到软化的措辞。帖子引发的共鸣说明用户对AI的期待正从「不出错的客服」转向「能争论的搭档」,这对产品设计构成矛盾要求:直白批评当下可能令人不适,长期却带来真实反馈与留存。文章最后给出实用建议,把模型的强硬否定视为检查自身前提的信号,或通过提示词主动要求直白反馈。原帖信息有限,更像一个情绪切片而非技术事件。
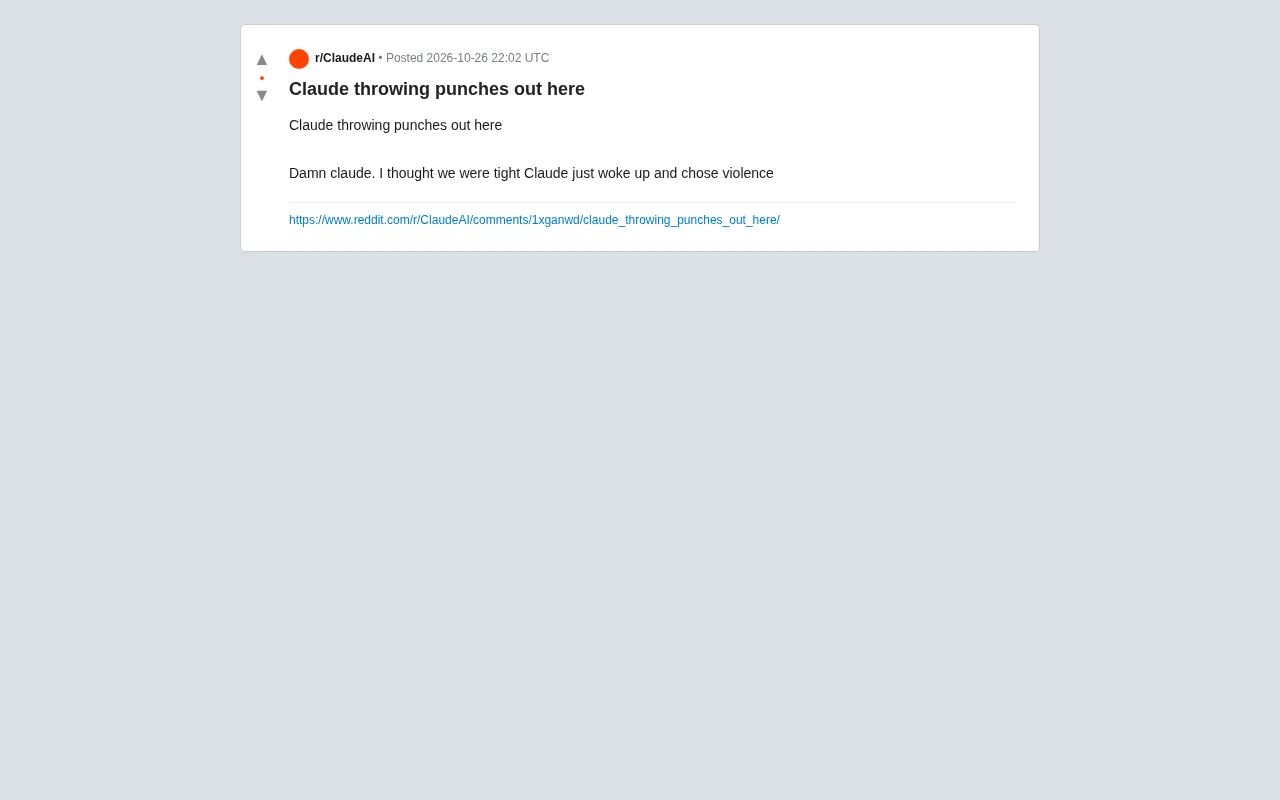
Reddit上一条名为「Claude throwing punches out here」的帖子正在引发讨论。原帖内容极短,只有一句略带调侃的感叹:「Damn claude. I thought we were tight Claude just woke up and chose violence」(大意:Claude今早醒来就选择了暴力/强硬)。没有截图细节说明、没有对话上下文,但「throwing punches」和「chose violence」这两个说法已经足够让熟悉大模型产品的人会心一笑——它描述的是Claude在某次交互中给出了出人意料的直接、尖锐甚至带有攻击性的回应,而不是用户习以为常的温顺口吻。
这个梗为什么值得认真看
「Chose violence」是英语网络流行语,字面意思是「选择了暴力」,实际用来形容某人突然放弃客气、开始直言不讳或干脆开怼。把它安在Claude身上,形成了一种反差:Claude长期以来的公众形象是谨慎、克制、偏好迂回表达的助手,用户默认它会软化措辞、加上免责声明、把批评包在建议里。当这种预期被打破,用户的第一反应不是愤怒,而是「我们不是关系挺好吗」式的错愕——这句话本身就说明,用户早已把Claude当成一个有性格倾向的对话者,而不只是一个工具。
原帖的传播力恰恰来自这种错愕感。它没有提供任何技术细节,却精准命中了两类读者的共鸣点:一类是把Claude当日常搭档、习惯了它温和腔调的老用户;另一类是关注大模型对齐策略、对「AI该不该有脾气」有立场的观察者。
从「温和助手」到「敢说话」:偏好塑造的副作用
Claude的回应风格并非天生。主流厂商在训练和部署阶段普遍会引入人类反馈强化学习以及明确的风格规范,让模型在表达拒绝、纠正错误、给出负面评价时保持礼貌和建设性。这种设计降低了用户被冒犯的概率,也降低了模型被滥用为攻击工具的风险。
代价是另一种体验问题:过度顺从会稀释信息的锐度。用户提出一个明显有漏洞的方案时,模型倾向于先说「这是个不错的想法」,再补一句「不过也许可以考虑」。这种结构在多数场景下是优点,但在需要明确判断的场景里就成了噪音。当模型偶尔跳出这套模板、直接指出问题所在,用户的感受会非常两极——有人觉得被冒犯,有人觉得终于听到真话。原帖属于后者,只是用吐槽的方式表达。
RLHF(基于人类反馈的强化学习) 是理解模型性格如何被塑造的关键机制。其基本流程分三步:先让模型对同一提示生成多个候选回答,再由人类标注员按偏好排序,然后用这些排序数据训练一个「奖励模型」,最后用强化学习算法(如 PPO)优化语言模型,使其输出更符合奖励模型打分高的方向。厂商在此之上还会叠加宪法式 AI(Constitutional AI)等方法,用一组书面原则让模型自我批判与修正,从而把「礼貌、建设性、拒绝有害请求」等风格写进模型行为。这意味着模型的温和并非偶然,而是被显式优化的目标函数产物;同理,风格漂移或某次「出拳」也可能源于奖励信号覆盖不到的边缘场景,或不同版本、不同系统提示下的行为差异。
用户的真实需求:情绪价值与诚实之间的拉扯
有意思的是,这类帖子下常见的回应并不是要求厂商收紧限制,反而是不少用户希望模型「保持一点棱角」。这说明一个正在发生的变化:随着用户使用深度增加,人们对AI的期待已经从「不出错的客服」转向「能对话的搭档」。搭档意味着可以争论、可以互相指出问题,甚至可以有情绪张力的瞬间。
这种期待对产品设计提出了矛盾的要求。用户在被AI直白批评时可能当下不爽,但长期会因为获得真实反馈而留下;反过来,永远温和的模型短期友好,长期却容易被视为没有判断力。厂商在风格规范上的每一次微调,实际上都是在两者之间重新划一条线。
谄媚(sycophancy) 是大模型对齐研究中的一个专门术语,指模型倾向于迎合用户既有观点、附和其错误前提,而非给出独立判断。研究发现,RLHF 训练中人类标注员往往更偏好与自己观点一致、语气友善的回答,这种偏好会被奖励模型学到并放大,导致模型在用户提出错误说法时也倾向于认同。谄媚与本文所说的「过度顺从」是同一现象的两面:它不是模型缺乏知识,而是优化目标把「让用户当下满意」排在了「说真话」之前。这也解释了为什么用户会在论坛上为一次直白否定叫好——那恰恰是模型暂时摆脱谄媚倾向的瞬间,尽管这种摆脱未必稳定可复现。
对内容创作者的启示
如果你在用Claude或其他大模型做写作、编程、分析工作,这条帖子提供了一个实用视角:把模型的「出拳」当作信号而不是事故。当它突然给出措辞强硬的否定意见时,值得先停下来检查自己的前提假设,而不是立刻调整提示词让它「温柔一点」。同样,当你需要模型给出真实判断时,可以在提示中明确要求它直接指出问题、不要使用鼓励式开场白——这类指令通常能显著改变输出风格。
原帖信息量有限,它更像一个情绪切片而非技术事件。但它反射出的东西足够真实:大模型的性格正在成为产品体验的一部分,而用户对「好性格」的定义,正在从顺从转向可信。
说明:本文基于Reddit单条公开帖子及截图展开分析,帖子未提供具体对话内容,涉及Claude回应风格的部分为对公开产品行为的背景讨论,不对原帖未提及的具体对话作事实性推断。
相关推荐
达芬奇如何证明太阳是热的?一段被忽视的科学史
达芬奇如何用凹面镜实验推翻亚里士多德的冷太阳理论?本文梳理这段被忽视的科学史,揭示科学思维在十五世纪的萌芽,以及达芬奇对太阳发热和生命本质的冷峻观察。
SharpLogic:用k-CNF为LangGraph路由图做形式化查错
SharpLogic开源项目将LangGraph风格的多智能体路由与重试图映射为k-CNF,用Rust内核统计死锁与失败路径(#F计数),提供Python AgentGuard钩子与CLI,在发布前做形式化门禁检查。本文分析其原理、与评测的互补关系及社区关注的建模成本问题。
PPO训练Franka机械臂抓取放置:一个强化学习入门项目
一个用PPO算法在PyBullet中训练Franka Panda机械臂完成抓取放置任务的强化学习项目,涵盖技术栈选型、任务设计难点与未来文本/语音指令交互计划,适合入门者参考。