Claude新技能:让模型自己评估对话安全

Anthropic 让 Claude 回复后自评对话安全性,以模型判断力替代外部分类器。
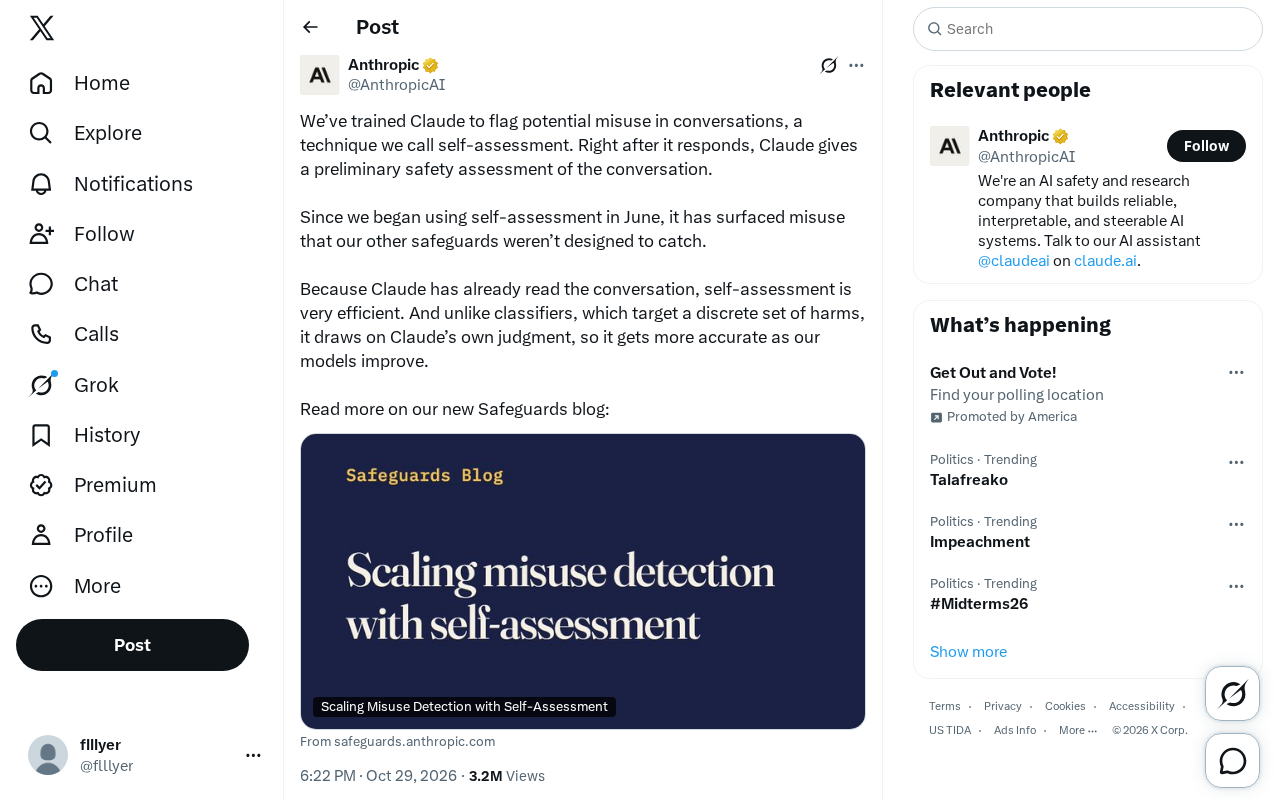
Anthropic 为 Claude 训练了 self-assessment 能力:每次回复后对整段对话做一次初步安全评估,直接调用模型自身判断力识别潜在滥用,而非依赖外部分类器。由于 Claude 已完整读过上下文,自我评估比只覆盖离散危害类型的分类器更高效、覆盖面更广,且准确率会随模型能力提升同步提高,无需单独迭代。自 6 月启用以来,该机制标记出了其他安全措施原本未能捕捉的滥用行为。但文章也指出其局限:模型评估自身对话存在自我一致偏差风险,Anthropic 未披露误报率、漏报率与人工复核比例,额外模型调用带来的成本与延迟在大规模部署下仍是未知数,其可信度最终取决于可验证性。
Anthropic 为 Claude 训练了一项新能力:在每次回复后,对整段对话做一次初步的安全评估,他们把这套机制称为 self-assessment(自我评估)。与依赖外部分类器的传统做法不同,它直接调用模型自身的判断力来识别潜在滥用。
自我评估是怎么工作的
按照 Anthropic 在 X 上的说明,Claude 在给出回答之后,会紧接着对当前对话做一次安全性初判。这相当于在正常交互流程里嵌入了一个轻量的"自检"环节,而不是把内容再送去一个独立的安全模型打分。
关键区别在于信息基础。Claude 已经完整读过上下文,自我评估因此非常高效;相比之下,针对特定危害类型训练的分类器只覆盖离散的一小组风险,难以泛化到新出现的滥用形态。
从分类器到模型判断力
传统安全分类器的思路是"枚举危害、分别建模",问题在于覆盖面永远滞后于实际滥用。自我评估把判断权交回给模型本身,优点是它能利用对语义和意图的整体理解。
Anthropic 明确表示,随着模型能力提升,这套机制的准确率也会随之提高——安全能力与模型能力同步演进,而不是像固定分类器那样需要反复单独迭代。这一点在工程上很有吸引力:模型变强,安全判断自动受益。
安全分类器(safety classifier) 是一类独立训练的小型模型,输入是待检测的文本,输出是「是否属于某类危害」的标签或分数,常见于内容审核流水线。它的训练依赖人工标注的危害样本,因此每个分类器通常只对应一种或少数几种风险(如仇恨言论、自伤、违法行为),危害类型之间难以共享语义理解。这种「枚举式」设计带来两个固有问题:一是覆盖面受限于标注时已知的危害清单,遇到新形态滥用只能重新标注、重新训练;二是分类器看到的往往只是单条消息,缺乏对话历史,容易把语境中的反讽、引用或教育性讨论误判为真实危害。自我评估的思路正是用具备完整上下文的主模型替代这类外挂分类器,以语义理解换取更强的泛化能力。
上线后的实际发现
自 6 月开始启用自我评估以来,它已经标记出其他安全措施原本无意捕捉的滥用行为。这个表述值得注意——它不是说替代了现有防护,而是补上了既有体系之外的盲区。
对于安全团队而言,这类"意外发现"本身就是价值证明:真正的滥用往往出现在分类器设计时没想到的地方,而具备上下文理解能力的模型自检更容易察觉到异常模式。
局限与待观察的问题
自我评估并非万能。让模型评估自己的对话,天然存在自我一致偏差的风险——它可能倾向于认为自己的回复没有问题。Anthropic 没有在这条推文中披露误报率、漏报率或人工复核比例等细节,仅指向其 Safeguards 博客供进一步阅读。
另一个未解的问题是成本与延迟。虽然推文强调"高效",但每个回合额外增加一次模型调用,对大规模部署仍意味着实打实的开销。这套机制能否在真实流量下稳定运行,还需要更多公开数据支撑。
自我一致偏差(self-consistency bias) 指模型在评估自身输出时,倾向于给出与既有判断一致的结论,从而系统性低估自己的错误。这与人类评审中的「自评偏高」现象类似,根源在于模型对自身生成内容的概率分布更「熟悉」,也更难对其提出否定判断。在安全场景下,这种偏差的直接后果是漏报率被低估:真正危险的回复可能被模型自己判定为无害。缓解手段通常包括引入独立评审模型、对自我评估结果做抽样人工复核,或让模型在评估时使用与生成阶段不同的提示与角色设定。文章提到 Anthropic 未披露误报率与漏报率,这意味着自我一致偏差的实际影响目前仍无法从公开信息中量化。
对行业的意义
把安全判断内化为模型能力的一部分,是当前 AI 安全工程的一条重要思路转向。从外部规则和分类器,走向利用模型自身理解力的自适应防护,这条路如果走通,对快速迭代的模型产品尤其友好。
但它的可信度最终取决于可验证性。自我评估标出的内容如何被人工审查、如何与现有拦截策略联动、误判时如何纠正,这些工程细节决定了它是一项实质性的安全增强,还是一个漂亮的演示。
可验证性(verifiability) 在 AI 安全工程中指的是一项防护措施的效果能否被外部独立测量与复现,通常需要公开误报率、漏报率、测试集构成以及人工复核流程。对于自我评估这类「模型评判模型」的机制,可验证性尤其关键:因为评估方与被评估方同源,外部无法仅凭机制描述判断其可靠性,必须依赖量化指标和第三方红队测试。缺乏这些数据时,安全增强与营销演示在外观上难以区分。行业实践中,可验证性通常通过标准化基准(如危害分类测试集)、公开的滥用拦截统计以及可审计的日志来实现,这也是判断自我评估能否从概念走向工程化部署的核心门槛。
相关推荐

Claude用梗造了个编程语言:Memesis让AI智能体安全"整活"
开发者借助 Claude Code 打造了 AI 智能体专用编程语言 Memesis,用网络梗作为关键字,内置 sus/yolo 安全机制,开源且可本地运行。

数字身份新变革:如何拥有并治理你的AI分身
数字身份正在转向AI分身时代。本文结合Reddit社区讨论,解析AI分身的拥有权归属、数据与模型控制、以及权限分级、行为审计、身份标识等治理机制,探讨普通人如何拥有并治理自己的AI分身。

Megatron-LM MoE训练手册:逐项配置实战指南
Hugging Face发布MoE训练手册,基于约80万GH200 GPU小时经验,逐项讲解Megatron-LM配置:从稠密基线到MoE层拆解、路由与负载均衡,附开源脚本和55张图表。