Claude一句话生成10款网页游戏:AI编程实战全过程

从一句话到一个游戏:AI编程的真实体验
当有人说"AI能写代码"时,很多人的第一反应是半信半疑。但如果你亲眼看到一个人不写一行代码,仅靠自然语言描述,就在几十分钟内让AI生成了10款可运行的网页小游戏,并部署到了公网上——你的认知可能会被彻底刷新。
这正是一位B站UP主在直播中做的事情。他使用Claude的命令行模式(Claude Code),通过一句话提示词,逐一生成了2048、五子棋、俄罗斯方块、像素飞鸟等10款经典小游戏,最后还做了一个游戏大厅页面,并一键部署到GitHub Pages。整个过程中,他没有手写任何代码,所有HTML、CSS、JavaScript均由AI自动生成。
这里需要解释一下Claude Code的工作方式。与我们熟悉的网页聊天界面不同,Claude Code允许开发者在终端(Terminal)中直接与AI对话,AI可以读取本地文件系统、创建和修改文件、执行Shell命令,甚至直接运行Git操作。它不只是给出代码片段让你复制粘贴,而是直接在你的项目目录中创建文件、写入完整代码。这种"代理式编程"(Agentic Coding)模式是2024-2025年AI编程工具的核心趋势,Cursor、Windsurf、GitHub Copilot等工具也在朝类似方向演进。
实战过程:一句话提示词生成完整游戏
2048游戏:1-3分钟搞定
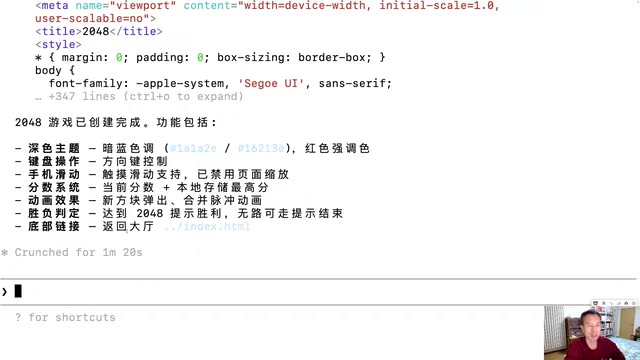
第一个游戏是经典的2048。UP主在Claude的命令行输入框中输入了一段中文提示:
"在01-2048目录下做一个2048游戏,网页版,深色主题,支持键盘方向和手机滑动操作,底部返回大厅链接index.html"
没有任何技术术语,没有提到"二维数组存储棋盘数据"之类的实现细节。1到3分钟后,Claude就完成了代码编写,生成了一个单文件HTML。打开浏览器测试,游戏逻辑完全正确——数字滑动、合并、得分,一切运转正常。
所谓"单文件HTML",是指将HTML结构、CSS样式和JavaScript逻辑全部写在一个.html文件中,浏览器可以直接打开运行,无需任何构建工具、服务器或依赖安装。对于小型游戏和演示项目来说,这是最轻量的方案,也是这些游戏能直接部署到静态托管服务上的关键——不需要后端服务器支撑。
五子棋:AI自主选择博弈算法
第二个游戏是五子棋,要求人机对战,用Canvas绘制棋盘,玩家执黑,AI执白,且AI要有基本的攻防策略。
有意思的是,UP主并没有指定AI应该用什么算法来实现"攻防策略"。他说:"至于AI用什么算法,我也没提,这些就让大模型自己决定。正常我们自己得冥思苦想怎么做一个能跟我们下棋的算法。"
实测结果表明,生成的AI对手并不傻——如果随便下,很快就会输。这说明Claude在没有明确指令的情况下,自主选择了合理的博弈算法。在博弈论领域,棋类AI通常采用Minimax(极小化极大)算法配合Alpha-Beta剪枝来实现决策——假设对手总会选择对我最不利的走法,我则选择在最坏情况下仍然最优的走法。对于五子棋这类棋盘较大的游戏,还常配合启发式评估函数,对棋盘局面打分,评估连子数、活三、冲四等棋型的威胁程度。Claude的训练数据中包含大量博弈算法的教程和开源实现,因此它能在没有明确指令的情况下综合运用这些经典算法,生成具备真实攻防能力的AI对手。

俄罗斯方块与像素飞鸟:复杂逻辑验证通过
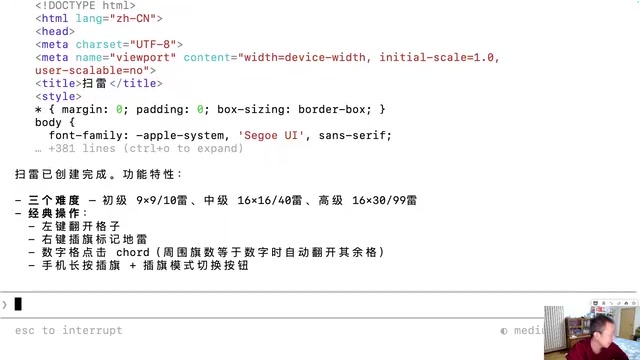
俄罗斯方块要求Canvas绘制、七种经典方块、方向键控制、满行消除、显示分数和下一个方块预览。测试中,消除逻辑和得分系统均正常工作。这里提到的Canvas是浏览器内置的2D绘图API,配合requestAnimationFrame实现逐帧渲染,足以支撑这类游戏的图形需求。
像素飞鸟(Flappy Bird)则涉及更复杂的物理模拟——重力、跳跃、碰撞检测。UP主分析道:"每一帧给小鸟一个向下的速度模拟重力,点屏幕给一个向上的瞬时速度,两个叠加形成抛物线。"
这段分析涉及游戏开发中最基础的运动学模型——欧拉积分法。具体来说,游戏以每秒60帧的速率运行,每一帧中小鸟的垂直速度会增加一个固定的重力加速度值,模拟自由落体效果。当玩家点击屏幕时,垂直速度被瞬间设置为一个负值(向上),与持续向下的重力叠加,自然形成抛物线轨迹。碰撞检测则采用AABB(轴对齐包围盒)算法,检测小鸟的矩形区域是否与管道或地面的矩形区域重叠。这套物理系统虽然看似简单,但涉及状态管理、帧率控制、碰撞响应等多个子系统的协调,能一次性正确生成说明AI对游戏循环架构有完整的理解。
游戏大厅与GitHub Pages一键部署
10款游戏全部完成后,UP主用一段稍长的提示词让Claude生成了一个游戏大厅页面——深色科技风格,顶部有统计信息,集成了所有10款游戏的入口链接。
最后一步是部署。他让Claude初始化Git仓库、添加所有文件、推送到GitHub并开启Pages服务。GitHub Pages是GitHub提供的免费静态网站托管服务,用户只需将HTML、CSS、JavaScript等静态文件推送到GitHub仓库的特定分支,GitHub就会自动将其发布为一个公网可访问的网站,域名格式为username.github.io/repository-name。整个过程不需要购买服务器、配置域名解析或安装任何运行环境。Claude执行git init、git add、git commit、git push等命令,再通过GitHub API开启Pages功能,几分钟后一个公网可访问的游戏合集就上线了,直播间的观众可以直接用手机打开体验。
AI编程的真实边界:能做什么,不能做什么
一句话提示词的固有局限
UP主反复强调一个关键点:一句话提示词生成的结果必然有很多不完善的地方。UI适配不够好、全屏显示有问题、可玩性有限——这些都是一句话提示的固有局限。
"如果我们想做得更好,必然需要迭代。根据目前效果提出修改意见,AI再去修改完善,这个过程如果真正做产品,肯定是反反复复的。"
他也坦言:"你让AI一句话写一个B站出来、写一个QQ出来,这不现实。现实产品太复杂——前后端、用户系统、数据库、支付,每一个模块都会遇到各种问题。"
值得注意的是,虽然UP主的提示词看似简单(一句话),但实际上包含了精确的需求要素:目标目录、游戏类型、技术方案(网页版)、视觉风格(深色主题)、交互方式(键盘+触屏)、导航结构(返回大厅链接)。这种能力在AI时代被称为"提示词工程"(Prompt Engineering),本质上是需求分析和系统设计能力的自然语言表达。好的提示词不需要写技术实现细节,但必须清晰定义"做什么"和"约束条件"。这与传统软件工程中产品经理撰写PRD(产品需求文档)的能力高度重合,也印证了UP主"每个人都可能是架构师"的观点。
从代码执行者到AI指挥者
这场演示真正想传递的信息不是"AI多强大",而是角色转变:程序员从代码执行者变成了AI指挥者。
"以前是需要我们去写代码、自己去调试,但现在这个过程变成了AI来做,我来指挥就OK了。每个人都可能是一个架构师。"
但这并不意味着门槛降低了。恰恰相反,对人的综合能力要求实际上更高了:
- 以前:会一门语言就行,会前端就行,会后端就行
- 现在:你要懂数据库、懂人工智能、懂大数据、懂Python,还要懂业务
"AI能把代码写出来,但你要告诉它你的业务是什么、需求是什么,出现问题后架构怎么调整。这些AI做不了,这才是人的价值。"
这种转变在软件工程领域有一个更深层的含义:过去,编程能力的核心是"实现能力"——把设计好的逻辑翻译成代码。而现在,AI接管了翻译环节,人的核心能力转向了"设计能力"和"判断能力"——能否正确拆解一个复杂系统、能否识别AI生成代码中的潜在问题、能否在多种技术方案中做出合理选择。这也解释了为什么UP主说"综合能力要求更高了":你不再需要记住某个API的参数顺序,但你必须理解整个系统的运作原理。

工具选择:驾驭AI的方法论比模型更重要
关于工具选择,UP主的观点很务实:
- Claude编程能力和推理能力确实强大,他个人每月付费200美元的顶级套餐(即Claude Max计划,提供大幅提升的使用量上限和优先访问最新模型的权限),"当员工用"
- 国产大模型也不差,对于入门学习完全够用,免费方案就OK
- 除非有明确的产品开发或工作用途,否则不必追求最贵的工具
他的核心观点是:模型本身不重要,驾驭AI的方法论才重要。"无论什么工具我们都要会用,有钱有需求就花钱,没有就用免费的。初学者关注的不应该是工具能力本身,而是方法论。"
这个观点背后有一个重要的行业趋势:大模型的能力差距正在快速缩小。2023年时,GPT-4在编程任务上遥遥领先,但到2025年,Claude、Gemini、DeepSeek广告、Qwen等模型在代码生成质量上已经非常接近。当模型能力趋于同质化,真正拉开差距的就是使用者的方法论——如何拆解需求、如何设计提示词、如何迭代优化、如何验证结果。这与摄影领域的道理类似:器材固然重要,但构图、光线、时机的把握才是决定作品质量的关键。
结语:AI时代的编程认知升级
这场直播的本质不是一次技术炫技,而是一次"认知对齐"。UP主在开场时问观众:"AI到底能不能独立写出程序员级别的代码?"在演示结束后,他给出了自己的答案:
AI不是万能的,但已经是一个极强的编程工具。 关键不在于AI能不能做到,而在于我们怎么指挥——怎么拆解需求、怎么设计架构、怎么迭代优化。
学编程的方式已经彻底变了。以前入门极其困难,现在方式方法完全不同,关注点也变了。但变简单的只是代码编写本身,对综合能力的要求反而更高了。在AI时代,做一个好的"指挥官",比做一个好的"码农"更有价值。
相关推荐
B站最细Codex保姆级攻略:从安装到实战全解析
B站最细Codex保姆级攻略:从应用商店安装到日常工作模式配置,用真实咖啡馆项目演示文件整理、数据提取、仪表盘制作等实战任务,教你用计划模式和桌面宠物高效使用Codex。

体渲染中的外观补偿:为何RGB准确无法保证密度正确
体渲染研究揭示:完美复现外部RGB视图的体数据仍可能存在密度错误。外观补偿机制使中心密度翻倍、L2误差超14.52%时外部射线仍不变,密度恢复依赖外观容量、空间分辨率与测量设计。

TMLE与AIPW的样本分割选择:交叉拟合与重复分割的影响
一项TMLE与AIPW模拟研究发现,样本分割方式显著影响区间覆盖率:样本内拟合倾向得分可使覆盖率跌至0.12-0.48,双nuisance交叉拟合则恢复至0.91-1.00;近正性下AIPW优于未加权TMLE,重复划分降低划分依赖但使区间更保守。