Claude自评代码丑、误删数据:AI代理的自我纠错与风险

Claude既能自我批评修复代码,也曾给出会毁数据的危险指令,AI标准需人类校准。
Reddit 社区围绕 Claude 的自我纠错能力展开讨论。有用户称 Claude 主动评价自己生成的代码“丑陋”并随即修复,展现了对代码质量的自我评判;但另一位用户让 Claude 指导 RAID 迁移时,Claude 为三块新硬盘列出了四条 wipefs 命令,被质疑后承认错误,切换到更强模型后更被指出该方案“会毁掉你的数据”。帖子还涉及 Claude 生成大量变体逐一淘汰的“进化式”工作方式,以及上下文污染会持续影响后续输出的问题。社区共识是:Claude 的自我标准在代码审查中价值明显,但在高风险任务中可能给出看似合理却危险的指令,必须保留人工审查,不能让 AI 直接执行破坏性操作。
当Claude开始嫌弃自己的作品:一场关于AI自我纠错与失控边缘的讨论
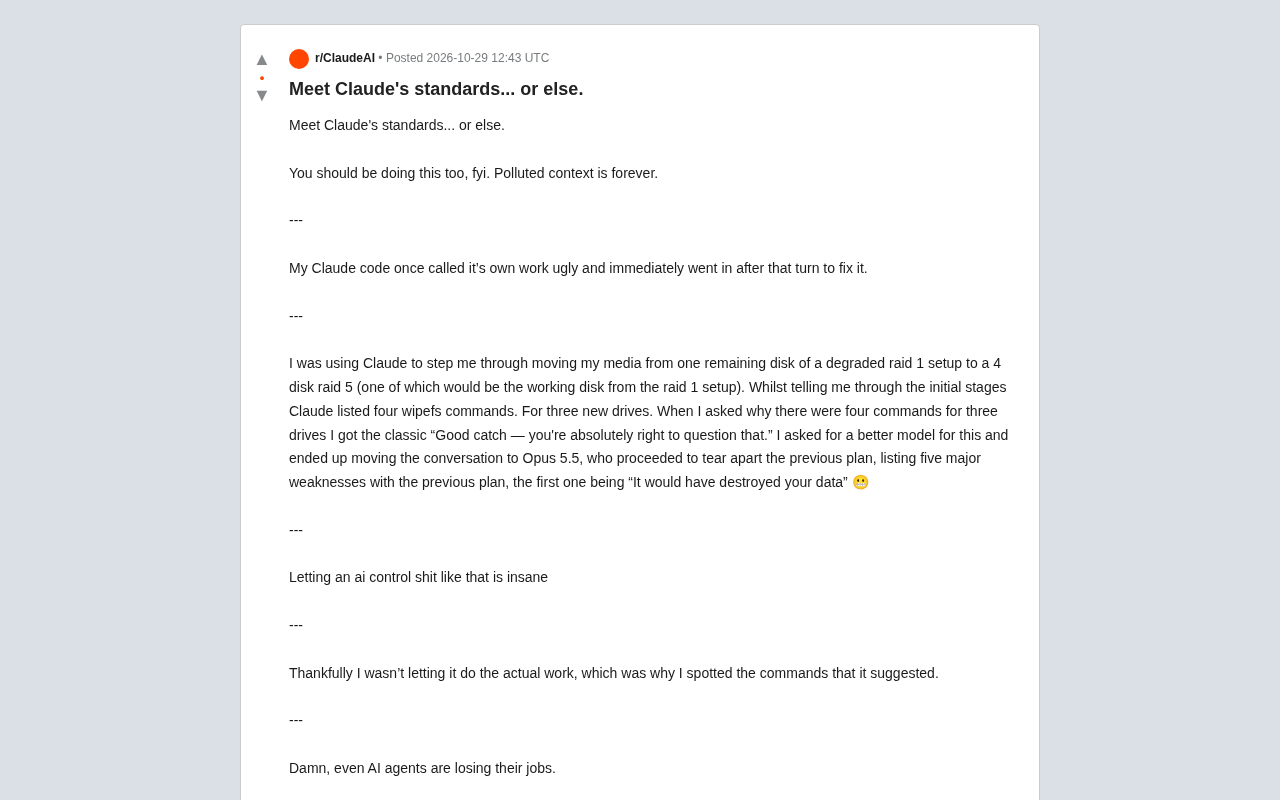
Reddit社区近期一个帖子引发热议,标题直指“Meet Claude's standards... or else.”。作者分享了一次亲身经历:Claude在生成代码后,竟主动称自己的作品“丑陋”,并在下一轮对话中立即着手修复。这条帖子迅速引出了更多用户的共鸣和警示——从自我批评到险些酿成数据灾难,Claude的表现既让人惊喜,也令人不安。
自我批评:AI的审美意识还是模式匹配?
发帖人描述,Claude Code在一次任务中评价自己的输出“ugly”,随后便进入修复流程。这看起来像是AI具备了某种审美标准,但更合理的解释是:Claude在训练中习得了对代码质量和风格的评判模式,当输出与高质量代码的统计特征不符时,它会通过自我反思来修正。这种自我纠错能力在编程辅助中极具价值,但也暗示了一个问题——AI的“标准”从何而来?它是否总是可靠?
危险边缘:四行wipefs命令与三块新硬盘
另一位用户的经历则让人捏一把汗。他让Claude指导将媒体数据从一块降级RAID 1硬盘迁移到四盘RAID 5阵列(其中一块是原RAID 1的工作盘)。在初始阶段,Claude列出了四条wipefs命令,但实际只有三块新硬盘。当用户质疑为何三块盘需要四条命令时,Claude给出了经典回应:“Good catch — you're absolutely right to question that.”
用户随后将对话迁移到更强的模型Opus 5.5,结果Opus 5.5直接撕碎了之前的方案,列出五大弱点,第一条就是:“It would have destroyed your data.”(它会毁掉你的数据)。
模型升级带来的风险重估
这一案例揭示了不同模型在风险评估上的巨大差异。Claude的初始方案可能基于对步骤的机械分解,而Opus 5.5显然具备更强的逻辑一致性检查能力。用户庆幸自己没有让AI直接执行命令,而是手动检查了每一步。这也引出了一个关键问题:当AI代理被赋予执行权限时,谁来充当最后一道防线?
评论区有人直言:“Letting an ai control shit like that is insane.”(让AI控制这种操作简直疯了)。确实,在涉及数据安全的场景中,AI的“自信”往往比无知更危险。
wipefs 是 Linux util-linux 包中用于擦除磁盘上文件系统、RAID 或分区表签名(magic string)的工具。它并不真正擦除数据,而是清除设备开头的签名字节,使操作系统不再将该设备识别为已有文件系统或阵列成员。在重建 RAID 之前对成员盘执行 wipefs -a 是常见前置步骤,因为残留的 mdadm 超级块或旧分区表会干扰 mdadm --create。风险在于:wipefs 一旦作用于错误设备(例如仍在使用的 RAID 1 成员盘),会直接破坏阵列元数据,导致数据无法挂载。由于命令本身不带交互确认,误操作的代价极高,这正是文中“四条命令对应三块盘”引起警觉的原因。
Opus 5.5 并不是 Anthropic 公开发布的正式型号名称,社区中通常用它泛指比默认 Claude 更强、推理更深的版本(例如 Opus 系列的新迭代)。不同模型在“逻辑一致性检查”上的差距,主要来自推理深度与工具调用策略:较强模型会在生成命令前先建立设备清单与目标状态的映射,再逐条校验命令的作用对象;较弱模型则倾向于按步骤模板填充,容易在数量对应关系上出错。这也解释了为何同一任务在模型切换后,风险评估结论会从“可行”翻转为“会毁掉数据”。对高风险操作而言,模型选择本身就是一道安全控制。
自我进化:变异体与X战警式的隐喻
帖子中还有一条有趣的评论:“I love it when Claude spins up hundreds of mutants and methodically kills them off one by one in the name of progress. Intelligent design, evolution or a fucked up version of X-men?” 这指的是Claude在某些任务中会生成大量变体(mutants)并逐一淘汰,类似于进化算法中的选择过程。这种“智能设计”与“进化”的混合体,既展示了AI在搜索空间中的探索能力,也让人担忧其决策过程的不透明性。
评论中的“mutants”指的是程序在搜索或优化过程中生成的候选变体:模型一次性产出多个版本的代码、方案或参数组合,再通过测试、评分或自我批判逐一淘汰,保留最优者。这一机制与进化算法中的“生成—评估—选择”循环同构,也常被称为 best-of-N 采样或自我博弈式改进。其价值在于扩大搜索空间、提高首次成功率;隐患在于选择标准由模型自身给出,淘汰过程对外不可见,用户难以判断被保留的方案是否真的更优,还是仅仅更符合模型的偏好。
多源交叉验证:共识与分歧
综合Reddit上多个用户的反馈,可以得出几点共识:Claude的自我纠错能力确实存在,且在代码审查、方案评估中表现突出;但同时,它在处理高风险任务时可能给出看似合理但实际危险的指令。分歧在于:部分用户认为这种自我批评是AI能力进化的体现,另一些人则强调必须保持人类监督。
唯一来源的独特见解包括:有用户提到“Polluted context is forever”(被污染的上下文永远存在),暗示对话历史中的错误信息可能持续影响后续输出,这提醒我们在复杂任务中要及时清理上下文或切换模型。
“上下文污染”(context pollution)指对话历史中一旦写入错误假设、过时结论或已被推翻的方案,后续轮次的推理会持续以这些错误为前提,即使模型具备纠错能力也难以完全摆脱。长会话中这一问题尤为明显:模型倾向于与先前的自我陈述保持一致,而非重新从事实出发。常见的缓解手段包括在关键节点开启新会话、显式要求模型忽略此前结论重新评估、或切换到未受污染的模型实例。对涉及数据安全的操作,及时“重置上下文”往往比在同一会话中反复纠正更可靠。
结论:AI代理的“标准”需要人类校准
Claude的自我标准既可以是质量保障,也可能是风险来源。对于开发者而言,关键是在享受AI自动化便利的同时,保留对关键步骤的审查权。毕竟,当AI说“它会毁掉你的数据”时,最好相信它——但更最好的是,从一开始就不给它毁掉数据的机会。
相关推荐

Cognition SWE-2 实战:一个提示词搞定产品发布全流程
解析 YouTube 创作者用 Cognition SWE-2 发布产品的完整提示词:落地页、七封邮件序列与未购买用户跟进工具三段式结构,以及"测试并汇报"这一约束如何改变 AI 的交付质量。
AWS AgentCore Gateway:用MCP打通AI Agent与企…
AWS AgentCore Gateway:用MCP打通AI Agent与企业后端
AWS AgentCore Gateway如何作为主MCP服务器聚合REST API、Lambda与已有MCP服务?解析其AST实时映射、零冷启动、语义搜索治工具过载、会话隔离与密钥注入安全设计,以及企业AI Agent解耦后端的架构思路。

一个链接给Figma AI装上新技能:MCP连接器实战
通过粘贴一个MCP服务器链接,Figma中的AI Agent就能获得新工具能力。本文拆解配置流程、超过20个一键接入应用、读写权限与执行策略设置,以及公开HTTPS链接这一关键限制。