ClawBench多线并行开发:三层维度让AI并行不打架
ClawBench通过会话、项目、分支三层并行机制,让一人同时推进多个AI任务而不冲突。
ClawBench 演示了如何通过会话、项目、分支三个维度的并行设计,让一个人同时推进多个 AI 任务而不打架。每个会话独立绑定不同 AI 后端并记录上下文,项目切换时整个工作区随之更换,Worktree 则让同一仓库的不同分支拥有物理隔离的文件目录。服务端执行架构使会话脱离本地设备,手机开任务、电脑看输出,状态跨端同步。三层叠加后,用户可以随时新增任务线而不必中断现有工作,大幅降低切换成本,从而实现高效并行开发。
一个人同时推进一个75万行代码、2万多个单元测试的项目,听起来像天方夜谭。但B站UP主龙泽用ClawBench演示了另一种可能:同时开六个会话,每个会话跑不同的AI后端,改通知、补测试、查线上问题互不干扰。这背后的关键不是手速,而是ClawBench在会话、项目、分支三个维度上设计的并行机制。
并行不是目的,不打架才是
龙泽在视频开头就点明了痛点:一个人写这么大的项目,一次只干一件事不现实。今天改通知模块,明天修issue,后天想动首页——每件事都得让AI知道前因后果,而上下文窗口是有限的。
并行本身不难,难的是并行之后不打架。ClawBench的解法是把并行拆成三个可以叠加的维度,从最小粒度到最大粒度依次是:会话、项目、分支。
第一层:会话——每个AI任务独立记上下文
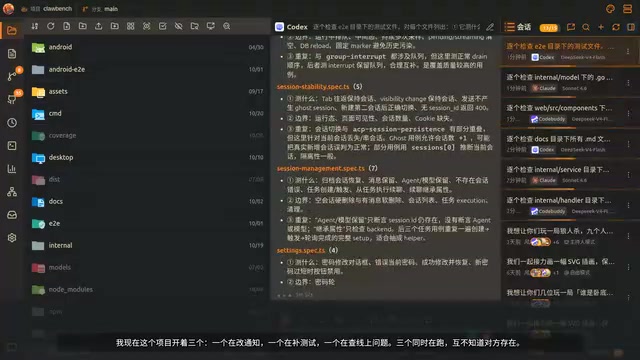
在ClawBench里,一个项目能开任意多个会话,每个会话独立跑一个AI后端,独立记录自己的上下文。龙泽当前的项目就开着三个会话:一个在改通知,一个在补测试,一个在查线上问题。三个同时在跑,互不知道对方存在。
切换回去的时候不用重新解释“我们在干什么”,每个会话记着自己那摊事。哪个会话冒出新东西,侧栏上直接亮一个点,不用一个个点开翻。
更关键的是,三个会话可以跑三个不同的后端——一个用CodeBuddy改代码,一个用Claude Code补测试,第三个拿Codex查问题。哪个后端擅长什么,自己心里有数就派谁去。窗口只是界面,底下是三条独立的任务线,各自带着完整的上下文。
上下文窗口 是大型语言模型(LLM)在一次对话中能够处理的 token 数量上限,包括用户输入、模型输出以及历史对话记录。不同模型的上下文窗口大小差异很大,从早期的 4K token 到如今常见的 128K、200K 甚至更大。当对话长度超过窗口限制时,模型会遗忘早期内容,导致回答质量下降或偏离主题。在 AI 辅助编程中,上下文窗口尤为关键:一个任务可能涉及多个文件、多次修改和大量错误信息,如果所有任务共享同一个上下文,窗口很快会被占满,模型无法记住关键细节。ClawBench 通过为每个会话分配独立的上下文,让每个 AI 任务只关注自己的那一部分,从而在有限的窗口内保持更高的专注度和准确性。这也解释了为什么并行会话需要独立记录上下文——它们本质上是多个独立的对话线程,各自维护自己的记忆。
第二层:项目——工作现场整体切换
往上一层是项目。在ClawBench里,项目就是一个关联的目录。前后端拆成两个仓库,就建两个项目,各开各的会话。前端跑页面改造,后端跑接口重构,两边同时进行。
切项目时点一下工作区,整个换掉:会话列表、文件树、终端全是那个项目的标签页,切过去还是同一套界面。
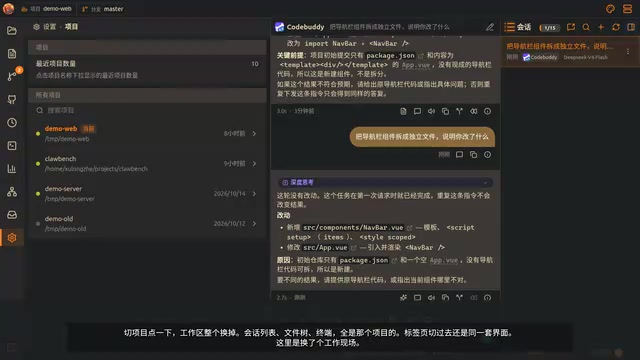
项目列表里能看到每个项目的路径、最后活跃时间、目录是否还在。哪个项目被冷落了一周,一眼就知道。
龙泽提到一个判断:团队里一个人管几个项目是常态,而AI上下文有限,为了Token也为了复杂度,一个项目不该无限大。拆成多个模块分别开发,就得在项目之间来回跳,跳一次的成本决定了你敢不敢并行。
第三层:分支——Worktree让文件目录物理隔离
更细的维度是分支。同一个仓库想同时改两个分支,普通做法是stash、切分支、改完再切回来,中间那点改动很容易丢。AI在跑的时候切分支更危险——它可能正在改一半。
ClawBench的Git页直接列出当前仓库所有Worktree:分支名、路径、有没有未提交的改动。干净的标Clean,有改动的标Dirty加文件数,被锁的、目录丢了的也各有标记。点一下就切过去,两个分支各自有独立的文件目录,物理上就不打架。一边在跑重构,一边在修bug,互不影响。
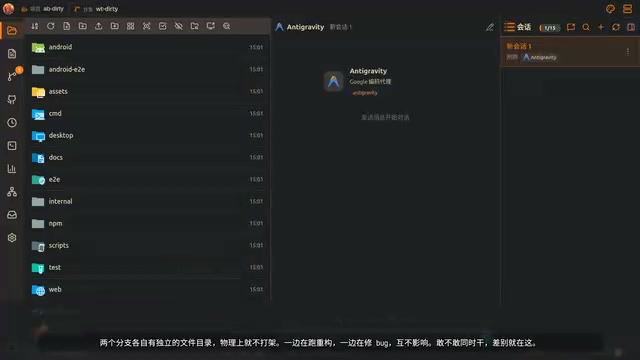
Worktree(工作树) 是 Git 自 2.5 版本引入的功能,允许同一个仓库同时检出多个工作目录,每个目录对应不同的分支。与传统的 git stash + git checkout 方式不同,Worktree 让每个分支拥有独立的文件系统路径,彼此不会干扰。例如,你可以在 ~/project-main 和 ~/project-feature 两个目录下分别检出 main 和 feature 分支,同时编辑、构建或测试,而无需反复切换。每个工作树共享同一个 .git 对象库,因此提交历史是统一的,但工作区状态完全隔离。对于 AI 辅助开发场景,Worktree 尤其有价值:当 AI 正在一个分支上修改代码时,你可以直接切换到另一个工作树继续其他任务,无需中断 AI 或担心未提交的改动丢失。ClawBench 的 Git 页面正是利用 Worktree 的这一特性,将分支切换的代价降到最低,从而实现真正的并行开发。
服务端执行:会话不绑在电脑上
这些会话不绑在电脑上。ClawBench是服务端执行、客户端可视化,活跑在服务端,手机平板电脑都只是显示器。上班路上用手机开一个会话让它跑,到工位打开电脑,同一个会话还在那输出,接着往下滚。六个会话同时在跑,手机上不用一个个点开,列表里每一行都在动。
龙泽说这个项目大部分是在通勤路上写的,跟勤奋没关系,是它允许人离开工位。
服务端执行架构 是指将计算密集或长时间运行的任务(如 AI 推理、代码生成、测试执行)放在远程服务器上完成,客户端仅负责发送指令和展示结果。这种架构与传统的本地执行模式形成对比:本地执行时,所有计算资源(CPU、内存、GPU)都依赖于用户设备,任务会随设备休眠或关闭而中断;而服务端执行则让任务在云端持续运行,用户可以通过任何设备(手机、平板、电脑)连接并查看进度。在 AI 编程助手场景中,服务端执行的优势尤为明显:AI 后端(如 CodeBuddy、Claude Code、Codex)通常需要大量算力和稳定的网络环境,本地设备难以同时支撑多个并行会话。ClawBench 将执行层放在服务端,客户端只做可视化,使得六个会话可以同时运行而不受本地性能限制,并且状态跨端同步,实现了“离开工位也不中断”的工作流。
三层叠加的真实场景
三层单独讲像三个功能,真用起来是叠在一起的。龙泽给了一个具体场景:项目开着三个会话,一个补测试、一个改文档,这时发现首页有个样式错了,得开个分支修。
常规做法是把三个都停下来,切分支改完再切回来,麻烦且AI正跑到一半。在ClawBench里不用停:终端里开好分支,回到Git页它已经在工作树列表里,点它切过去,开第四个会话让它改。前三个还在跑。
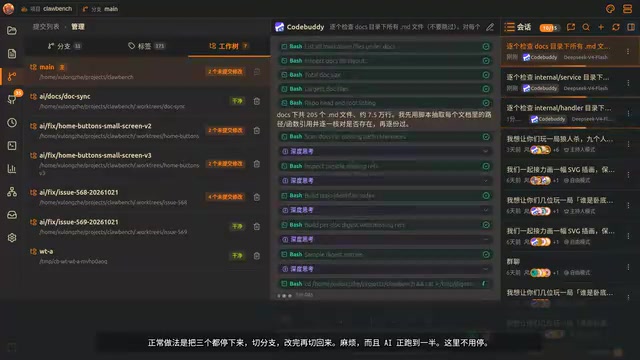
修完切回去,worktree删掉,回到原来那个分支,三个会话还在那。并行的价值就在这——随时能加一条线,加完不用收拾。
架构选择的深意
这套机制能成立,靠的是一个架构选择:执行放服务端,客户端只负责显示和操作。界面和智能体不在同一个进程里,所以关掉窗口活还在跑。一个服务端同时为多个会话、多个客户端服务,手机和电脑看到的是同一份状态。
这也解释了为什么它能并行而人不需要一个更大的屏幕。一个人干三个人的活,手速救不了,得让该并行的真并行起来。
据龙泽在视频末尾透露,下一集将尝试让AI在睡觉时继续干活。
相关推荐
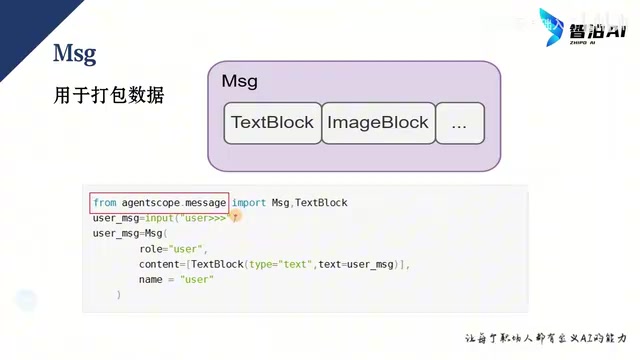
AgentScope 2.0保姆级教程:从零搭建企业级多智能体
基于B站教程详解阿里AgentScope 2.0多智能体框架:Message核心设计、模型与Agent配置、Event流式输出机制,附两个可运行对话Agent实例代码解析,适合从零入门企业级智能体开发。
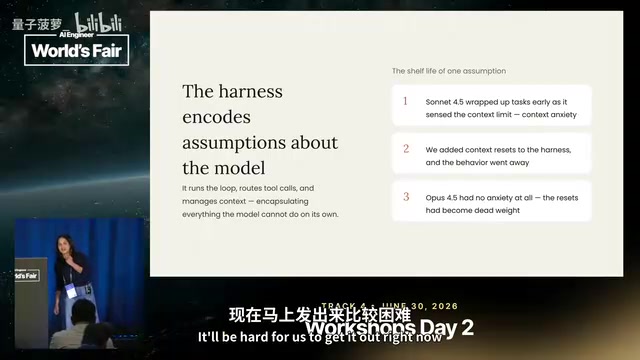
Anthropic解耦Claude智能体大脑与双手的架构演进
Anthropic在AI Engineer大会复盘Claude Managed Agents架构演进:从单容器「宠物」架构转向会话日志、Harness大脑与沙箱双手彻底解耦,首个token延迟降低约90%,凭证不进沙箱以抵御提示注入。
B站748集AI Agent开发教程:从入门到企业级实战全解析
解析B站748集AI Agent开发教程的四阶段框架:基础篇讲大模型原理与API调用,进阶篇覆盖RAG、Tool Use、记忆管理与多智能体协作,实战篇落地智能客服、办公自动化等项目,并给出学习路径与避坑建议。