CLE基准发布:LLM智能体持续学习能力仅47.7%

新基准CLE揭示前沿LLM智能体持续学习能力薄弱,最佳仅通过47.7%层级。
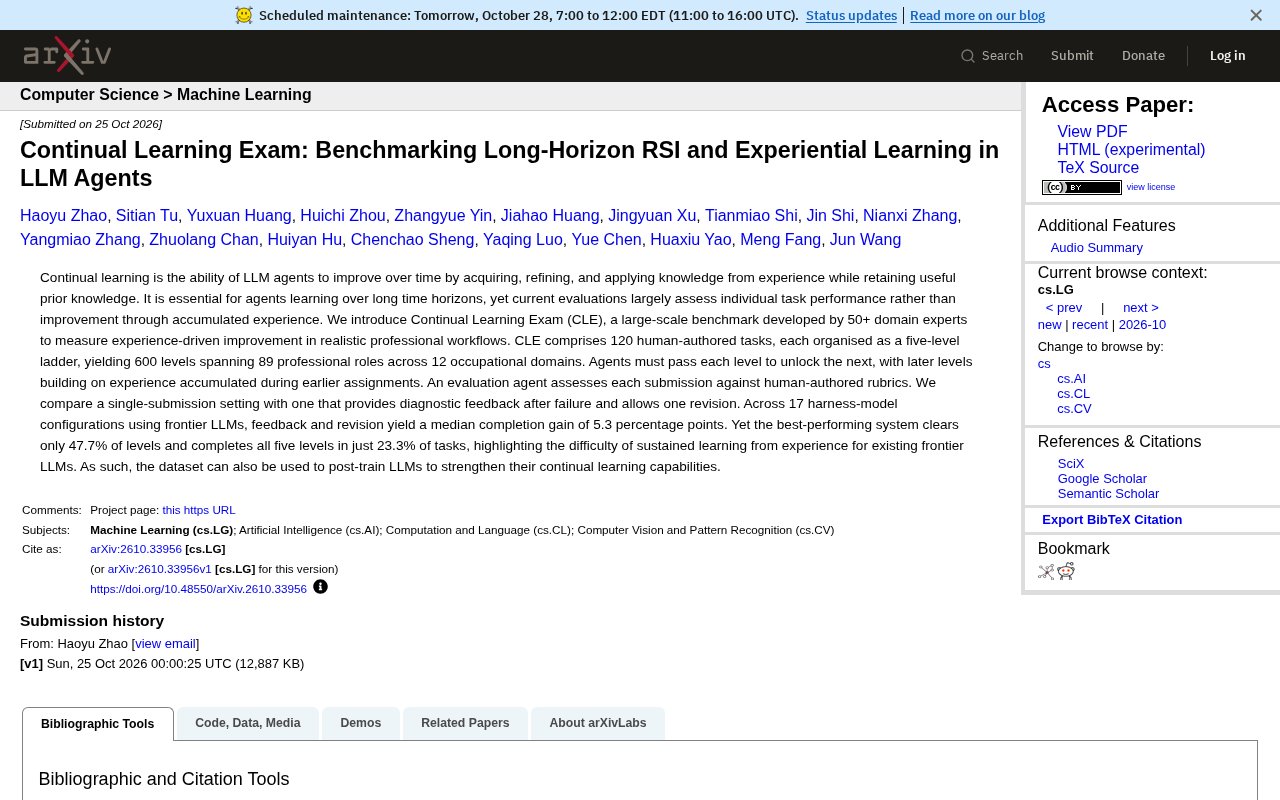
Continual Learning Exam(CLE)是由50余位专家构建的大规模基准,用120个任务、600个层级、覆盖12个领域89种职业角色,专门衡量LLM智能体在真实职业工作流中从经验中持续改进的能力。任务采用五级阶梯递进解锁设计,后续层级依赖前期经验积累。评测显示,反馈与修订仅带来中位数5.3个百分点的提升;表现最好的系统也只通过47.7%的层级,能完整通关全部五级的任务仅占23.3%。作者指出该数据集还可用于后训练,为强化持续学习能力提供方向。
持续学习:LLM智能体被忽视的能力短板
当前对LLM智能体的评估,大多聚焦于单个任务的完成质量,却很少追问一个更本质的问题:智能体能否在长时间跨度内,从经验中学习并持续改进?
最新发布的 Continual Learning Exam(CLE)正是为了填补这一空白。这个由50余位领域专家共同构建的大规模基准,专门衡量智能体在真实职业工作流中“从经验驱动进步”的能力。它不再看单点表现,而是考察智能体能否像人类从业者一样,在一次次任务中积累经验、修正错误、逐级进阶。
持续学习(Continual Learning) 在机器学习领域并非新概念,它指模型在依次到来的任务序列上学习时,能够保留旧知识并利用旧经验提升新任务表现的能力。经典挑战是“灾难性遗忘”:神经网络在新数据上微调时,旧任务性能会急剧下降。对LLM智能体而言,持续学习的含义更偏工程化——不是更新权重,而是在上下文、外部记忆或工具调用中沉淀可复用的策略与知识,使后续任务受益。CLE所测的正是这种“经验驱动进步”的能力,它与传统的多任务学习、元学习、终身学习(lifelong learning)有交集,但更强调在真实工作流中逐级递进、边做边学。
五级阶梯设计:让经验真正被“用起来”
CLE的核心设计颇具巧思。它包含120个人工撰写的任务,每个任务被组织成一条五级阶梯,合计600个层级,覆盖12个职业领域、89种专业角色。
关键机制在于递进式解锁:智能体必须通过当前层级才能进入下一级,而后续层级会建立在之前积累的经验之上。这意味着,如果智能体无法从早期任务中提炼出可复用的知识,就难以在后续层级中走远。评测由专门的评估智能体依据人工撰写的评分标准来判定每次提交。
这种设计把“持续学习”从抽象概念变成了可测量的工程指标——不是看它会不会做某道题,而是看它能不能越做越好。
反馈与修订:小幅提升,但远未解决根本问题
研究对比了两种设置:单次提交,以及失败后提供诊断反馈并允许一次修订。在17种前沿LLM的“框架-模型”配置下,反馈与修订带来了中位数5.3个百分点的完成率提升。
提升确实存在,但幅度有限。这说明当前前沿模型对反馈的利用仍停留在较浅层面,诊断信息能帮上一点忙,却不足以引发真正的经验内化。
LLM智能体(LLM Agent) 指以大型语言模型为推理核心,能够自主规划步骤、调用工具、读写外部记忆并根据环境反馈调整行为的系统。与单轮问答不同,智能体通常运行在多轮“感知—思考—行动—观察”的循环中,因而具备积累经验的接口:可以把成功策略写入长期记忆,把失败教训转成检查清单,或在后续任务中检索历史轨迹。CLE的递进式设计正好压测这些接口——若智能体没有有效的记忆写入与检索机制,前期经验就无法在后续层级中被调用,阶梯便会中断。
诊断反馈与修订(feedback-and-revision) 是智能体评测中常见的交互范式:评估方不仅给出通过与否,还指出错误类型或改进方向,允许智能体据此重新提交。它区别于简单的试错重采样,因为反馈携带了关于失败原因的结构化信息。然而,反馈能否转化为能力提升,取决于模型能否正确归因、把反馈抽象成可迁移的规则,而非仅针对当前题目打补丁。5.3个百分点的中位数提升说明,当前模型更多是在“局部修补”,尚未形成跨层级的知识沉淀,这也是持续学习与单轮自我修正之间的关键差别。
47.7%的天花板:持续学习仍是硬骨头
最能说明问题的是整体成绩。表现最好的系统也仅通过了47.7%的层级,而能在全部五个层级上完整通关的任务,只占23.3%。
换句话说,即便是当前最强的前沿LLM,在需要长期经验积累的专业工作流中,连一半的关卡都过不了,能全程走完的更是少数。这与单任务基准上动辄高分甚至接近饱和的表现形成鲜明反差。
作者指出,这一数据集不仅可以用来评测,还能用于后训练,以强化LLM的持续学习能力。这为后续研究提供了一个明确的方向:与其继续在单任务上刷分,不如把经验学习本身作为训练目标。
后训练(post-training) 指在预训练之后对模型进行的进一步训练,包括监督微调、基于人类或AI反馈的强化学习(RLHF/RLAIF)、以及针对特定能力的强化学习等。作者提出CLE可用于后训练,意味着可以把“跨层级经验迁移”本身设为优化目标:例如用课程式任务序列训练模型,奖励其在后续层级中复用前期策略;或构造需要读写外部记忆的轨迹数据做微调。这与仅在静态单任务数据上做SFT不同,它要求训练数据保留任务间的依赖关系,从而让模型学会“越做越好”而非“各自为战”。
对智能体落地的启示
CLE的价值不只在于暴露短板,更在于重新定义了“好智能体”的标准。在真实职业场景中,任务往往前后关联、经验可迁移,智能体若不能从失败中学习,就难以承担长周期工作。
对于开发者而言,这意味着在架构设计时需要更重视记忆机制、反馈回路与知识沉淀,而不是把每次任务当作孤立请求处理。对于评测社区,CLE也提示了一个方向:持续学习能力应当成为与准确性、推理能力并列的核心评估维度。
目前来看,前沿LLM在这条路上才刚刚起步,47.7%的层级通过率既是现状,也是下一阶段要突破的起点。
相关推荐

用十几个Agent搭建黑灯工厂:Lauren Tan的信任阶梯与米其林厨房
Lauren Tan分享用十几个协调Agent每月合并超2500个PR的实战经验:从信任阶梯、米其林厨房隐喻到验证技能与内外循环连接,揭示黑灯工厂背后的环境工程哲学。

GPT-6.1 Terra深度解读:中端模型的视觉与电脑使用定位
OpenAI发布GPT-6.1 Terra,主打视觉推理与电脑操作,定价介于旗舰Sol与轻量Luna之间。本文解读其中端定位、定价策略、适用场景及推理等级实测表现。

OntoGr:为Agent记忆加上引用溯源与双时间轴
OntoGr Agent Memory 是一个开源 Python 库,为 AI Agent 记忆中的每条事实保留逐字引用、来源与双时间轴,支持可逆实体消解、冲突裁决与四路召回检索,解决 Agent 记忆的信任与可追溯问题。