Cline Desktop v0.0.47更新:修复插件加载,默认模型升级Gemini 4 Argon

Cline Desktop v0.0.47 修复插件加载故障并大规模刷新模型目录,默认模型改为 Gemini 4 Argon。
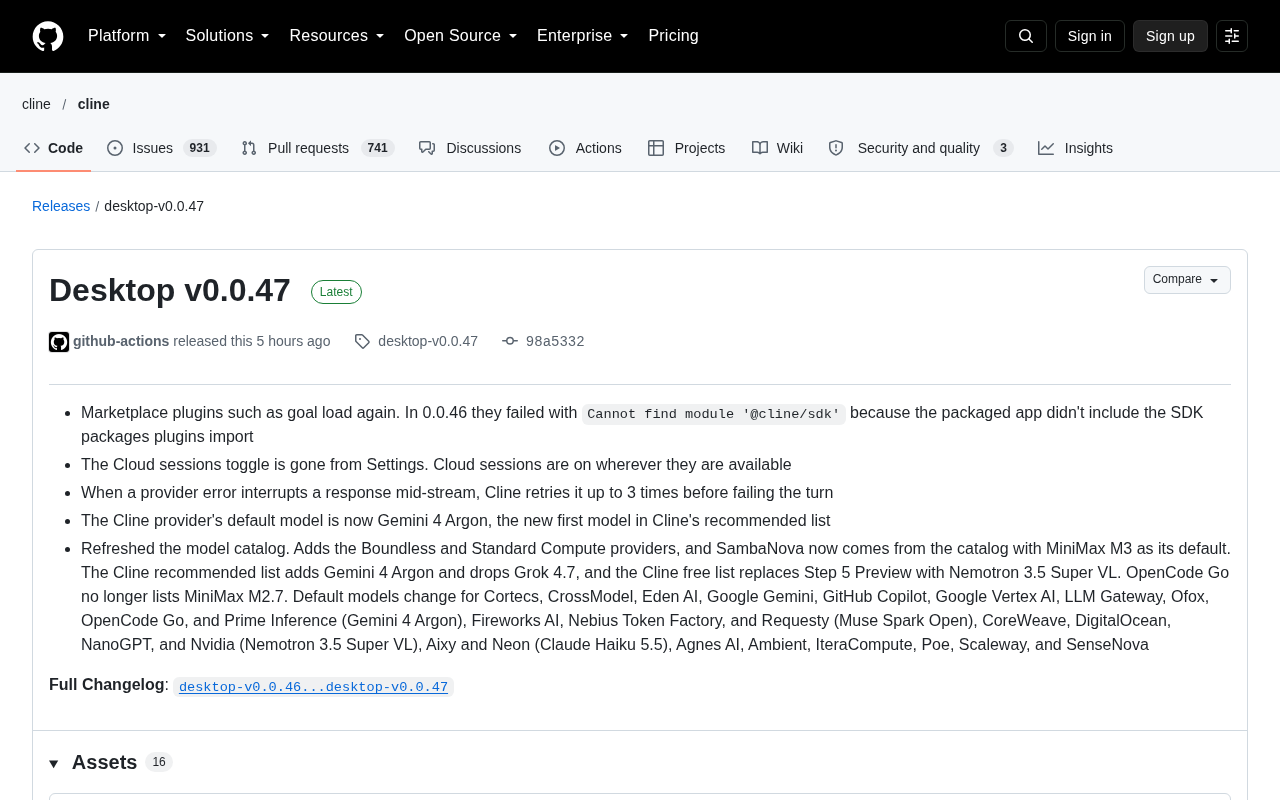
Cline Desktop v0.0.47 主要解决 v0.0.46 中 Marketplace 插件因打包应用缺少 @cline/sdk 而无法加载的阻塞级缺陷,并移除 Settings 中的 Cloud sessions 开关,改为在可用环境下默认开启。稳定性方面,当供应商错误在流式响应中途打断生成时,客户端会自动重试最多 3 次。模型目录同样迎来大范围调整:新增 Boundless 与 Standard Compute,SambaNova 改为从目录获取并默认 MiniMax M3,Cline 推荐列表新增 Gemini 4 Argon 并移除 Grok 4.7,Cline provider 默认模型同步切换,免费列表以 Nemotron 3.5 Super VL 替换 Step 5 Preview。此外 Cortecs、Nvidia、Requesty、Aixy 等数十家供应商的默认模型均有变更。文章建议 v0.0.46 用户尽快升级,并在升级后先小范围验证新默认模型的表现。
Cline Desktop v0.0.47 更新解析:插件加载修复与模型目录大刷新
据 GitHub Release 页面显示,Cline Desktop 发布了 v0.0.47 版本,本次更新集中在两个方向:修复上个版本引入的 Marketplace 插件加载故障,以及大规模刷新模型目录,涉及多个供应商的默认模型调整。
关键修复:Marketplace 插件恢复可用
v0.0.46 中存在一个影响 Marketplace 插件(如 goal)正常加载的缺陷,报错信息为 Cannot find module '@cline/sdk'。根因在于打包后的应用没有包含插件所引用的 SDK 包。v0.0.47 解决了这一问题,插件可以重新加载。
对于依赖 Marketplace 扩展工作流的用户来说,这是一个阻塞级修复。SDK 包缺失属于打包配置层面的疏漏,通常不会影响开发环境,只在分发版本中暴露,因此这类问题往往需要等用户反馈后才能被发现。
@cline/sdk 与打包依赖解析
@cline/sdk 是 Cline 提供给插件开发者调用核心能力(如文件读写、终端执行、会话上下文)的 JavaScript SDK 包。插件通过 require 或 import 引用它,由应用运行时负责解析。在 Electron 类桌面应用中,开发环境通常直接从 node_modules 读取依赖,因此缺失不会暴露;而分发版本会经过打包工具(如 electron-builder、webpack)将依赖树裁剪并内联,只有被显式声明为生产依赖或列入打包白名单的模块才会被收录。
一旦 @cline/sdk 被误判为开发依赖或未加入打包入口,用户侧就会出现 Cannot find module 这类运行时错误。修复方式通常是调整打包配置中的依赖分类或 external 声明,并补上相应版本锁定。这类问题的隐蔽性在于 CI 构建不会失败,只有真实分发产物在终端用户机器上执行到该代码路径时才触发,因此回归测试中引入插件加载的冒烟用例是必要的。
设置项精简:Cloud sessions 开关移除
新版本移除了 Settings 中的 Cloud sessions 开关。官方说明是:Cloud sessions 在可用的环境中默认开启,不再提供手动切换入口。
这一改动意味着 Cline 团队对 Cloud sessions 的可用性判断交给了系统层面,而非用户手动控制。对大多数用户而言操作路径变短,但也意味着在部分场景下失去了显式关闭的选项。
Cloud sessions 的工作模式
Cloud sessions 指会话状态的部分数据(如上下文、任务历史或部分执行环境)托管在云端而非完全保存在本地,从而支持跨设备接续、远程查看或团队协作等场景。是否启用通常取决于账号类型、网络连通性、企业策略以及所在区域的合规要求。
当这类能力由「用户手动开关」改为「系统按环境自动判定」时,实际控制权从界面转移到了配置下发与后端策略层。好处是避免了用户误关闭导致功能不可用,或在不同设备上状态不一致;代价是当用户因数据出境、隐私审计或调试需要而希望显式禁用时,缺少了直观的入口,只能通过企业策略或配置文件等间接方式处理。
稳定性改进:流式响应中断自动重试
当供应商错误在响应流中途打断生成时,Cline 现在会自动重试最多 3 次,之后才判定该轮对话失败。
流式响应中断在接入多家模型供应商的产品中是常见问题,原因可能来自网络抖动、供应商限流或服务端异常。自动重试机制能显著降低用户手动重新发起请求的频率,属于体验层面的实质改善。
流式响应与幂等性风险
流式响应指模型以 Server-Sent Events 或分块传输的方式逐步返回 token,客户端边接收边渲染。相比一次性返回,它首字延迟更低,但连接生命周期更长,任何一次网络抖动、供应商限流(如 429)或服务端异常都会导致流在中途断裂。
自动重试的收益明显,但需要注意幂等性问题:如果中断发生在工具调用已部分执行之后,简单重发可能导致重复写文件、重复执行命令等副作用。合理的实现会在重试前判断当前轮次是否已产生不可回滚的副作用,或从断点续传而非整轮重发。对用户而言,「最多 3 次」也应理解为有上限的容错,连续失败时仍需查看具体错误码而非反复等待。
模型目录刷新:新增供应商与默认模型调整
本次更新对模型目录做了较大范围的调整。
新增供应商:Boundless 和 Standard Compute 加入;SambaNova 现在从目录中获取,默认模型为 MiniMax M3。
Cline 推荐列表:新增 Gemini 4 Argon,移除 Grok 4.7。Cline provider 的默认模型同步变更为 Gemini 4 Argon,即推荐列表中的首个模型。
Cline 免费列表:以 Nemotron 3.5 Super VL 替换 Step 5 Preview。
OpenCode Go:不再列出 MiniMax M2.7。
此外,一批供应商的默认模型发生变更,包括 Cortecs、CrossModel、Eden AI、Google Gemini、GitHub Copilot、Google Vertex AI、LLM Gateway、Ofox、OpenCode Go、Prime Inference、Fireworks AI、Nebius Token Factory、Requesty、CoreWeave、DigitalOcean、NanoGPT、Nvidia、Aixy、Neon、Agnes AI、Ambient、IteraCompute、Poe、Scaleway、SenseNova 等。其中 Prime Inference 的默认模型为 Gemini 4 Argon,Requesty 为 Muse Spark Open,Nvidia 和 Nebius Token Factory 为 Nemotron 3.5 Super VL,Aixy 和 Neon 为 Claude Haiku 5.5。
解读:默认模型调整背后的信号
默认模型的选择往往反映产品团队对性价比、能力表现和稳定性的综合判断。将 Gemini 4 Argon 设为 Cline provider 的默认模型并置于推荐列表首位,说明团队对其在编码场景下的表现有较高信心。
另一边,免费列表用 Nemotron 3.5 Super VL 替换 Step 5 Preview,以及多个供应商默认模型向 Claude Haiku 5.5、Muse Spark Open 等迁移,显示出模型供给侧的更新节奏依然很快。对于用户来说,这意味着需要定期检查默认模型是否符合自身需求,必要时手动切换。
模型目录与供应商路由
模型目录(model catalog)是产品内置的一份结构化清单,描述每个供应商有哪些可用模型、上下文窗口、定价、能力标签以及默认选中项。客户端启动或定期同步时拉取该清单,用户界面中的模型下拉框即由此生成。
把默认模型与目录解耦的意义在于:厂商无需发布新版本客户端,就能通过更新目录来调整推荐模型、下线旧模型或接入新供应商。文中提到的「默认模型变更」往往对应上游模型版本的迭代或定价变化。用户应留意两点:一是默认模型可能在你不发出版本升级的情况下就已改变;二是若工作流对输出稳定性敏感,最好显式指定模型而不是依赖默认值。
升级建议
如果你在 v0.0.46 中遇到 Marketplace 插件无法加载的问题,v0.0.47 是必要升级。若你使用 Cline provider 且未手动指定模型,升级后默认模型会切换到 Gemini 4 Argon,建议先在小范围任务中验证效果再全面使用。
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。