Cline SDK v0.0.93 发布:插件进程内加载与推理开关重构

Cline SDK v0.0.93 以可靠性为重心,重构插件架构并统一多模型推理与计费逻辑。
Cline SDK v0.0.93 表面是常规迭代,实则在插件架构、多模型推理控制、自动压缩和定时任务调度上做了结构性调整。插件从 node/bun 子进程迁移为进程内单 registry 加载,配合超时、错误捕获与 loading/ready/degraded/failed/disabled 状态跟踪,使插件失败不再静默丢失工具;CLINE_PLUGIN_MODE=sandbox 保留旧隔离模式。推理开关扩展到全部 provider,可移植选项与原生控制参数互斥且原生优先。图片改为每张固定 1600 token 估算,修正了 90KB 截图被算作 30k token 导致误触发压缩的问题,自动压缩也改用解析后的有效上下文窗口。此外修复了 bun:sqlite 下排队定时任务无法认领、provider 错误被记为成功、积压 cron 重复重放等缺陷,并更新模型目录与 Composio 连接器。
AI 编程工具 Cline 的 SDK 发布了 v0.0.93 版本。这次更新表面上是常规迭代,实际上在插件架构、多模型推理控制、自动压缩策略和定时任务调度上做了几处结构性调整,对依赖其 SDK 构建智能体(agent)的开发者影响不小。
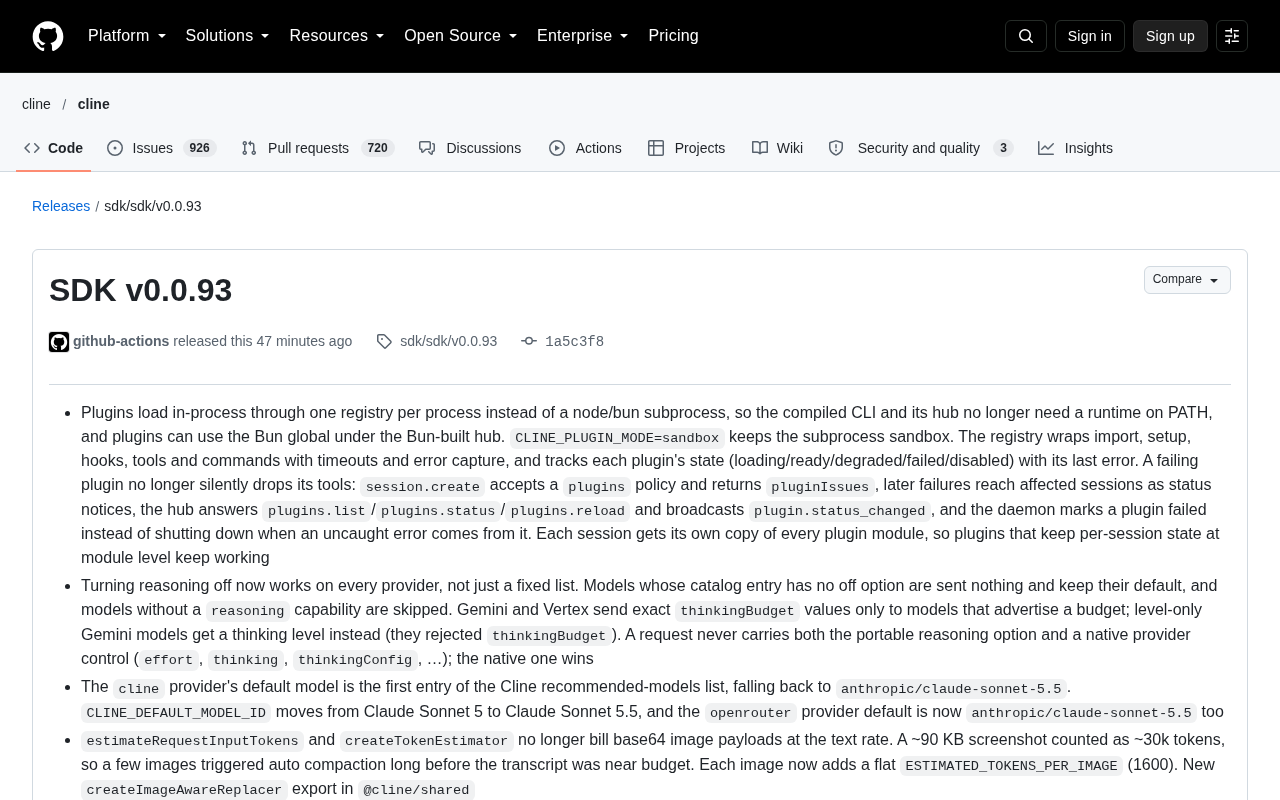
插件不再跑在子进程里
这次最值得关注的变化是插件加载机制。此前插件通过 node/bun 子进程运行,新版本改成一个进程一个 registry 的进程内加载方式,编译后的 CLI 与其 hub 不再需要在 PATH 里准备运行时。同时保留 CLINE_PLUGIN_MODE=sandbox 来继续使用子进程沙箱,给需要隔离的场景留了退路。
registry 会为 import、setup、hooks、tools、commands 包裹超时与错误捕获,并跟踪每个插件的状态——loading、ready、degraded、failed、disabled,同时记录最后一次错误。这一点很关键:过去插件出错时它的工具会静默消失,现在失败会以明确的信号暴露出来。session.create 接受 plugins 策略并返回 pluginIssues,后续失败会作为状态通知推送到受影响的会话;hub 提供 plugins.list / plugins.status / plugins.reload 接口并广播 plugin.status_changed;当未捕获错误来自某个插件时,守护进程会把该插件标记为失败,而不是直接退出。
每个会话拿到的是每个插件模块的独立副本,因此在模块层维护会话级状态的插件依然能正常工作。这个设计取舍解决了进程内共享带来的状态污染问题。
进程内加载 vs 子进程沙箱:子进程隔离方式通过将插件运行在独立的 node/bun 进程中,实现崩溃隔离、内存隔离和权限受限;代价是 IPC 通信开销、进程启动延迟、调试困难,且宿主必须在 PATH 中提供运行时。进程内加载把插件模块直接加载进主进程,通过 registry 统一管理生命周期,优点是调用链更短、状态可观测、部署更简单;缺点是一旦插件抛未捕获异常或挂起,可能拖垮整个进程。因此新设计用「状态跟踪 + 超时包裹 + 失败标记」来弥补隔离性的下降,并以 CLINE_PLUGIN_MODE=sandbox 保留旧模式作为退路,让强隔离场景仍能维持原有行为。
registry 与插件生命周期:registry 是插件系统的调度中心,负责按序执行 import(加载模块)、setup(初始化)、hooks(事件钩子注册)、tools(工具注册)、commands(命令注册),并在每一步外层包裹超时与错误捕获。插件状态机 loading → ready → degraded → failed → disabled 让宿主能区分「尚未就绪」「部分能力不可用」「彻底失败」等语义。degraded 通常表示部分 hooks 或 tools 注册失败但插件其余部分仍可用;failed 表示关键初始化失败,其工具不应再被调用;disabled 表示用户或守护进程主动停用。每个会话获取插件模块的独立副本,意味着插件可以在模块作用域内安全保存会话级状态,而不必担心被其他会话污染。
关闭推理能力不再限定于白名单
推理开关的调整覆盖面更广了。旧逻辑只对一份固定名单生效,现在所有 provider 都适用:目录条目中没有 off 选项的模型不会被发送任何相关参数,保留默认行为;不具备 reasoning 能力的模型直接跳过。Gemini 和 Vertex 只会向声明支持预算的模型发送精确的 thinkingBudget,仅支持 level 的 Gemini 模型则接收 thinking level(它们会拒绝 thinkingBudget)。
请求永远不会同时携带可移植的 reasoning 选项和原生 provider 控制参数(effort、thinking、thinkingConfig 等),出现冲突时原生参数优先。这类互斥处理减少了实际调用中因参数叠加导致的异常。
推理参数的可移植性与原生控制的冲突:不同 provider 对「关闭/调节推理」的表达方式差异很大。有的使用统一的可移植参数(如 reasoning: false 或通用的 effort 字段),有的则要求原生字段:OpenAI 风格的 effort、Anthropic 风格的 thinking、Gemini 风格的 thinkingConfig。当两者同时出现在一次请求里,provider 可能报错、静默忽略或行为不可预测。因此新策略规定二者互斥、原生优先——一旦明确使用原生控制参数,就不再附加可移植的 reasoning 选项。这一取舍让开发者可以按 provider 能力写精确逻辑,同时保留使用可移植参数的路径用于跨 provider 的通用场景。
thinkingBudget 与 thinking level:Gemini 及 Vertex 的部分模型采用「思考预算」(thinkingBudget,以 token 数量表示)来控制内部推理长度;另一些仅支持 level 的模型使用离散档位(如 low/medium/high)表达思考深度,它们会拒绝 thinkingBudget 参数。SDK 需要根据目录条目中的模型能力声明来决定发送哪种参数,并对「不支持 off」的模型直接跳过,避免因参数不被识别而触发调用异常。这对多模型路由层是关键约束:路由逻辑必须携带模型能力元数据,而不仅仅是模型 id。
图片计费与自动压缩的修正
estimateRequestInputTokens 和 createTokenEstimator 不再按文本费率计算 base64 图片负载。按旧逻辑,一张约 90 KB 的截图会被算作约 30k tokens,几张图片就能在对话远未接近预算时触发自动压缩,这对频繁贴图的使用场景干扰明显。新版本为每张图片加上固定的 ESTIMATED_TOKENS_PER_IMAGE(1600),并在 @cline/shared 中新增 createImageAwareReplacer 导出。
自动压缩现在使用解析后的模型上下文窗口。当已发现的目录条目没有限制、但所选模型覆盖项有限制时,旧代码会把裸目录条目交给压缩逻辑,导致按错误的预算运行。
base64 图片负载与 token 估算误差:多模态请求中图片通常以 base64 编码字符串嵌入,其字符数约为原始字节的 4/3。若估算器按文本 token 费率(约 4 字符 ≈ 1 token)处理,一张 90 KB 截图的 base64 约 120 KB、约 30k 字符,就会被错误估算为约 30k tokens。真实视觉 token 消耗取决于分辨率与 provider 的分块策略,通常远低于此。这个偏差会导致自动压缩在对话远未接近上下文窗口时就被触发,频繁贴图的会话尤其受影响。新方案为每张图片使用固定常量 ESTIMATED_TOKENS_PER_IMAGE = 1600,牺牲一定精度换取稳定性和可预测性,并由 createImageAwareReplacer 在压缩时统一替换图片内容。
上下文窗口解析与自动压缩预算:自动压缩需要知道「当前模型的有效上下文窗口」才能判断何时触发。模型信息有两个来源:目录条目(catalog entry,为整个模型族提供默认值)和所选模型覆盖项(override,为特定部署或路由指定更严格限制)。当覆盖项存在限制而目录条目没有时,旧逻辑会错误地把裸目录条目交给压缩器,使其按过大的预算运行,直到请求被 provider 拒绝才压缩。修复后压缩器使用解析后的有效窗口,即覆盖项优先、缺失时回退到目录条目。
定时任务与桌面端的修复
在 bun:sqlite 下,排队中的定时运行此前无法被正确认领——存储的具名参数被绑定为 NULL,桌面 hub 因而从不认领排队任务,任务无声地停留在 pending 状态。现在该问题已修复。因 provider 错误(例如已退役的模型 id)而结束的 agent 回合,会被记录为失败并保留错误信息,而不是静默成功;运行报告仍然保留用量和工具调用记录。同一调度中被更新出现取代的排队 cron 实例会被取消,积压不会再一次性重放所有错过的时段。
其他修复还包括:符号链接形式的规则文件现在会从配置目录加载而不再跳过,链接目标的编辑会在下次刷新或新会话时生效;resolveSkillsConfigSearchPaths 会扫描 .claude/skills,为 Claude Code 编写的技能对 Cline 可见;编辑器工具把 old_text 声明为普通字符串,避免部分模型发送 null 代替替换文本(运行时仍接受 null 并视为省略)。
Composio 连接器与模型目录更新
已登录会话现在会注册 Composio 的元工具(搜索、管理连接、等待连接、多重执行),agent 因此可以跨工具包查找连接器工具、为用户尚未连接的应用生成 Connect Link,并执行找到的工具。连接器工具通过元搜索发现,已保存的桌面连接状态不再提供模型工具。宿主可以通过新增的 connectorsRequest 选项(ConnectorsRequest 从 @cline/core 导出)提供自己的认证,该选项也会转发给定时会话。resolveComposioToolsStatePath 更名为 resolveComposioConnectionStatePath。
@cline/core 中的 Cline 云登录辅助函数接受 AbortSignal,宿主可以在轮询期间取消挂起的登录。云会话刷新会用网页端重命名的标题更新已打开的会话,同时保留刷新期间本地所做的重命名。
模型目录从 6,572 个刷新到 6,862 个,新增 AI/ML API、LowRouter 和 Prime Inference 三个 provider。由于 models.dev 不再列出 v0,v0 provider 只带默认模型 v0-1.5-md。OpenCode Go 的 base URL 从 https://opencode.ai/zen/go/v1 迁移到 https://opencode.ai/inference/go/v1。Free 列表新增 Step 5 Preview,302.AI、CrossModel、Cortecs、DigitalOcean、NEAR AI Cloud、Ofox、DevPass、LLM Gateway、Meta、Aixy、CloudFerro Sherlock、Moark、Ambient、NanoGPT、Neuralwatt、Novita AI 等 provider 的默认模型也有调整。
Composio 元工具与连接生命周期:Composio 是一个把第三方应用(如 GitHub、Slack、Notion)封装为可调用工具的平台。其「元工具」不是具体某个 SaaS 的能力,而是用于操作工具生态本身:搜索可用的连接器工具、发起 OAuth 连接、检查连接状态、在同一回合内串联多次工具调用。这让 agent 无需预先枚举所有工具,而是在需要时动态发现并请求用户完成授权(Connect Link)。连接成功后的凭证由 Composio 侧托管,宿主只需保存连接状态。新增的 connectorsRequest 选项允许宿主注入自定义认证逻辑,使企业环境下的私有连接器也能被 agent 使用,并会转发给定时会话,保证无人交互的后台任务同样能访问已授权的连接。
模型目录(models.dev)与 provider 抽象:模型目录是一个集中维护的模型元数据源,记录每个模型的上下文窗口、是否支持视觉、推理参数形态、计费标准等信息,SDK 依赖它做路由、预算与参数决策。目录规模从 6,572 增至 6,862,意味着新增约 290 个模型条目,其中新增 provider 包括 AI/ML API、LowRouter、Prime Inference。provider 是统一抽象层,屏蔽各家 API 在鉴权、endpoint、参数命名上的差异;当某来源停止维护时(如 models.dev 不再列出 v0),目录需回退到默认模型清单,否则会导致该 provider 无法被正确解析。
这次更新意味着什么
从发布说明看,v0.0.93 的重心不在新功能,而在可靠性。插件从子进程迁到进程内,配合状态跟踪和错误隔离,实际上是把插件生态从「能用」推向「可运维」;推理参数的统一处理和图片 token 计费的修正,则是在模型数量快速膨胀背景下对多 provider 兼容层的一次梳理。对构建在 Cline SDK 之上的团队来说,升级前需要留意插件是否依赖子进程隔离,以及是否会因为 plugin.status_changed 等新事件而改变现有的错误处理逻辑。
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。