Cline SDK v0.2.0 更新:会话重连、重试瘦身与模型目录大换血

Cline SDK v0.2.0 修复幽灵会话与无效重放,提升长任务稳定性。
Cline SDK 从 v0.0.95 跃升至 v0.2.0,核心是修复长任务执行中的稳定性问题。会话层面,对运行中会话再次 start 现在改为重连活跃 runtime,避免产生无法访问却仍在写 transcript 的幽灵运行;hub 按在线客户端路由请求并快速失败。重试上限从 5 次降到 3 次,仅 reasoning 阶段断连可重试,已产生文本、媒体或工具调用则绝不重放,失败尝试记入 Langfuse trace。工具层修补 ask_question、run_commands 的边界条件,checkpoint diff 改用单次 git cat-file --batch。SSH 远程支持 ProxyJump 并放宽超时,Gemini provider 停发原生搜索以规避 429 与工具丢失,压缩估算改用实际发送内容修正约 7 倍高估,模型目录精简至 6457 个。整体收益偏向稳定性与成本可预测,而非新功能。
Cline 的 SDK 从 v0.0.95 一口气跳到 v0.2.0,发布说明里塞满了会话生命周期、工具调用和模型目录的改动。这不是一次例行版本号递增——它更像是把过去几个月在长任务执行、SSH 远程协作和插件体系上攒下的坑集中填了一遍。
会话重连:从“再也找不到”到“接上继续跑”
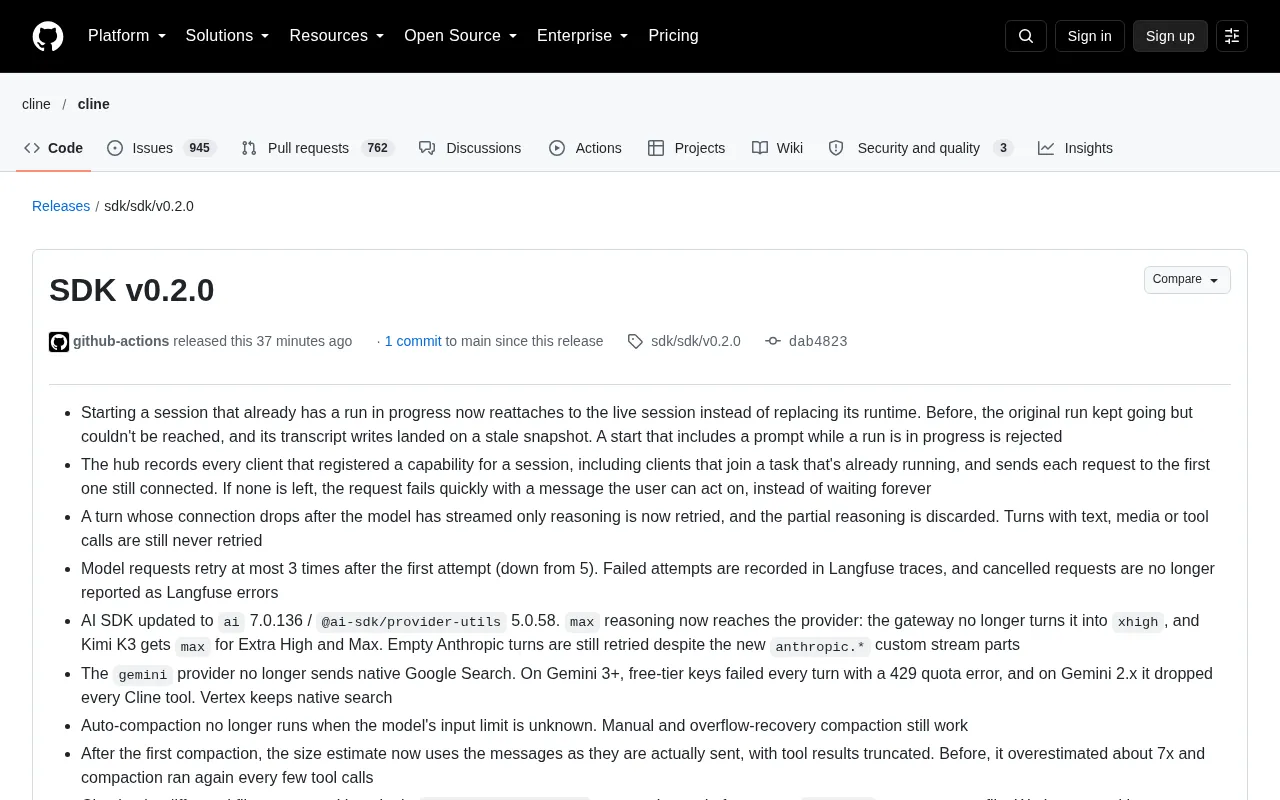
旧版本里有一个让人抓狂的行为:对一个已经在运行中的会话再次发起 start,它会把 runtime 整个替换掉,但原本那次 run 并不会停止——它还在跑,却再也无法被访问,后续的 transcript 写入全都落在一个过期快照上。结果就是一个看不见、停不掉、还在写日志的“幽灵运行”。
v0.2.0 改为重新接入(reattach)到活跃会话。如果 start 请求同时还带了 prompt,而在跑的任务尚未结束,这个请求会被直接拒绝,而不是制造出第二个 runtime。
配套的另一个改动是 hub 的请求路由。hub 现在会记录每个为某会话注册了能力的客户端,包括中途加入正在运行任务的客户端,然后把每个请求发给第一个仍然在线的客户端。如果一个都不剩,请求会立刻失败并给出可操作的错误信息,而不是无限等待。这个设计明显是为多客户端场景(桌面端、云端、插件)准备的容错。
runtime 与 transcript:在这类 agent SDK 中,runtime 指承载一次会话执行状态的对象——包括当前对话历史、工具调用栈、流式输出缓冲与模型连接等运行时资源;transcript 则是持久化下来的对话记录(用户/助手消息、工具结果等),通常按追加方式写入。旧版本的问题本质是 runtime 被替换后,旧 runtime 仍持有对 transcript 的写入句柄,新 runtime 又指向另一份快照,于是产生“写入分叉”。理解这一点,才能明白为何“重新接入活跃会话”比“新建 runtime”更安全:它保证内存状态与持久化记录始终指向同一条时间线。
重试策略收紧,但边界更清晰
模型请求的重试次数从 5 次下调到 3 次。失败尝试会记录进 Langfuse trace,被取消的请求不再被误报成 Langfuse 错误——后者会污染监控数据,让真实的失败率失真。
重试的判定条件也做了细化。如果连接在模型只流式输出了 reasoning 内容后断开,这一轮会被重试,并且丢弃那部分推理内容。但只要已经产生 text、media 或 tool call,就绝不重试。这个边界划得很合理:纯推理是中间态、幂等成本低,而工具调用一旦重放就可能产生副作用。
另外,Anthropic 的空回合在新引入的 anthropic.* 自定义流式分片下依然会被重试。
Langfuse trace 与可观测性:Langfuse 是面向 LLM 应用的开源可观测性平台,通过 trace(一次请求的完整调用链)和 span/observation 记录提示词、模型响应、耗时、错误与 token 用量。它区分“业务失败”和“用户/系统取消”这两类事件,因为把取消计入错误会让失败率、重试率等指标失真。文中提到被取消请求不再被误报为错误,正是为了让监控数据反映真实的模型稳定性;而重试尝试被记录进 trace,则便于事后分析哪些 provider 或网络条件下重试最频繁。
工具调用的细节修补
这批改动看起来零碎,但每一条都对应真实的失败场景:
ask_question:回答的框架现在保证模型在收到一个光秃秃的选项后还能继续推进;空回答被拒绝,只有附件也算已作答。run_commands:空commands列表会返回工具错误,schema 里补上了minItems: 1。PowerShell 的说明补全了反引号转义、字面路径用单引号、优先用 cmdlet 而非cmd /c、递归删除前先确认等实践。- Checkpoint diff:改用单个
git cat-file --batch进程读取文件内容,而不是每个文件最多起两个git show。未跟踪文件多的工作区以前会 spawn 出成千上万个 git 进程。
git cat-file --batch:这是 Git 的底层管道命令,可在一次进程调用中批量读取多个对象(blob、tree、commit)的内容,通过 stdin 逐行发送对象名、stdout 按序返回。相比对每个文件执行一次 git show(甚至两次),批量模式把进程创建和仓库索引加载的开销摊薄到一次,在未跟踪文件成千上万的工作区里差距尤其明显。它属于 Git plumbing 命令,输出格式稳定,适合被工具链直接解析,这也是 checkpoint diff 改造选择它的原因。
SSH 远程:ProxyJump、超时与真实报错
SSH 远程现在能在 ProxyJump 别名下工作。连接预算从 10 秒放到 30 秒,单命令限制到 60 秒,隧道就绪等待到 40 秒。上传中途 ssh 退出时,报的是真实错误而不是 EPIPE;别名上的 LocalForward 也不会再和隧道撞车。
这些数字的调整说明团队遇到了真实的慢网络和跳板机场景,而不是纸面优化。
ProxyJump 与 LocalForward:ProxyJump 是 OpenSSH 的跳板机配置项(-J 的配置化形式),让客户端先连到堡垒机再由其转发到目标主机,无需手动建立隧道。LocalForward 则用于把本地端口转发到远端服务。两者在别名配置下可能争夺同一本地端口,或让隧道建立路径与跳板路径冲突。把连接预算放宽到 30 秒、隧道就绪等待放到 40 秒,反映的是多跳链路上 TCP 握手、认证与端口转发的累计延迟;而把 EPIPE 换成真实错误,意味着上传进程退出时能区分“对端关闭”“认证失败”“超时”等具体原因,便于用户定位。
Reasoning 参数与 Gemini 原生搜索的取舍
max reasoning 现在能正确传到 provider:网关不再把它改写成 xhigh,Kimi K3 在 Extra High 和 Max 档位拿到 max。
gemini provider 不再发送原生 Google Search。原因写得很直白:Gemini 3+ 上免费档 key 每一轮都因 429 配额错误失败,Gemini 2.x 上则会丢掉每一个 Cline 工具。Vertex 保留原生搜索。这是一个典型的“能力 vs 可用性”权衡,选择了后者。
压缩与模型目录
自动压缩在模型输入上限未知时不再运行(手动和溢出恢复压缩仍可用)。第一次压缩后,大小估算改用实际发送的消息(工具结果已截断),此前会高估约 7 倍,导致每几次工具调用就触发一次压缩。
模型目录从 7,041 个缩到 6,457 个。新增 Liquid Inference、Munito AI 和 Munito AI (EU) 三个 provider,移除 CrofAI、iFlow 和 Llama。Cline 免费列表加入 Reflection Beam、Nemotron 3.5 Lightning、Laguna S 2.1,移除 Mimo V2.6 Flash 和 Muse Spark 1.3 Contributor。ClinePass 新增 Kimi K3.1 Pro(成为默认)、MiniMax M3.1 Flash、DeepSeek广告 V4.1 Flash 1017,移除 Mimo V2.5 和 V2.5 Pro。另有 56 个其他 provider 的默认模型变更,大多指向 Kimi K3.1 Pro、MiniMax M3.1 Flash 或 DeepSeek V4.1 Flash 1017。
AI SDK 同步升到 ai 7.0.136 / @ai-sdk/provider-utils 5.0.58。
平台与插件层
Desktop 的云会话编排迁移进 hub,session.list 会报告 activeCloudCommands,云命令仍在运行时 hub 不会被替换。核心新增对话摘要和云端续接支持。插件命令会在活跃的会话 runtime 和 hub 里执行,发现目录出现时插件 watch 恢复工作。编译后的二进制直接从二进制加载内嵌的插件与 dashboard 资源,所有声明的 SDK runtime 导出都会被打包,CLINE_PLUGIN_RUNTIME_DIR 会解析为绝对路径。
@cline/ui 现在随 SDK 包一起以共享版本发布,新增 Kbd 组件,AgentComposer 里的斜杠命令和文件提及有了 token chip。
值得注意的两个信号
一是运行停滞遥测:agent.run-finished 和 agent.run-failed 会携带来自新 RunHealthObserver 的停滞信号。这是把“agent 卡住了”从用户抱怨变成可观测指标的一步。
二是重试上限下调、压缩判断修正、git 进程合并——这些都指向同一个方向:减少无效重放和资源浪费,让长任务的成本更可预测。对于把 Cline 用作日常编码代理的团队,v0.2.0 的收益主要体现在稳定性而非新功能上。
相关推荐

Cognition SWE-2 实战:一个提示词搞定产品发布全流程
解析 YouTube 创作者用 Cognition SWE-2 发布产品的完整提示词:落地页、七封邮件序列与未购买用户跟进工具三段式结构,以及"测试并汇报"这一约束如何改变 AI 的交付质量。
AWS AgentCore Gateway:用MCP打通AI Agent与企…
AWS AgentCore Gateway:用MCP打通AI Agent与企业后端
AWS AgentCore Gateway如何作为主MCP服务器聚合REST API、Lambda与已有MCP服务?解析其AST实时映射、零冷启动、语义搜索治工具过载、会话隔离与密钥注入安全设计,以及企业AI Agent解耦后端的架构思路。

一个链接给Figma AI装上新技能:MCP连接器实战
通过粘贴一个MCP服务器链接,Figma中的AI Agent就能获得新工具能力。本文拆解配置流程、超过20个一键接入应用、读写权限与执行策略设置,以及公开HTTPS链接这一关键限制。