Cline v4.1.25 发布:云端沙箱任务与模型目录大更新

Cline v4.1.25 上线云端沙箱任务、刷新模型目录并修复长请求超时与 URL 处理。
Cline 发布 v4.1.25,核心新增 Cline Cloud sessions:用户可在指定 GitHub 仓库与分支的托管沙箱中运行任务,关闭编辑器后仍持续执行,任务状态出现在 Recent 与 History 并主动通知,目前为逐步推送。模型方面,未手动选择时 Cline provider 默认改用 Gemini 4 Argon,OpenRouter 仍保持 Claude Sonnet 5.5;目录新增 Boundless 与 Standard Compute,SambaNova 默认 MiniMax M3,推荐列表加入 Gemini 4 Argon 并移除 Grok 4.7,多个 provider 默认模型同步调整,升级后建议核对实际调用模型。底层修复解决了本地模型长请求因 5 分钟静默导致的 BodyTimeoutError,并让 OpenAI Compatible base URL 严格按输入使用、不再静默追加 /v1,旧配置一次性兼容。
Cline 发布了 v4.1.25 版本更新,这次更新带来了云端沙箱任务、模型目录刷新以及一系列底层修复。对于重度依赖 AI 编程助手的开发者来说,这次更新在协作方式和模型选择上都有实质性的变化。
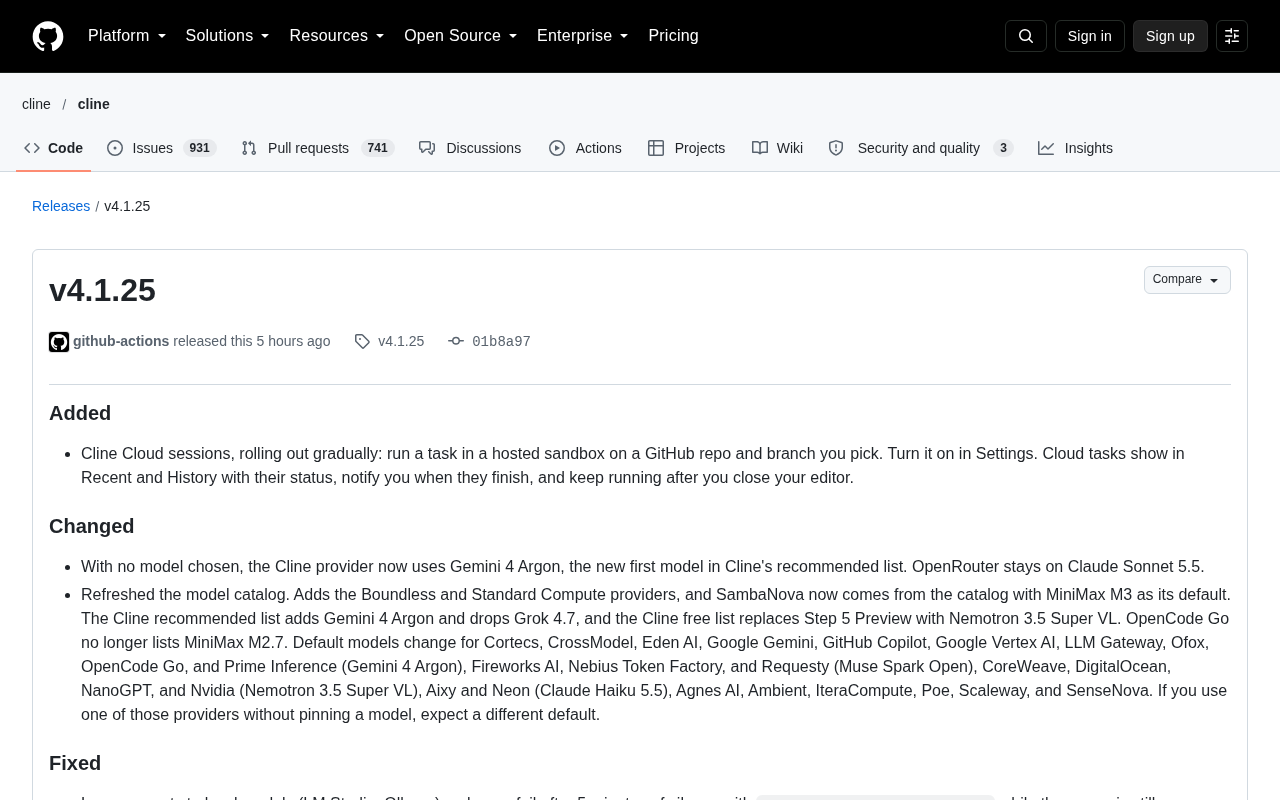
Cline Cloud 会话:把任务放到云端跑
本次更新最值得关注的新功能是 Cline Cloud sessions。用户可以在自己指定的 GitHub 仓库和分支上,于托管沙箱中运行任务,而不必把整个过程绑定在本地编辑器里。
开启方式很简单,在 Settings 中打开对应开关即可。云端任务会出现在 Recent 和 History 列表中,并附带实时状态。任务完成后会主动通知用户,而且即使关闭编辑器,任务依然会继续执行。
这个设计的思路是把 AI 编程任务从"坐在电脑前等结果"变成"提交后去做别的事"。对于需要长时间运行的大型任务,或者希望在多个仓库间并行处理的团队,云端沙箱提供了更灵活的工作流。该功能目前是逐步推送(rolling out gradually),并非所有用户立即可见。
托管沙箱指的是一种由服务提供方托管的隔离执行环境,它通常以容器或轻量虚拟机的形式存在,具备独立的文件系统、依赖与网络策略。与在本地运行相比,托管沙箱把计算与存储从开发者机器上剥离,任务的生命周期不再依赖编辑器进程是否存活。这也意味着云端会话需要具备仓库鉴权、分支拉取、环境初始化、状态回传等一套完整链路。对于 AI 编程助手而言,沙箱还要解决如何把模型生成的补丁、命令执行结果与仓库状态同步回用户可见的地方,因此任务状态会以实时形式出现在 Recent 与 History 中,并通过通知机制告知完成情况。
默认模型切换:Gemini 4 Argon 上位
在未手动选择模型的情况下,Cline provider 现在默认使用 Gemini 4 Argon——这是 Cline 推荐列表中的新首位模型。OpenRouter 则保持默认 Claude Sonnet 5.5 不变。
模型目录也经历了一轮刷新:
- 新增 Boundless 和 Standard Compute 两个 provider
- SambaNova 从目录加载,默认模型为 MiniMax M3
- Cline 推荐列表加入 Gemini 4 Argon,同时移除 Grok 4.7
- Cline 免费列表用 Nemotron 3.5 Super VL 替换 Step 5 Preview
- OpenCode Go 不再列出 MiniMax M2.7
Cline 还调整了多个 provider 的默认模型,涉及 Cortecs、CrossModel、Eden AI、Google Gemini、GitHub Copilot、Google Vertex AI、LLM Gateway、Ofox、OpenCode Go、Prime Inference(Gemini 4 Argon)、Fireworks AI、Nebius Token Factory、Requesty(Muse Spark Open)、CoreWeave、DigitalOcean、NanoGPT、Nvidia(Nemotron 3.5 Super VL)、Aixy、Neon(Claude Haiku 5.5)、Agnes AI、Ambient、IteraCompute、Poe、Scaleway 和 SenseNova。
如果你使用上述任一 provider 且没有固定模型,更新后默认模型会发生变化。这是一个容易被忽视但影响直接的变化,建议在升级后检查一下实际调用的模型是否符合预期。
在 AI 编程工具中,provider 与模型目录是两个不同层级的概念。provider 指实际承接推理请求的服务方,例如 OpenRouter、Fireworks AI、Nvidia、Scaleway 等;模型目录则是这些服务方所提供模型的清单及其元数据。Cline 在此基础上又维护了两张额外的列表:推荐列表(Cline 认为综合表现最好的模型序列)与免费列表(可零成本调用的模型)。当用户没有显式固定模型时,工具会按推荐列表首位的默认值发起请求。因此当默认值发生变更,实际调用的模型、计费口径与输出风格都可能随之改变,这也是升级后需要核对的直接原因。
底层修复:长请求超时与 URL 处理
本次修复列表中,有两项对日常使用体验影响较大。
第一项是本地模型的长请求超时问题。此前向 LM Studio、Ollama 等本地模型发起长请求时,如果服务端仍在处理大型 prompt,超过 5 分钟静默就会以 terminated: BodyTimeoutError 失败。新版本解决了这个问题,长时间推理不再被误判为连接中断。
第二项是 OpenAI Compatible base URL 的处理逻辑。现在 URL 会严格按照用户输入使用,像 https://abc.com 这样的纯主机地址不会再被静默加上 /v1。为了兼容旧配置,早期版本保存的纯主机 URL 会被添加一次 /v1,保证现有设置继续可用。
此外,Cline 在回答用户问题时附带的图片和文件现在能正确传递给模型,不再被丢弃;当 provider 错误在流式响应中途打断时,Cline 会最多重试 3 次再判定该轮失败。JetBrains 插件中 Run task 卡片保持在 Auto-approve 栏上方,Auto Compact 及其策略设置也重新归位于 Feature settings 中。
BodyTimeoutError 通常来自底层 HTTP 客户端对响应体读取阶段的超时限制。在流式或长推理场景中,服务端可能因为 prompt 体积大、显存调度或排队而长时间不返回任何数据块,客户端若把这段静默期判定为连接中断,就会直接终止请求。本地推理服务如 LM Studio、Ollama 在单机资源受限时尤其容易触发这一情况。修复这类问题一般有两种思路:一是提高或取消响应体阶段的超时阈值,二是引入心跳或保活机制以区分真正的中断与单纯的处理延迟。理解这一点有助于判断哪些自建或本地部署场景仍可能遇到类似问题。
OpenAI Compatible base URL 是许多第三方服务为了兼容 OpenAI SDK 而暴露的接口前缀约定。OpenAI 官方 SDK 习惯在 base URL 之后自动拼接 /v1 等版本路径,这导致部分客户端在用户填写 https://abc.com 这类纯主机地址时,会自作主张补齐 /v1,而对本就不需要该路径的服务造成 404 或路由错误。Cline 改为严格按用户输入使用 URL,是对这一历史行为的纠正;同时为早期版本保存过的纯主机地址做一次性 /v1 补全,属于带状态的向后兼容策略,避免老配置在升级后立即失效。
这次更新意味着什么
从功能组合来看,Cline 正在把"云端任务"和"模型自由切换"两条线同时推进。云端沙箱解决了本地算力和编辑器生命周期的限制,而模型目录的洗牌则反映出 AI 编程工具在模型选择上的快速迭代——推荐列表、免费列表和各家 provider 的默认值几乎每一版都在变化。
对于开发者,务实的做法是:升级后确认默认模型是否符合预期,检查是否有 provider 因默认值变更而影响成本或输出质量;同时留意云端会话的逐步推送,如果你的使用场景涉及长任务或多仓库并行,这个功能值得尽早尝试。
相关推荐

Kimi K3.1实测:开源模型逼近Opus,视频生成意外抢镜
Kimi K3.1在直播实测中完成运动图形、3D渲染、小游戏与视频生成等复合任务。本文分析其2.8万亿参数MoE架构的真实表现、与Opus/GPT的体感差距,以及被官方忽略的视频生成能力,并讨论多模型并用时代的工作流变化。

Sam Altman:人生重大建议,为何仍需来自人类?
OpenAI CEO Sam Altman 谈 AI 建议的边界:AI 能劝阻冲动邮件,但人生重大建议仍应来自人类。他期待 AI 成为会反驳的资深同事,而非谄媚工具。

“黑色十月”:AI挖出史上3%严重漏洞?
Reddit 热帖称过去一个月发现了史上 3% 的严重软件漏洞,被称为「黑色十月」。本文拆解这一说法的统计口径问题,分析 AI 辅助代码审计如何加速漏洞发现,以及开发者和企业该如何应对补丁窗口缩短的挑战。