CLM对比式语言模型:决策速度比TiFF快13倍的新架构
斯坦福/英伟达发布对比式语言模型CLM,将智能体决策转化为向量检索,速度比TiFF类模型快13倍。
CLM(对比式语言模型)是斯坦福与英伟达团队提出的新型决策模型,专为智能体系统中"毫秒级、非推理"的快速决策场景设计。它借鉴CLIP的双塔架构,分别用状态编码器和动作编码器将情境与候选动作映射到同一嵌入空间,通过点积打分完成决策,而非逐token自回归生成答案。关键优化在于将动作嵌入一次缓存复用,使延迟几乎不随候选数增加而上升——在约1024个选项下仅需44毫秒,比同类模型快约13倍。训练分三阶段进行,其中Gemini生成的3000万困难负样本是提升精度的核心;80亿参数骨干网络全程冻结,只训练两侧各约2000万参数的投影头。主要短板是双编码器无法并排比较选项,候选数从8增到1080时准确率从86%骤降至17%。推荐用法是将其作为粗筛第一阶段,再配合精排模型做最终决策。
随着系统级决策模型(System One)重新成为焦点,一个来自斯坦福与英伟达研究团队的新架构引发了关注——对比式语言模型(Contrastive Language Model,简称CLM)。它的核心主张颇具冲击力:决策速度最高比TiFF类模型快13倍,而准确率可与之持平。更有意思的是,这种速度提升并非来自缩小模型,而是源于一种与主流大语言模型截然不同的设计思路。
为什么"不思考"的模型重新变得重要
真实软件系统里的绝大多数决策,其实并不需要模型花30秒去"推理"。诸如"下一步该调用哪个工具""这张工单是否紧急""智能体应该点击哪个链接"这类问题,你需要的是毫秒级响应,而不是秒级甚至分钟级的等待。
这正是系统一(System One)模型回归的根本动因——快速、非推理、非思考。此前市面上已经出现了不少对标TiFF的开源复刻,但它们大多本质上仍是语言模型:读取你的文本、读取每一个选项,然后逐token地写出答案,哪怕答案只是一个带概率的单词。这种架构在选项变多、变长时成本会急剧上升。
CLM到底是什么:给决策做的CLIP
理解CLM最直观的方式,是把它想象成"用于决策的CLIP"。CLIP把图像和文本放进同一个嵌入空间,一张狗的照片会落在"a photo of a dog"这句话旁边。CLM对"情境"和"动作"做了同样的事。
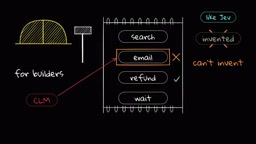
它由两个编码器组成:一个状态编码器读取"当前发生了什么",一个动作编码器读取"你可以做什么"。以马里奥遇到板栗仔为例,状态是游戏画面,动作是向左、跳跃或向右跑。做决策时,模型嵌入状态、嵌入每个选项,再根据每个选项与状态的距离打分,最后用softmax把分数转成概率——比如跳跃80%、向右15%、向左5%,马里奥就会跳。
CLM设计上兼容了TiFF的API,提供三种原语:是非题、多选题和打分。但底层其实完全一致——都是"一个状态加一组封闭的候选项",是非题不过是两个候选项(真和假)而已。这也意味着,和TiFF一样,CLM永远不会凭空捏造列表之外的答案,但它仍然可能从列表里挑错——而且会很自信地挑错。"不会幻觉"不等于"永远正确"。
CLIP(Contrastive Language–Image Pre-training)是OpenAI于2021年发布的多模态模型,它用对比学习将图像与文本映射到同一高维向量空间,使得语义相近的图文对在空间中距离更近。这一思路的核心是双塔(dual-encoder)架构:两个独立编码器分别处理不同模态的输入,最终在共享空间中用余弦相似度或点积度量匹配程度。双塔架构的最大优势是可以预先计算并缓存其中一侧的嵌入向量,查询时只需编码另一侧再做向量检索,计算量极低——这正是CLM速度优势的架构根源。其代价则是两侧编码器在计算时互相"看不见"对方,无法进行细粒度的交叉注意力比对,这也解释了为何CLM在需要区分高度相似候选项时准确率会下降。
对比学习:免费的负样本从哪来
要让正确动作真正落在状态附近,关键在于对比式训练。训练数据由大量"情境—动作"配对构成,即某人在某情境下实际采取的行动。模型的任务很简单:把每个情境拉近它对应的动作,推远其他所有动作。重复数百万次,情境就会稳稳地坐在合适动作旁边。
巧妙之处在于,你根本不需要有人去写"错误答案"。假设一次抓取1000个样本,对马里奥画面来说跳跃是正确答案,另外999个属于其他情境的动作,对这个画面而言天然就是错的。对比学习需要正负样本,而这些负样本是免费获得的。
对比学习(Contrastive Learning)是一种自监督训练范式,核心目标是让模型学习"什么和什么应该相近、什么和什么应该远离",而非预测具体标签。其损失函数通常基于InfoNCE(Noise-Contrastive Estimation的变体):对于一个正样本对,最大化其相似度,同时最小化与当前批次内其他所有样本(即"批内负样本")的相似度。批量越大,批内负样本越多,模型受到的"辨别压力"越强,学到的表示也越精细。这也解释了为什么CLM第二阶段专门引入Gemini生成的困难负样本(hard negatives)——随机负样本往往与正样本差异明显,模型容易区分;困难负样本则是语义相近但答案有误的干扰项,迫使模型在嵌入空间中做出更精确的边界划分,从而获得从52%到69%的准确率跃升。
速度的真正来源:拆分与缓存
TiFF类模型在每次调用时,都要把状态和所有选项一起喂进模型。选项翻倍或变长,就得读两倍的内容,还要逐token从大模型里解码答案,成本飙升得极快。在团队的图表中,用Qwen3-8B做约束解码时延迟会攀升到4秒以上。
CLM把两者拆开。在大多数智能体循环里,动作集合在每一步之间不变,变的是状态。于是CLM把动作嵌入一次并缓存,之后每一步只需要为状态做一次嵌入,再对选项做点积——而点积几乎是零成本运算。在马里奥演示中,这把每步的5次前向传播压缩到了1次。随着候选数从1增长到1000,CLM的延迟曲线几乎纹丝不动:在接近1024个选项时仅需44毫秒,而TiFF需要570毫秒,差距约13倍。
分三阶段训练,而且骨干网络被冻结
CLM为什么比普通嵌入模型更"懂对错"?问一个普通Qwen3-8B嵌入模型"谁写了罗密欧与朱丽叶",莎士比亚居然只排第三——因为"相似"不等于"正确"。CLM经过训练后,莎士比亚排到第一。
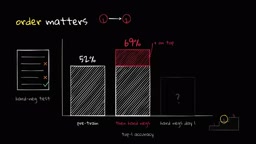
这得益于三阶段训练。第一阶段用英伟达Nemotron数据中的6000万问答对学习世界的通用知识。第二阶段最关键,团队用Gemini生成了3000万个"困难负样本",教会模型区分"听起来对"和"真的对"。顺序很重要:仅预训练在困难负样本测试上得52%,加上困难负样本阶段跳到69%;但若从第一天就用困难负样本训练,则峰值只有62%且很快过拟合。先学世界,再学细微差别。第三阶段把它变成智能体,约100万步真实智能体轨迹,同时回填40%的原始问答数据作为重放,否则困难负样本分数会从69%跌回56%。
令人意外的是,80亿参数的骨干网络是冻结的——Qwen3-8B仅作为阅读器,不接收任何梯度。真正训练的只是两侧各约2000万参数的小型投影头。因为骨干不变,整个数据集可以一次性嵌入,一次完整预训练在单张RTX上大约只要一小时。
约束解码(Constrained Decoding)是当前主流大语言模型实现结构化输出的常见方式:在自回归生成每个token时,通过限制词表或引导采样,强制模型只输出符合预定格式(如JSON、枚举值)的内容。这种方法无需重新训练模型,可以直接复用现有LLM,但每次推理仍需要完整的自回归解码过程——token逐个生成,且状态与所有候选项都要拼接进同一上下文窗口。随着候选项数量和文本长度增加,KV缓存占用与解码步骤同步膨胀,延迟急剧上升。文中提到使用Qwen3-8B做约束解码时延迟超过4秒,正是这一瓶颈的直接体现。CLM通过将决策转化为向量检索,从根本上绕开了自回归解码,这是两种架构在速度上产生量级差异的核心原因。
DGX Spark上的真实演示与短板
作者在一台DGX Spark上跑通了完整演示:Qwen3-8B编码器通过VLM服务,上层是团队发布的CLM服务器(服务本身约75MB,整体占用约25GB显存)。
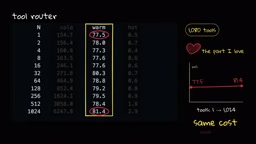
在一个"被重复扣款又联系不上客服"的工单案例中,一次调用问三个问题:是否紧急(紧急84%)、该哪个团队处理(账单99%)、客户有多沮丧(非常愤怒)。同一工单再次询问时,由于已缓存,回答在2毫秒内返回。作者还构建了一个包含1080个工具(Stripe、Trello、QuickBooks、Zoom等)的列表——而TiFF上限只有255个选项,根本放不进一次调用。首次请求因要嵌入所有工具耗时几秒,之后每次约80毫秒,从1个工具还是1000个工具里挑,耗时几乎一样。
但短板也很明显,这正是双编码器设计的经典权衡:状态独立编码,永远看不到选项,无法把选项并排比较。实验中,从8个工具里选,正确率86%;从全部1080个工具里选,骤降到17%,主要是把名字相似的工具(比如多个退款工具)搞混了。WikiRacing任务也一样,有时精准,有时乱走。
作为开发者该怎么用
CLM的本质是把"决策"变成了"检索"——编码情境,再查找动作,让1000个选项在延迟上约等于1个。但延迟能扩展,准确率却不能同比例扩展。
作者给出的实用建议是把CLM用作第一级粗筛:用它在毫秒内把上千个工具或候选项压缩到前10个,再交给能够并排阅读选项的系统二模型做最终决策。如果你的动作集合本就很小且稳定(如游戏循环、少量路由),CLM单独使用效果已经不错。切忌直接给智能体塞一千个工具,更合理的做法是拆分子智能体,每个子智能体只配备各自的工具集。
当前版本仅支持文本,团队预告下月将推出约50亿参数的多模态版本。鉴于其扩展曲线显示编码器尺寸带来的收益最大,更大的编码器恰恰有望改善"区分相似选项"这一短板,值得期待。
作者最后分享了一个观察:老算法正在回归。系统一模型让快速、非推理模型重新走红,而CLM又把2017、2018年前后火热的对比学习重新带了回来。我们或许远未触及现有算法的极限。
这种"粗筛+精排"的两阶段架构在信息检索领域有成熟先例:第一阶段用双塔模型(如BM25或向量检索)从百万级候选中快速召回Top-K,第二阶段用交叉编码器(Cross-Encoder)对少量候选进行精细重排。交叉编码器会将查询与每个候选拼接后一同输入,能做充分的交叉注意力,准确率更高,但计算量也随候选数线性增长,因此只适合在小集合上运行。将CLM类比为这套体系中的"第一阶段召回器",配合能够并排阅读选项的系统二模型作为"第二阶段重排器",是目前在延迟与准确率之间取得平衡的最优工程实践路径。
相关推荐

气态巨行星上的浮空城市:为什么人类终将移居木星云端
SFIA 主持人 Isaac Arthur 重新定义气态巨行星浮空城市:它们不是等待聚变的燃料站,而是散装氢、氦、氮的"质量城市"。本文解析其工程原理、供电方案与从工业前哨到文明家园的演化逻辑。

用Claude Code一天半做出AI测验:Vibe Coding的真实样本
一位开发者用Claude Code结合Opus 5.5与Fable 5.1,在一天半内做出一款PS1复古风格的AI主题测验游戏。本文解析这个业余项目背后的AI辅助编程实践与行业启示。

用Claude+Muse打造自动化膳食规划:AI如何替代HelloFresh
一位不懂编程的Reddit用户用Claude和Muse搭建了自动化膳食规划系统,涵盖菜单规划、沃尔玛自动下单、厨房平板界面,号称HelloFresh杀手。本文解析其工作流与AI生活自动化的启示。