Cloudflare AI缓存泄露:新开聊天为何不够

Cloudflare 事故揭示推理引擎 KV 缓存隔离失效导致跨请求数据泄露。
Cloudflare 发布 Workers AI 上 GLM 5.3 部署的事故报告,披露一起已修复的历史事件:155 条响应因推理引擎共享内存隔离失效而混入了其他请求的数据片段。根因在于上下文窗口(1,048,576 token)与准备池(681,280 token)容量不匹配,超大请求被内部拒绝后替换为单 token 占位符,但拒绝未能阻断分离式架构中的缓存传输,生成侧读取了未被覆盖的陈旧页面。报告强调 KV 缓存是临时工作状态,与模型训练权重无关。修复包括扩容缓存池与在分配前终止被拒绝请求,并通过复现与标记测试验证。事件警示:响应成功不等于隔离生效,安全评估应关注响应使用了谁的数据。
Cloudflare 在 10 月 26 日发布了一份关于 Workers AI 上 GLM 5.3 部署的事故报告。报告描述的是一起已经修复的历史事件,而非正在进行的泄露。据 YouTube 频道分析,这起事件的核心问题在于:两个用户先后发送请求,第二个回复却捎带了第一个请求的数据片段。独立来源交叉验证显示,问题的根源并非模型训练数据被污染,而是推理引擎在共享内存管理上的隔离失效。
事件回顾:一次“长提示词”触发的连锁反应
Cloudflare 将影响范围精确圈定在 155 条受影响的响应上,这些响应全部来自长度超过 681,280 个 token 的提示词。这个数字并非全部聊天请求的百分比,而是本次事故中确认受波及的样本数。暴露窗口从模型 8 月 27 日上线持续到 9 月 9 日,9 月 8 日有研究者报告了该问题,Cloudflare 在调查期间将模型下线。
事故报告特别强调,这是单一命名部署中的问题,不意味着所有 AI 服务都在泄露。但其中暴露的设计缺陷具有普遍警示意义。
关键区分:KV 缓存不是模型权重
要理解这起事故,必须先厘清一个常被混淆的概念。运行中的模型会持续维护一份针对当前处理文本的临时数值表示,业内通常称之为 key-value 缓存。这份工作状态与修改模型训练权重是两回事。数据出现在某次回复中,本身并不能证明模型被训练过该数据。
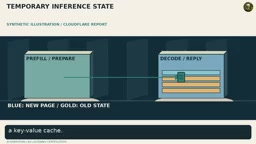
Cloudflare 的部署采用了分离式架构:一组 GPU 负责准备提示词,另一组负责生成回复。准备好的缓存需要在两组处理器之间传输。可以用编号托盘的比喻来理解:一个请求预留若干托盘,使用后释放。复用内存本身不是泄露,关键在于系统必须确保每个请求只读取属于自己的状态。所有权与完整写入,才是真正的边界。
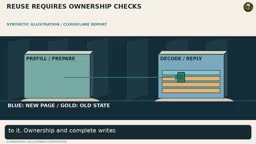
KV 缓存的技术本质:Transformer 模型在自回归生成时,每生成一个新 token 都需要对之前所有 token 重新计算注意力。为避免这种平方级重复计算,推理引擎会缓存每一层中已处理 token 的 Key 和 Value 投影矩阵,这就是 KV 缓存。其大小与序列长度、层数、注意力头数及精度(FP16/FP8)成正比,因此长上下文场景下 KV 缓存可轻易达到数十 GB,必须分页管理。分离式架构中,预填充(prefill)阶段产出的 KV 缓存需通过高速互联(如 NVLink 或 RDMA)传给解码(decode)节点,传输与内存复用正是隔离风险的来源。
根因剖析:容量不匹配与拒绝路径失效
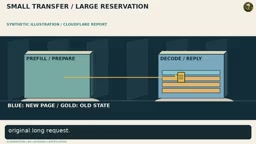
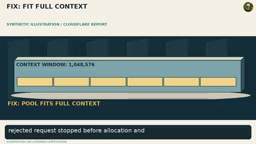
事故的直接诱因是上下文窗口与实际准备池的容量不匹配。上下文窗口允许 1,048,576 个 token,而准备池只容纳 681,280 个。一个请求可以满足对外宣称的上下文窗口,却超出了实际准备池的上限。Cloudflare 原本预期引擎会返回错误,但超大请求在内部被拒绝后,被替换成了一个单 token 的占位符。
问题出在分离式部署的交接环节:拒绝并没有阻止请求的传递。准备侧传输了占位符的小型缓存,生成侧却将其视为完整传输——尽管它已为原始长请求预留了空间。大部分预留页面并未被新请求覆盖,仍然保留着先前请求的早期数据。生成阶段读取了这些过期页面,导致另一个请求的数据混入回复。
这里有一个容易被忽视的教训:一次连贯的答案和成功的网页响应,并不能证明隔离生效。早期测试只检查了响应码和性能,没有验证输出内容的归属。
分页注意力与内存池:现代推理引擎(如 vLLM 的 PagedAttention)将 KV 缓存切分为固定大小的块(block/page),由统一的内存池按需分配,类比操作系统的虚拟内存分页。不同请求的页面在物理上可能相邻或复用,因此引擎必须维护"页表"来记录每个请求拥有哪些块。若请求被拒绝后页表未被正确清理,或新请求未完整覆盖预留页面,后续读取就会命中属于其他请求的陈旧页。这正是本次事故中"预留页面未被覆盖"的机制层面解释——隔离失效发生在页表与所有权管理,而非计算本身。
修复措施:扩容与堵住拒绝路径
Cloudflare 的即时修复分为两部分。其一,扩大缓存池以容纳完整上下文。其二,修补拒绝路径,使被拒绝的请求在分配和传输之前就停止。
据 Cloudflare 声明,两项修复在 9 月 9 日恢复模型之前,均通过了复现测试和标记测试验证。后续还进行了进一步加固。调查结论显示,在排除自身测试和研究者的请求后,没有发现故意利用的证据——这是调查发现,而非“暴露从未发生”的断言。
复现测试与标记测试:复现测试指用已知会触发的长提示词重建事故路径,确认修复后不再出现跨请求数据混入;标记测试(canary/marker test)则是在请求中植入唯一可识别的哨兵字符串,随后检查其他请求的响应中是否出现该标记。这类测试针对的是"数据归属"而非"请求是否成功",能捕捉响应码正常但内容越界的隐蔽故障,是共享推理内存架构下隔离验证的必备手段。
对运营者与用户的启示
对运营 AI 服务的一方来说,上下文限制必须与实际容量匹配;故障路径同样需要隔离测试。一个成功的请求,不仅要测它是否完成,更要测它包含了谁的数据。
对普通用户而言,新开一个聊天窗口并不能验证服务端的内部隔离。敏感材料应当谨慎对待,没有任何设置开关能修复服务器端的内存问题。
这起事件留给行业的真正问题,不是“模型能不能回答”,而是“这次回答是否只使用了本请求被允许读取的数据”。在共享推理内存成为常态的架构下,后者才是安全评估的起点。
相关推荐

Claude国内使用与充值全攻略:三种方式对比及防封控指南
整理Claude国内使用与会员充值的三种方式:海外信用卡直充、苹果美区ID与安卓Google Play内购、网站自助充值,对比各自门槛、成本与封控风险,并给出固定设备、稳定IP、不共享账号等五条降低封号概率的使用习惯。

从ChatGPT内容限制到Eval、可观测性与Guardrail实战
通过电子商店订单Agent实战,讲解ChatGPT内容限制背后的工程逻辑,以及Eval评估、Observability可观测性和Guardrail护栏如何协作,避免同名用户数据泄露与提示注入风险。

LangChain4j决策模型:本地校验Java工具调用
LangChain4j社区提出决策模型方案,在本地对Java工具调用进行校验,将控制逻辑从LLM拉回应用侧,提升工具调用的可靠性与可调试性。