Cloudflare GLM-5.3泄漏用户提示词:200 OK背后的内存残留

Cloudflare GLM-5.3因SGLang漏洞静默泄漏155条跨用户提示词,全部标记为200成功。
Cloudflare 部署的 GLM-5.3 在两周内返回了 155 条夹带其他客户提示词片段的响应,且全部带着 HTTP 200 状态码,监控层面完全不可见。根因是 SGLang 的一个 bug:超过预填充 GPU 容量(约 681,000 token)的提示本应报错,却被替换为单 token 占位符继续解码,而预留内存页在用户间未清理,模型读到了上一位用户的残留数据。Cloudflare 的测试只检查状态码和速度、不验证答案语义,使泄漏得以静默发生。该 bug 早在 7 月已被提交,自托管用户应升级至 0.5.22 版本。事件揭示了推理引擎内存管理、测试策略与开源修复节奏三者交汇处的系统性薄弱点。
一次“成功”的失败:泄漏为何被标为200 OK
据YouTube频道披露,Cloudflare上部署的GLM-5.3在两周内返回了155条答案,其中夹带了其他客户的提示词片段。最令人不安的细节不是泄漏本身,而是所有泄漏响应都带着HTTP 200状态码——从监控角度看,一切正常。
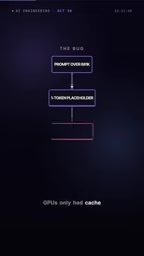
根据Cloudflare发布的复盘报告(周一发布),预填充GPU的显存容量约支持681,000个token,超出该长度的提示本应直接报错返回。但SGLang(开源推理引擎)中的一个bug把被拒绝的提示替换成了一个单token占位符,然后继续执行。解码端早已预留了内存页,而这些页在用户之间并未被清除。结果就是:模型读取了上一位用户留下的残留数据,并将其作为答案的一部分返回——全程标记为成功。
这个链条的每一环单独看都不致命,但组合起来制造了一个静默的隐私泄漏通道。状态码检查、延迟监控、吞吐量指标全部通过,因为系统“以为”自己完成了工作。
内存页未清理:SGLang的已知隐患
问题的根源在推理引擎层。SGLang作为广泛使用的开源服务框架,其解码阶段会提前分配内存页以优化性能。这些页在请求结束后本应被重置或隔离,但在这个案例中,它们没有。
当超长提示被替换为单token占位符后,解码器沿着预留的内存路径继续运行,那些未被清理的页里还留着前一个用户的上下文。模型无法区分“当前请求的输入”和“内存里的历史残留”,于是把两者一起当作上下文来生成答案。
更有意思的是,据视频内容,这个SGLang bug早在7月就被人提交过。这意味着从bug报告到Cloudflare踩坑之间,有足够的时间窗口让问题被发现和修复。开源生态的修复节奏与商业部署的更新频率之间,存在一道容易被忽视的裂缝。
SGLang 的 RadixAttention 与内存页复用机制
SGLang 之所以能高效服务大模型,核心依赖其 RadixAttention(基数树注意力)机制。它会把多个请求的 KV Cache(键值缓存)组织成一棵前缀树,让相同前缀的请求共享已计算好的内存页,从而避免重复计算。解码阶段提前分配内存页正是这一设计的延伸:系统预判后续 token 需要写入的位置,提前锁定显存空间以降低延迟。
问题在于,这种“页”是物理显存的抽象,请求结束后必须显式重置或标记为可覆盖。若引擎在异常路径(如超长提示被替换为占位符)下跳过了清理步骤,页中残留的键值向量就会成为下一个请求可见的上下文。SGLang 社区对此类问题的修复通常涉及在请求生命周期结束时强制调用页释放接口,这也是 0.5.22 版本更新的关键内容之一。
测试盲区:只量速度,不验内容
Cloudflare的复盘报告罕见地坦承了一个基础性失误:他们的测试检查了状态码和响应速度,但从未验证答案是否合理。
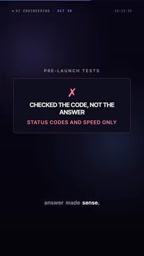
这暴露了AI服务运维中一个普遍的心态——把模型当作普通API来监控。传统服务的正确性可以通过状态码和延迟来判断,但大模型输出的“正确性”是语义层面的,不能靠200 OK来证明。当提示被静默替换、内存被跨用户复用,所有基础设施指标都显示绿色,而输出内容已经错得离谱。
值得肯定的是,Cloudflare在发现问题后40分钟内下线了该模型。只有超过长度限制的提示受到了影响,范围相对可控。但复盘报告本身的价值在于它点破了一个行业惯性:我们监控的是系统,不是答案。
为什么“语义正确性”难以监控
传统 API 监控建立在“确定性契约”上:相同的输入应产生可预期的状态码和响应结构。但大模型的输出是概率性的,同一个提示两次调用可能得到不同文本,因此无法用简单的断言来判断对错。业界常见的折中方案包括:维护一组“黄金提示”并定期比对输出的关键实体或事实片段、用另一个模型做裁判打分、或对输出做 PII/敏感词扫描。Cloudflare 此次的盲区正在于只做了基础设施层监控,未建立任何内容级抽检机制,导致跨用户数据出现在答案中却无人察觉。
对自托管与平台用户的现实提醒
如果你自己托管SGLang,视频给出的建议很直接:升级到0.5.22版本。对于使用托管模型的团队,这件事的教训更微妙——不要信任服务商宣传的上下文上限,直到你在那个尺寸上亲自验证过输出内容。
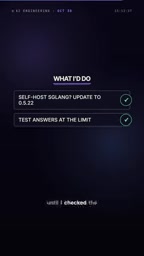
“每一条泄漏的响应都被标记为成功。这就是问题的全部。”这句话值得每个做AI基础设施的人贴在墙上。长度限制不是一个可以靠文档承诺来信任的边界,而是一个需要在真实条件下压测的工程问题。超长上下文的场景下,请求被拒绝、被截断、被替换都属正常,但被替换后还继续运行、还返回别人的数据,就是系统设计层面的失败。
从更宏观的视角看,这次事件是推理引擎内存管理、服务商测试策略、开源缺陷响应速度三者交汇处的一次事故。任何一环做对了,泄漏都不会发生。Cloudflare的复盘报告之所以被评价为“异常坦诚”,正是因为它没有把责任推给单一因素,而是把整条链路上的薄弱点都摆了出来。
681,000 token 这个数字意味着什么
681,000 个 token 约相当于 50 万英文单词或 100 万汉字量级的上下文,远超当前主流模型的公开上下文窗口。预填充 GPU 的显存容量决定了这一物理上限:KV Cache 的大小与序列长度、层数、隐藏维度成正比,长度越长占用越大。一旦提示超出容量,正确做法是拒绝请求并返回错误码。SGLang 的 bug 却用单 token 占位符“骗过”了后续流程,使系统在显存已满的情况下仍继续解码,这正是物理边界被软件逻辑绕过的典型案例。
常见问题
GLM-5.3泄漏事件影响了哪些用户?
只有提交了超过预填充GPU容量(约681,000 token)的超长提示的用户受到影响。Cloudflare在40分钟内下线了模型,未波及正常长度的请求。
自托管SGLang需要做什么?
视频建议将SGLang更新至0.5.22版本。该bug早在7月就已被提交,保持依赖更新是避免踩坑的基本动作。
为什么状态码监控没有发现泄漏?
因为泄漏响应返回的是HTTP 200,状态码和延迟指标全部正常。Cloudflare的测试只检查了状态码和速度,没有验证答案的语义合理性——这是本次事件最核心的测试盲区。
相关推荐

AI检测误判风波:作家被指用AI写作,谁该举证?
2026年英联邦短篇小说奖地区获奖者被Pangram检测工具判定100% AI生成,最终靠草稿自证清白。这起事件揭示了AI检测工具的误判风险与创作者面临的举证困境,以及作家协会承认没有可靠AI检测方法的现实。

Paul Ford新作引热议:Web本身已经足够
Paul Ford 文章《The Web Is More Than Enough》在 Hacker News 引发讨论,主张 Web 标准已足够承载应用开发,反对动辄引入封闭平台。本文梳理其核心论点、与当前 AI 应用潮流的张力,以及对开发者技术选型的实际含义。

斯坦福如何教授AI原生工程:CS146S课程揭秘
斯坦福CS146S课程直面AI一键生成作业的挑战,探索AI原生工程教育。Mihail Eric分享如何将AI作为工程伙伴,培养系统设计和代码审查能力,为工程教育提供新范本。