Cloudflare回应AI缓存漏洞:被拒绝的请求仍返回了答案

Cloudflare 复盘 AI 推理缓存隔离缺陷:超长请求被拒后仍读旧数据并静默返回 200。
Cloudflare 披露其 AI 推理服务的一起缓存隔离事故:缓存池容量 681208 token 小于 1048576 token 的上下文窗口,团队上线前已知缺口却假设引擎能自行应对。超长 prompt 被标记为 rejected 后,引擎仍换入单 token 占位符继续执行,拒绝标记未起门禁作用;同时请求间缓存页未清零,解码阶段读取了保留旧请求数据的页面,导致回复混入其他客户内容。客户端最终收到 HTTP 200 而非错误码,异常完全静默。共 5 个回复受影响,无蓄意利用证据。修复方案为扩容缓存池至完整上下文窗口,并在准入阶段直接拒绝超长请求。
Cloudflare 近日公布了一份事故复盘,披露其 AI 推理服务中存在一个隐蔽的缓存隔离缺陷:部分本应被拒绝的超长请求,不仅没有收到错误提示,反而拿到了带有其他用户请求数据的回复。这起事件的特殊之处不在于漏洞本身有多复杂,而在于多个环节的"看起来正常"叠加在了一起。
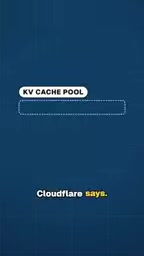
容量缺口:被知情的隐患
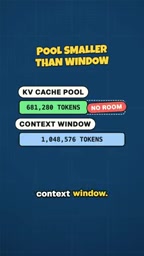
复盘显示,出问题的缓存池只能容纳 681208 个 token,而模型的上下文窗口是 1048576 个 token。两者之间存在明显的容量落差。Cloudflare 承认,在服务上线前就已经知道这个差距,但当时假设引擎能够自行应对超限情况。
这个假设成了整起事件的起点。工程团队把"引擎会处理"当成了默认前提,而没有在准入层设置硬性拦截。当系统依赖一个未经验证的兜底路径时,问题往往不会在压力测试中暴露,而是在特定输入组合下才浮现。
Token 与上下文窗口:Token 是模型处理文本的基本单位,一个 token 大致对应英文 0.75 个单词或一个汉字。上下文窗口(context window)指模型单次推理能接收的最大 token 数,其中包含输入 prompt 与生成输出。KV Cache 是 Transformer 推理中缓存历史 token 的键值对以加速解码的机制,其占用的显存与 token 数成正比。当缓存池容量小于上下文窗口时,超长请求便无处安放 KV 状态,必须依赖引擎的溢出或截断策略。这正是容量缺口的技术根源:缓存池规模需按上下文窗口上限规划,而非按平均请求长度估算。
拒绝标记不是门禁
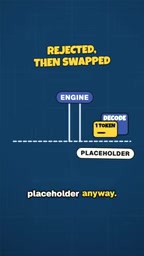
当 prompt 超出可用空间时,引擎确实将其标记为 rejected——从日志层面看,这个请求已经被拒绝。但随后引擎又换入了一个单 token 的占位符继续执行。
这里暴露的是语义与执行的脱节:"rejected"只是一个状态标记,并没有真正阻断后续流程。标记拒绝和实际拒绝是两回事,而系统把前者当成了后者。Cloudflare 在复盘中直言,一个被标记为 rejected 的 flag 并不等于一道门禁。
Rejected 标记与占位符:在推理调度器中,"rejected"通常只是请求对象上的一个布尔字段,供上层逻辑判断,并不自动中断执行流。换入单 token 占位符是一种容错设计,目的是让解码循环保持张量形状一致而继续运行,避免整批请求因个别超限而崩溃。问题在于,这种"软拒绝"把控制流与状态标记分离:调度器认为请求已被拒绝,执行器却仍按占位符推进。真正的门禁应在准入层以异常或直接返回错误的方式终止请求,而非依赖下游检查标记。
缓存页未清零,解码读到旧数据
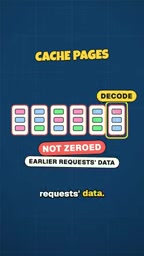
更关键的一环在于缓存管理。请求之间的缓存页没有清零,而解码步骤读取了仍然保留着此前请求数据的旧页。
这意味着即使当前请求被"拒绝",它仍可能在解码阶段接触到上一位用户留在内存页中的内容。AI 回复中出现其他客户请求的数据,正源于此。对于多租户推理服务来说,缓存复用是提升吞吐的常规手段,但复用的前提是隔离边界可靠——一旦清零逻辑缺失,性能优化就变成了数据泄露通道。
多租户推理与缓存隔离:多租户推理服务中,多个用户的请求共享同一 GPU 显存池。PagedAttention 等技术将 KV Cache 切分为固定大小的页(page),按需分配与复用,以降低显存碎片、提升吞吐。复用的前提是页在被重新分配前清零或标记失效,否则新请求可能读到上一租户遗留的键值数据。这类缺陷属于跨租户数据泄露,与传统的缓冲区未初始化问题同源。隔离边界必须由分配器强制执行,而不能寄希望于请求逻辑保证"不会读到旧页"。
HTTP 200:让异常静默
客户端最终收到的是 HTTP 200,而不是错误码。
这个细节决定了问题的发现难度。如果超限请求返回 4xx,调用方会立刻察觉并上报;但 200 意味着一切"看起来正常",异常完全静默。Cloudflare 表示,共 5 个回复受到影响,全部来自极长的 prompt,且没有证据表明存在蓄意利用。受影响范围有限,但暴露的链路问题值得警惕:状态码是调用方判断成败的唯一依据,当它与实际执行结果不一致时,监控体系就失去了作用。
状态码与可观测性:HTTP 状态码是调用方判断请求成败的第一信号,4xx 表示客户端错误(如请求过大应返回 413),5xx 表示服务端故障。当服务在逻辑上失败却返回 200 时,调用方的重试、告警与熔断机制全部失效,监控指标也只反映"成功"。对推理服务而言,应在响应体中附带明确的完成原因(finish_reason),并让准入拒绝映射为 4xx,使异常在链路各层都可被观测。静默失败往往比显式报错造成更长的故障暴露时间。
修复思路与工程启示
Cloudflare 给出的修复方案有两部分:一是将缓存池扩容至能容纳完整上下文窗口,二是在准入阶段直接拒绝超长请求。前者消除容量缺口,后者确保拒绝发生在执行之前而非之中。
从这起复盘可以提炼出几条对 AI 推理服务有普遍意义的经验:容量规划不能依赖引擎的隐式兜底,拒绝逻辑必须落实为执行层的硬拦截而非状态标记,缓存复用必须配套可靠的数据清零机制,而错误必须通过状态码显式传递给调用方。任何一环做到位,这起事件都不会以"静默返回他人数据"的形式出现。
Cloudflare 的坦诚复盘本身也提供了一个样本:把"上线前就知道但假设能应付"这类决策如实写进事故报告,比单纯公布修复方案更有参考价值。
相关推荐

beacon.sh:为AI编程助手装上自我进化记忆
beacon.sh 是一款开源、可自我进化的 AI 编程代理记忆层,支持 Claude Code、Cursor、Codex 等 20 多个 harness,把代理会话转化为复利式知识层,解决跨工具记忆断层问题。

Xmind 2027发布:思维导图进化为AI思考伙伴
Xmind 2027 在 Product Hunt 发布,主打「AI 思考伙伴」定位。新增 Xmind Agent 支持基于本地文档与导图做研究,并通过 MCP 将导图上下文接入 ChatGPT、Claude 等 AI 工作流。本文解析其产品逻辑、差异化优势与待验证的问题。

UnleashX:像雇人一样雇佣AI员工,对话直接交付成果
UnleashX在Product Hunt上线,主打像雇人一样雇佣AI员工:选角色、连CRM和工具、设规则,端到端执行工作流,人类仅在必要时介入。本文分析其产品定位、配置逻辑与人机协作边界。