Cloudflare开源安全审计技能:让AI Agent变身代码审计师
Cloudflare 开源 Security Audit Skill,让 AI Agent 六阶段自动审计并对抗式验证漏洞。
Cloudflare 开源了 Security Audit Skill 项目,一周内 GitHub 新增 16,000 颗星,总星数近 52,000。该技能包可一条命令安装到 Cloud Code 或 Cursor,将安全审计拆解为六个阶段,从架构映射到生成报告形成流水线。其核心机制是对抗式验证:每个发现的漏洞交由全新 Agent 专门证伪,以减少误报;结果输出为结构化 findings.json,问题标记为 confirmed、needs validation 或 rejected,并支持基于上次结果的增量审计。项目降低了中小团队的安全审计门槛,适合作为上线前的早期防线,但不能替代专业渗透测试或人工代码审查。
Cloudflare 最近开源了一个名为 Security Audit Skill 的项目,它能让 AI Agent 自动执行安全审计。据 YouTube 视频介绍,该项目在 GitHub 上迅速获得关注,一周内新增 16,000 颗星,总星数接近 52,000。一位前端开发者强烈建议在项目上线前运行它。
它是什么:六阶段自动化审计流程
Security Audit Skill 是一个可安装在 Cloud Code 或 Cursor 中的技能包,通过一条命令即可安装。它将安全审计拆解为六个阶段,从绘制架构图到生成最终报告,形成完整的流水线。
这种分阶段设计让审计过程结构化,避免了传统聊天式交互的随意性。每个阶段都有明确的目标,便于追踪进度和复现结果。
Cloud Code 与 Cursor 是什么?
Cloud Code 和 Cursor 都是面向 AI 辅助开发的编程工具。Cursor 是一款基于 VS Code 分支构建的 AI 优先代码编辑器,内置了对大模型对话、代码补全与 Agent 式任务执行的支持,开发者可以在编辑器内直接让 AI 读取代码库并执行多步操作。Cloud Code(此处应指 Cloudflare 相关的 AI 编码/Agent 运行环境,或与 Claude Code 类似的命令行编码 Agent)则提供一个可安装“技能包”的运行时,允许把结构化的任务流程封装成可复用技能。Security Audit Skill 之所以强调可安装到这两类工具中,是因为这类环境能赋予 Agent 文件读写、命令执行和代码库遍历能力,从而让六阶段审计流程真正自动化落地,而不仅是停留在对话建议层面。
核心机制:对抗式验证与结构化输出
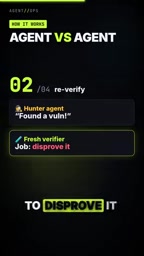
该项目最引人注目的设计是“对抗式验证”:每个被发现的漏洞都会交给一个全新的 Agent,其唯一任务是试图证伪该漏洞。这种机制模拟了红蓝对抗,能有效减少误报。
审计结果不再是一堆聊天记录,而是结构化的 findings.json 文件。每个问题都被标记为 confirmed(已确认)、needs validation(需验证)或 rejected(已拒绝),方便团队直接导入 issue 跟踪系统。
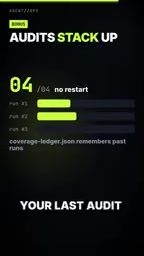
此外,重复运行时会基于上一次的审计结果继续,而不是从头开始。这意味着随着代码迭代,审计可以增量进行,节省时间和计算资源。
误报(False Positive)为何是安全审计的核心痛点?
静态分析与自动化扫描工具长期面临高误报率问题:规则匹配或模式识别会把看似危险的代码判定为漏洞,但实际可能已有上下文防护或并不可达。安全团队若逐一人工复核,成本极高;若直接忽略,又可能漏掉真实问题。对抗式验证的思路是把“证伪”作为独立任务交给一个新的 Agent,使其不受最初发现者结论的影响,专门寻找该漏洞不成立的证据。这与红蓝对抗中蓝队尝试反驳红队发现的结构类似,本质上是引入第二意见来过滤噪声。对 AI 审计而言,这能显著提升 confirmed 结果的可信度,但也会增加计算开销,因此增量审计机制显得尤为重要。
为什么值得关注:降低安全审计门槛
对于中小团队或个人开发者,专业安全审计成本高昂。Security Audit Skill 将审计能力封装为 AI Agent 可执行的技能,让开发者在日常编码环境中就能快速自查。
不过,需要理性看待其定位:它不能替代专业渗透测试或人工代码审查,而是作为一道早期防线,帮助发现常见漏洞模式。视频中的前端开发者建议在项目发布前运行它,正是基于这种“早发现早修复”的思路。
AI Agent 安全审计与专业渗透测试的边界
专业渗透测试(Penetration Testing)是由安全工程师模拟真实攻击者,对系统进行授权范围内的主动攻击测试,覆盖业务逻辑漏洞、权限绕过、供应链攻击等复杂场景,通常伴随人工研判与定制化利用链构造。AI Agent 驱动的审计更接近自动化代码审查与模式匹配的增强版:它擅长发现常见漏洞模式(如注入、硬编码密钥、不安全反序列化),但难以理解深层业务语义或执行多步攻击链。因此,Security Audit Skill 的合理定位是“上线前自查”与“持续集成中的早期防线”,而非合规性渗透测试的替代品。团队应将其输出作为待验证线索,confirmed 项优先修复,needs validation 项交由人工结合业务上下文判断。
快速上手与注意事项
安装仅需一条命令,支持 Cloud Code 和 Cursor。运行后,按照六个阶段推进,最终查看 findings.json 中的分类结果。对于 confirmed 的问题应优先修复,needs validation 的问题可结合人工判断,rejected 的问题则无需处理。
由于项目热度极高,建议关注其 GitHub 仓库的更新和社区反馈,以了解实际使用中的误报率和覆盖率。
相关推荐
Microsoft Fabric数据库Agent实战:从被动救火到智能侦探
深入解析Microsoft Fabric数据库Agent的功能与配置方法:如何启用、支持的监控场景、阻塞问题演示,以及从被动响应到自主运维的产品路线图。

Zendesk用ChatGPT Enterprise打造千名日活销售Agent
Zendesk向全员开放ChatGPT Enterprise,员工自行构建约600个应用,其中销售扩张智能体日均约1000名活跃用户。本文分析其如何将内部数据转化为销售机会,以及“不要等待”的落地策略。
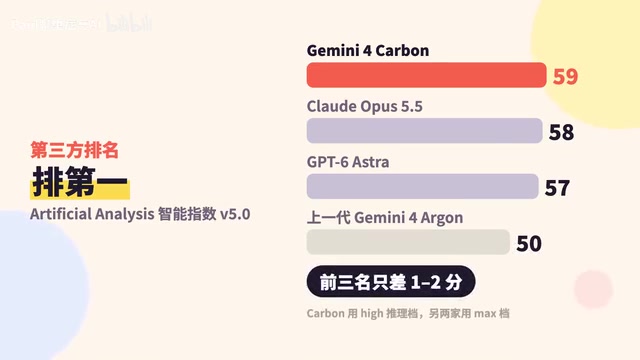
谷歌发布Gemini 4 Carbon:最强模型首发主打网络安全
谷歌发布Gemini 4 Carbon,称其为最强模型,主打网络安全能力,第三方综合排名以59分居首但领先优势仅一两分。本文解析其安全测试表现、分阶段开放策略、Token定价及自测与第三方测试在幻觉问题上的分歧。