CMNIE:中文军事新闻信息抽取基准数据集深度解读

CMNIE:首个面向中文军事新闻的联合信息抽取基准,揭示LLM在精确结构化抽取上的明显短板。
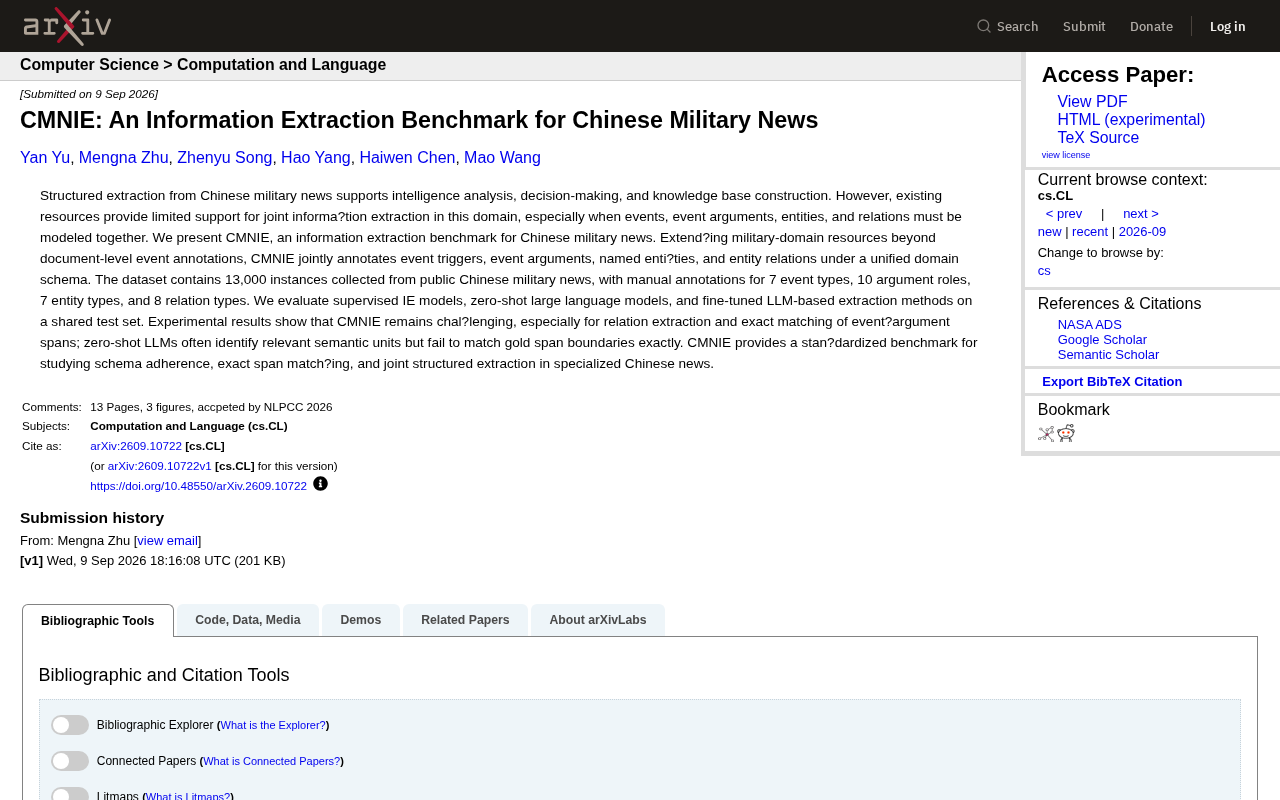
CMNIE(Chinese Military News Information Extraction)是一个专为中文军事新闻设计的信息抽取基准数据集,包含13,000条人工标注实例,在统一Schema下同时标注事件触发词、事件论元、命名实体和实体关系四类信息,涵盖7种事件类型、10种论元角色、7种实体类型和8种关系类型。研究团队在该数据集上横向比较了有监督模型、零样本大语言模型和微调LLM三类范式,结果表明关系抽取和事件论元精确跨度匹配是主要难点。尤其值得警惕的是,零样本LLM虽具备较强的语义理解能力,却难以实现字符级别的精确边界对齐,表明在需要严格Schema约束的专业场景下,有监督建模和针对性微调仍不可替代。CMNIE为垂直领域结构化抽取研究提供了可复现的标准化评测平台。
结构化抽取在军事情报领域的价值
从海量中文军事新闻中提取结构化信息,对情报分析、辅助决策以及知识库构建不能忽视。然而长期以来,这一领域缺乏能够支撑联合信息抽取(Joint Information Extraction)的高质量资源——尤其是当事件、事件论元、实体和关系需要被统一建模时,现有数据集的支持能力十分有限。
近日,一篇发表于 arXiv 的论文提出了 CMNIE(Chinese Military News Information Extraction),一个专门面向中文军事新闻的信息抽取基准数据集。它试图填补该领域在细粒度、多任务联合标注方面的空白。
CMNIE 数据集的核心设计
统一的领域标注体系
与以往军事领域资源大多停留在文档级事件标注不同,CMNIE 在一个统一的领域 Schema(模式)下,同时对四类信息进行联合标注:
- 事件触发词(Event Triggers)
- 事件论元(Event Arguments)
- 命名实体(Named Entities)
- 实体关系(Entity Relations)
这种设计的意义在于,军事新闻中的信息往往是高度关联的。一个作战事件不仅涉及触发词本身,还牵连到参与实体、时间地点、装备武器以及各实体之间的从属或对抗关系。只有将这些要素放在同一框架下建模,才能真正还原新闻文本背后的结构化知识。
数据规模与标注粒度
根据论文披露,CMNIE 包含 13,000 条实例,全部采集自公开的中文军事新闻,并经过人工标注。其标注体系覆盖:
- 7 种事件类型
- 10 种论元角色
- 7 种实体类型
- 8 种关系类型
这样的粒度设计,使得数据集既能支持传统的事件抽取任务,也能满足命名实体识别与关系抽取的评测需求,为多任务联合建模提供了扎实的数据基础。
实验评测:三类主流方法的横向比较
研究团队在共享测试集上评测了三类主流的信息抽取方案:
- 有监督的信息抽取模型(Supervised IE Models)
- 零样本大语言模型(Zero-shot LLMs)
- 经过微调的基于 LLM 的抽取方法(Fine-tuned LLM-based Methods)
通过对比这三类范式,论文试图回答一个关键问题:在专业领域的中文文本上,当前的信息抽取技术究竟处于什么水平?
关系抽取与精确跨度匹配仍是核心难点
实验结果表明,CMNIE 对现有模型而言依然极具挑战性,主要体现在两个方面:
- 关系抽取(Relation Extraction):模型在识别实体间复杂关系时表现不佳,这符合关系抽取任务本身高难度的特征。
- 事件论元跨度的精确匹配(Exact Matching of Event-Argument Spans):模型难以准确界定论元的边界。
一个尤为值得关注的现象是:零样本大语言模型往往能够识别出相关的语义单元,却无法精确匹配黄金标准(gold span)的边界。换句话说,LLM"大致知道"答案在哪里,但难以做到字符级别的精准对齐。这一发现对当前依赖 LLM 进行零样本抽取的实践提出了警示——语义理解能力强并不等同于结构化抽取的高精度。
CMNIE 的研究意义与启示
为专业领域信息抽取提供标准化评测标尺
CMNIE 的最大价值在于,它为研究以下三个核心问题提供了一个标准化基准:
- Schema 遵循度(Schema Adherence):模型输出是否符合预定义的领域模式;
- 精确跨度匹配(Exact Span Matching):抽取结果的边界精度;
- 联合结构化抽取(Joint Structured Extraction):多任务协同建模的能力。
在通用领域信息抽取基准日益成熟的今天,专业垂直领域(尤其是中文军事新闻这类高价值场景)的评测资源相对稀缺。CMNIE 的出现,为该方向的后续研究提供了可复现、可对比的评估平台。
对 LLM 时代信息抽取范式的反思
随着大语言模型在各类 NLP 任务上展现出强大的零样本能力,业界一度乐观地认为 LLM 可以"开箱即用"地处理信息抽取。然而 CMNIE 的实验结果提醒我们:在需要严格 Schema 约束和精确边界对齐的专业场景下,零样本 LLM 仍有明显短板。微调、有监督建模以及针对边界匹配的专门优化,在可预见的未来仍将是不可或缺的技术路径。
总结:中文军事信息抽取的新标杆
CMNIE 通过统一 Schema 下对事件、论元、实体和关系的联合标注,填补了中文军事新闻信息抽取领域的资源空白。其 13,000 条人工标注实例和多维度评测框架,不仅揭示了当前技术在关系抽取和精确跨度匹配上的局限,也为专业领域的结构化抽取研究树立了新的标杆。对于关注垂直领域 NLP、军事情报分析自动化以及大语言模型结构化输出能力的研究者而言,CMNIE 是一份值得深入关注的基准资源。
相关推荐

零基础用WorkBuddy做AI漫剧:技能包保姆级安装教程
零基础如何用WorkBuddy制作AI漫剧?本文详解WorkBuddy安装、Skill技能包导入与调用全流程,附剧本生成实操演示与人工修改技巧,帮你跑通AI漫剧从剧本到分镜的第一步。

WorkBuddy智能体一句话跑通GEO数据库挖掘全流程
WorkBuddy智能体实现GEO数据库挖掘全自动化:从数据搜索、下载整理到批次校正、差异分析、共表达网络、特征基因筛选及免疫浸润分析,一句话提示词即可生成完整生信分析报告,大幅降低生信分析门槛。

PC内存被浪费?Hacker News热议集中式数据中心之争
Hacker News用户提出个人电脑内存被浪费、应集中到数据中心的观点,引发关于集中式与分布式计算资源分配的讨论。本文分析该观点背后的逻辑、集中化的代价,以及AI时代内存资源分配的新张力。