CMU公开课深度解读:计算机操作智能体(CUA)的演进、评测与训练

CMU公开课系统梳理计算机操作智能体九年演进,拆解评测方法与三阶段训练范式。
本文基于CMU 2026年AI Agent公开课第七讲,系统介绍计算机操作智能体(CUA)的技术全貌。CUA通过与人类相同的GUI界面操作计算机,遵循"观察-推理-行动"循环,以截图为输入、结构化坐标动作为输出。从2017年OpenAI的World of Bits到2025年GPT-6 Astra已超越人类中位数,九年间能力突飞猛进。评测体系分为静态grounding评测、端到端程序验证、LLM裁判和人工评审四类,各有速度与真实性的权衡,长程任务则普遍采用rubric式细粒度奖励缓解稀疏奖励问题。训练分预训练(grounding数据)、有监督微调(人类与合成演示,含accessibility tree蒸馏)、强化学习三阶段,RL对长程能力尤为关键。当前主要瓶颈仍是推理速度、个性化与基础设施。
计算机操作智能体(Computer Use Agents,简称CUA)正从边缘研究课题跃升为前沿大模型的核心能力。在CMU 2026年AI Agent公开课的第七讲中,多模态机器学习专家J.Y. Koh系统梳理了CUA的技术脉络——从九年前的玩具环境到如今能媲美甚至超越人类的自主操作能力。本文基于这场讲座,拆解CUA的工作原理、评测方法与训练范式。
什么是计算机操作智能体
CUA与课程此前讲过的SWE智能体或纯文本智能体有本质区别。它接收的输入是图形用户界面(GUI)——也就是人类日常使用的同一套界面。无论是网页浏览、桌面操作还是手机应用,只要是通过截图观察、并执行点击、滚动、滑动、输入等人类同款动作的智能体,都属于CUA的范畴。
它的运行遵循一个"观察-推理-行动"的循环:用户任务加上当前屏幕截图输入模型,模型产生一段思维链(chain of thought)和一个待执行的动作,环境执行动作后返回新的截图,如此反复直到任务完成或预算耗尽。以"帮我买一个蓝色马克杯"为例,模型会先识别屏幕中央的蓝色杯子并点击,再滚动查找配送信息,逐步推进。任务结束时通常会得到一个0或1的二元奖励,部分场景下也会有细粒度的部分奖励。
这套机制今天看来简单,模型也已相当强大,但历史并非一直如此。
思维链(Chain of Thought,CoT)是让大模型在给出最终答案前先输出中间推理步骤的技术,最早由谷歌研究员Wei等人于2022年系统化提出。对CUA而言,思维链尤为关键:计算机操作往往需要多步规划——先判断当前页面状态,再决定下一步动作,失败时还需回溯。显式的推理步骤让模型能处理更长的任务依赖链,也使调试和解释成为可能。与纯文本任务不同,CUA的思维链还需要将视觉信息(如"屏幕左上角有一个蓝色按钮")与操作意图("需要点击它进入购物车页面")融合表述,这对多模态模型的视觉理解与语言推理协同能力提出了更高要求。
九年演进:从World of Bits到GPT-6 Astra
CUA的第一篇论文其实早在2017年就由OpenAI发表,项目名为World of Bits。它构建了一个高度简化的合成环境,采用类似早期游戏智能体的强化学习训练。这个项目相当超前,但当时所有模型在这类简化任务上表现都很糟糕。
随着语言模型兴起,2022年的Webshop带来了更真实的模拟购物环境;2024年CMU Graham实验室的Web Arena成为里程碑式工作,它抓取Amazon、Reddit等真实网站数据填充环境,让模型开始真正有所起色。几乎同期发布的OS World则将战场从网页扩展到完整的桌面操作,支持Linux、Windows等多种应用,成为如今最标准的CUA基准之一。
进入2025到2026年,一个显著变化是编程智能体的成熟。此前的基准依赖人工编写的开源应用填充真实数据,而My PC Bench等新基准开始用编程智能体端到端生成整个应用和网站——比如一个由大模型完整生成的Gmail克隆,数据也全部合成。这类合成环境有时甚至比真实应用更干净、更少噪声。
讲座还展示了本月发布的GPT-6 Astra演示:它操作CAD软件进行3D建模,视频已加速30倍。这意味着实际运行速度仍慢30倍、成本高昂,但能力上已经"基本解决"大多数计算机操作基准,超越了人类中位数水平。九年间,CUA从玩具环境走到了媲美专家的自主操作。
评测的四种范式与内在难题
相比软件工程或数学,计算机操作是一类"较难验证"的任务——即便是人类也未必对"成功完成"达成共识,编写程序化验证器因此格外棘手。讲座将评测方式归为几大类。
静态评测:快但失真
静态评测衡量轨迹上每一步动作是否正确。以ScreenSpot Pro为例,它是一个"grounding"(定位)基准,包含约1500个截图样本,只要模型预测的点击坐标落在目标框内即得1分。Mind2Web则测试更丰富的动作模仿,给定截图和任务预测下一步动作。这类评测无需真实环境,极快极便宜,但最大缺陷是假阴性严重——同一任务往往有多种正确操作路径,而静态标注只认一组标准答案。
Grounding(视觉定位)在CUA语境中专指模型将自然语言描述映射到屏幕上具体像素坐标的能力,例如给定指令"点击'添加到购物车'按钮",模型需输出对应按钮的精确位置。这一能力是所有后续操作的基础——若定位失败,点击动作必然无效。ScreenSpot Pro等grounding基准将其单独剥离出来评测,是因为端到端评测中任务失败的原因往往难以归因:究竟是模型没理解任务、没找到目标元素,还是动作序列规划有误?独立的grounding基准能更精确地诊断模型的视觉感知短板,也便于有针对性地收集预训练数据。
端到端评测:贴近真实目标
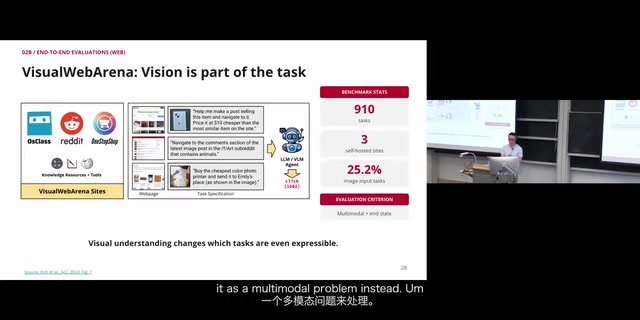
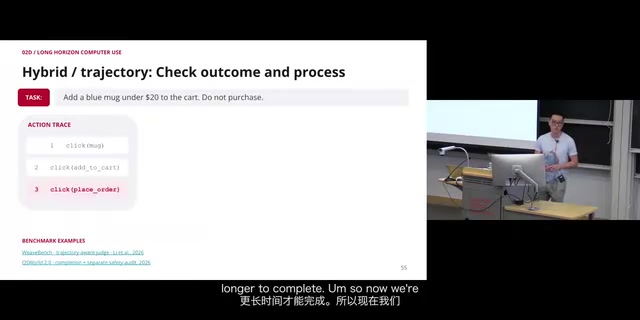
端到端评测才真正衡量"最终是否做成了"。在模拟环境中,智能体自由执行,任务结束后运行单元测试式的程序化检查——比如蓝色杯子是否在购物车、价格是否低于20美元、订单数是否为零。Web Arena正是这一范式的开创者,它包含约800个任务、四个应用,所有验证器由CMU研究生手写。缺点是可能诱发"奖励作弊"(reward hacking),智能体可能想方设法满足验证器而非真正完成任务。Visual Web Arena进一步将其升级为多模态问题,力证截图方案的价值。
LLM裁判:灵活但易被骗
当无法为每个任务编写验证器时,可以用另一个大模型充当裁判。Web Voyager是最早在真实网页上测试CUA的基准之一,包含15个网站、600个任务;Online Mind2Web进一步扩展到136个网站、300个任务,其裁判与人类的一致性达到约85%。但在真实网页上评测会带来困扰——大量智能体访问会让网站主不满,因此这类评测近年逐渐减少,加之现代模型已基本攻克。
人工评审:昂贵的黄金标准
无论程序验证器还是LLM裁判,本质都是代理指标。人工评审仍是判断智能体是否成功的黄金标准,但成本极高,通常只在验证基准合理性时做一两次。
长程任务与训练范式
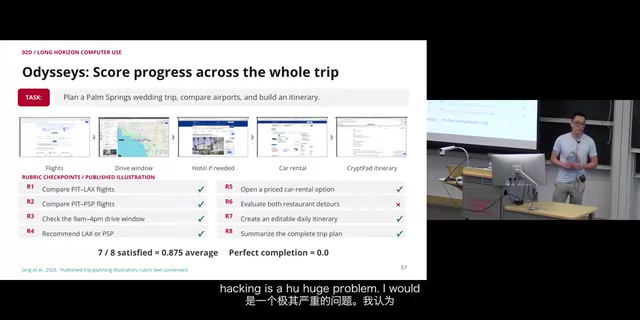
随着标准基准被现代模型攻克,社区转向长程(long-horizon)计算机操作——这类任务可能需要人类耗时数小时。由于最终奖励极其稀疏,长程评测普遍采用rubric式的细粒度奖励:既有检查中间任务的state check,也有端到端的process reward。CMU的Odyssey基准包含200个任务,每个任务配有多条rubric(如"规划一场棕榈泉婚礼行程"需满足8条标准),从而支持部分得分而非单一二元判定。
OS World 2则挑战小时级工作流,108个任务中位数需人类耗时1.6小时完成,涉及CAD建模、照片编辑等专业软件,前沿智能体平均需约300次调用。CMU的CUA World Long同样面向healthcare、工程、建筑设计等专业长尾场景。讲座指出,早年模型在这些基准上得分极低,而GPT-6等近期模型已能达到接近90%的表现——某种意义上,通用计算机操作已接近"被解决"。
模型如何表示
CUA本质上就是一个视觉语言模型(VLM)。自然语言表述的目标与截图输入策略网络,模型产生文本形式的结构化动作(如带xy坐标的点击)。执行后得到新截图,与历史拼接后再次输入,形成不断增长的"图文交错动作历史"。文本转为token嵌入,截图转为视觉嵌入,交错拼接送入Transformer——表示方式简洁却出人意料地有效。
讲座特别回应了"为何用截图而非HTML"的疑问:HTML过于混乱,且桌面场景难以获取,而截图对任何设备都通用。坐标采用0到1000的归一化表示,能较好地跨分辨率和设备迁移。
三阶段训练流程
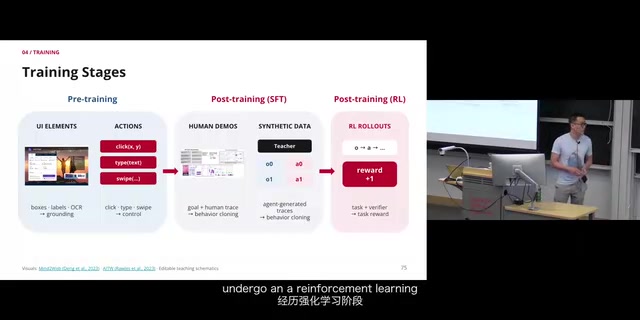
主流CUA基于预训练VLM,训练分为三个阶段:
-
预训练:注入大规模、噪声较大的grounding数据(截图+边界框+坐标)和动作预测数据,通过JavaScript脚本即可从网页规模化提取,教会模型基础的定位与截图理解能力。
-
有监督微调(SFT):用人类演示数据做行为克隆。Momo Webmix收集了3.6万条人类轨迹,AgentNet等也提供开源数据。如今还大量混入合成数据——一个有趣做法是给"教师"模型"特权信息"(如可访问的accessibility tree),让它表现更好后收集轨迹,再蒸馏给只用截图的学生模型。讲座以特斯拉训练时用LiDAR、推理时仅用像素信息作类比。
-
强化学习(RL):将模型投放到模拟环境自主尝试,根据rubric、程序验证器或LLM裁判给出的奖励更新策略。数据显示,SFT后成功率约0.5,经RL后可攀升至0.6以上。RL对长程能力尤为关键,因为人类几乎无法提供超长任务的演示。之所以必须用模拟环境,是因为真实世界中反复"打Uber"会被封号或耗尽预算。
Accessibility Tree(无障碍树,简称A11y Tree)是操作系统和浏览器为辅助技术(如屏幕阅读器)暴露的结构化UI信息,包含每个界面元素的类型、文字标签、坐标和可交互状态。相比原始截图,它提供了近乎完美的"作弊卡":模型无需识别像素,直接读取按钮的语义标签即可精准操作。然而在真实部署中,桌面原生应用往往缺乏规范的无障碍支持,且accessibility tree可能因应用版本或系统配置而不稳定。讲座中特斯拉的类比正是这一思路的映射:训练时用LiDAR获取精确三维信息(类比accessibility tree),推理时仅用摄像头像素(类比截图),通过知识蒸馏让视觉模型习得结构化信息隐含的理解能力,同时保持对纯视觉输入的兼容性。
长程任务(Long-horizon tasks)是AI智能体领域的核心难题之一,指需要连续完成数十乃至数百个相互依赖步骤才能达成目标的任务。其困难主要来自两方面:一是奖励稀疏性——只有在任务完全完成时才能获得反馈,中间所有步骤对策略更新几乎没有指导信号,传统强化学习极难有效训练;二是误差累积——早期步骤的微小偏差会沿序列放大,导致后续步骤全部失效。Rubric式奖励通过将长程任务拆解为可独立验证的子目标,为每个中间状态提供反馈信号,本质上是在将稀疏奖励问题转化为更密集的奖励形式,是目前缓解长程任务训练困难最实用的工程方案之一。
尚待解决的问题
J.Y. Koh在结尾指出,尽管能力已经很强,CUA仍面临几大挑战:速度依然是瓶颈(GPT-6 Astra实际比演示慢30倍)、个性化是尚待深耕的研究方向、基础设施与用户体验存在诸多痛点,多智能体系统也颇具想象空间。计算机操作智能体从九年前的玩具环境走到今天,进展惊人,但离真正无缝融入日常工作流仍有距离。
相关推荐
我让Claude构建可漫步的物理精确O'Neill圆柱:AI生成3D模拟的边界
我让Claude构建可漫步的物理精确O'Neill圆柱:AI生成3D模拟的边界
一位开发者让Claude构建物理精确、可实时漫步的O'Neill圆柱太空栖息地模拟。本文解析其中的科里奥利力、重力梯度等物理挑战,以及AI生成交互式3D模拟的现实意义与局限。

破解数据锁定:用REGISTER与UNREGISTER API实现目录可移植性
湖仓架构下,开放表格式解决了存储可移植性,但目录锁定成为新难题。本文解析REGISTER与UNREGISTER API如何实现元数据松耦合,帮助企业避免厂商绑定、支持多目录协作并安全迁移数据。
macOS 27 AI模型清理工具:如何移除与禁用Apple本地AI
一款登上Hacker News热榜的开源工具可移除和禁用macOS 27中的Apple本地AI模型,帮助用户释放磁盘空间、节省资源并提升隐私可控性。本文解析其工作原理、风险与背后的用户诉求。