Codex APP全面解析:与Claude Code对比及选择策略

引言:AI编程工具进入多形态时代
OpenAI的Codex近期推出了独立APP版本,这意味着Codex目前已经拥有了四种使用形态:终端(CLI)、网页端、IDE插件以及独立APP。
AI编程工具的多形态布局反映了开发者工作流的多样性。认知负荷理论(Cognitive Load Theory)在软件工程领域的应用表明,工具切换本身会产生「上下文切换成本」——开发者每次在不同工具间跳转,都需要重新加载心理模型,这一过程平均消耗15-23分钟才能恢复深度专注状态。
认知负荷理论背景:该理论由澳大利亚教育心理学家John Sweller于1988年提出,最初用于解释学习过程中的心理资源分配问题。理论将人类工作记忆视为容量有限的资源,并将认知负荷分为内在负荷(任务本身的复杂度)、外在负荷(信息呈现方式带来的额外负担)和相关负荷(促进学习的有效认知活动)三类。在软件工程领域,每次切换工具时,开发者不仅需要重新适应不同的操作界面和快捷键体系,还需要在工作记忆中重建当前任务的完整心理模型,包括代码逻辑、变量状态、调试思路等多维度信息——这正是工具切换成本如此高昂的根本原因。
因此,四种形态的布局本质上是在最小化这种切换成本:终端(CLI)形态面向习惯命令行操作的工程师,可无缝融入脚本自动化流程;IDE插件形态(如VS Code Extension)是目前最主流的集成方式,通过Language Server Protocol(LSP)与编辑器深度绑定,实现实时代码补全和内联建议;网页端降低使用门槛;而独立APP则为希望将AI作为「思考伙伴」而非「代码补全器」的开发者提供了独立的交互空间。
LSP是微软于2016年随VS Code一同提出的开放协议标准,其设计动机源于一个长期困扰开发工具生态的工程问题:在LSP出现之前,每种编辑器(Vim、Emacs、Eclipse等)都需要为每种编程语言单独实现代码补全、跳转定义、错误诊断等智能功能,M种编辑器×N种语言意味着M×N份重复工作。LSP通过定义统一的JSON-RPC通信协议,将这一复杂度降低为M+N,彻底改变了开发工具生态的协作方式。其核心设计思想是将「编辑器UI」与「语言智能服务」彻底解耦:编辑器只需实现LSP客户端,语言服务只需实现LSP服务端,双方通过JSON-RPC协议通信。对AI编程工具而言,这意味着服务商只需实现一个符合LSP规范的语言服务端,即可被所有支持LSP的编辑器复用——这正是GitHub Copilot、Codex插件等工具能够同时支持VS Code、JetBrains、Neovim等不同编辑器的技术基础。
网页端形态降低了使用门槛,无需安装任何本地环境;而独立APP形态则代表了更高的产品化程度,通常具备项目级上下文管理、多文件协同编辑、可视化任务追踪等插件形态难以实现的功能。从软件架构角度看,独立APP能够完整控制本地文件系统读写权限、维护跨会话的持久化项目记忆、内嵌终端执行环境以实现「生成-运行-调试」闭环,这些能力在受沙箱限制的浏览器插件或受宿主IDE框架约束的扩展中均难以完整实现。对于许多开发者来说,过去使用Codex主要是通过在VS Code等开发工具中集成插件的方式,而现在APP形态的出现,让Codex的能力得到了更完整的释放。
值得一提的是,Codex并非新生事物。它最初于2021年作为GPT-3的衍生模型发布,专门针对代码生成任务进行了微调训练,训练数据涵盖GitHub上超过540万个公开代码仓库、约54GB的代码文本,覆盖Python、JavaScript、Go、Ruby等数十种编程语言,曾是GitHub Copilot的底层引擎。这一阶段的Codex本质上是一个「代码补全引擎」,上下文窗口仅约4K tokens,只能处理单文件级别的代码理解任务。
2023年后随着GPT-4系列模型的崛起,Codex经历了深度架构升级——这次升级的意义远不止于参数规模的扩大:GPT-4引入的多模态能力使Codex能够直接读取UI截图或架构图作为输入;而128K tokens的超长上下文窗口(相当于约10万行代码)则是从「代码补全工具」向「编程智能体」跃迁的关键技术分水岭,使模型能够在单次推理中理解整个中型项目的代码库结构、依赖关系和业务逻辑,从而执行跨文件重构、自动生成测试用例、识别潜在安全漏洞等复杂多步骤任务,不再局限于单行或单函数的代码补全。2024-2025年独立APP形态的推出,则标志着Codex从API能力向完整产品体验转型的第三阶段正式开启。
上下文窗口扩展的工程代价:将上下文窗口从4K扩展到128K tokens,并非简单的参数调整,而是涉及Transformer架构中注意力机制(Self-Attention)的根本性挑战。标准自注意力的计算复杂度为O(n²),即序列长度翻倍,计算量翻四倍。处理128K tokens所需的显存和计算量,约是处理4K tokens的1024倍。为此,OpenAI等机构引入了稀疏注意力(Sparse Attention)、滑动窗口注意力(Sliding Window Attention)以及FlashAttention等IO感知算法,将实际计算复杂度降低至接近O(n log n)甚至O(n),才使得超长上下文在工程上变得可行。这一技术突破是AI编程工具从「代码补全」向「项目级理解」跃迁的底层基础设施保障。
在AI编程工具层出不穷的今天——Cursor、Claude Code、Codex三足鼎立——开发者该如何选择?本文将从价格、特性、适用场景等维度,深入分析Codex APP的优势与定位。
Codex与Claude Code核心差异对比
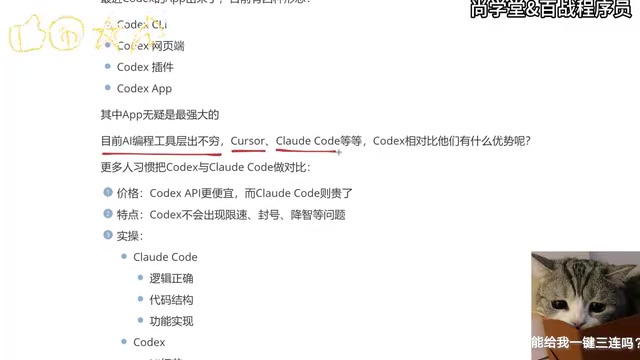
价格优势:Codex更具性价比
从API调用成本来看,Codex的定价相比Claude Code更为亲民。对于高频使用AI辅助编程的开发者来说,长期累积下来的成本差异相当可观。尤其是对独立开发者和小团队而言,价格往往是决定工具选择的关键因素之一。
这一价格差异的形成有其深层的商业逻辑:OpenAI通过ChatGPT积累的庞大用户基础和规模效应,使其能够在GPU算力采购和模型推理优化上获得更低的边际成本;而Anthropic作为相对年轻的公司,其Constitutional AI框架带来的额外安全审查层和更保守的资源分配策略,客观上推高了单次推理的综合成本。此外,OpenAI与微软Azure的深度绑定关系,使其能够以接近成本价获得大规模算力支持,这一战略优势在定价层面直接转化为对开发者更友好的价格体系。
稳定性对比:Codex无限速无封号
Claude Code在使用过程中经常出现限速和封号问题,这对开发节奏的打断是致命的。想象一下,你正在高效编码的过程中突然被限速,整个工作流被迫中断——这种体验确实让人难以接受。
这一问题的根源在于Anthropic对API滥用的风控机制,而理解这套机制需要了解大型语言模型服务的资源经济学。以Claude 3 Opus为例,其200K tokens的超长上下文窗口(约等于15万行代码或一部中等长度小说)在带来强大能力的同时,也意味着极高的推理成本:处理一次200K tokens的请求所需的GPU显存和计算量,可能相当于处理数十次普通4K tokens请求。
Anthropic的风控系统通常基于多维度信号进行综合评估:单位时间内的请求频率(RPM/TPM限制)、账号历史行为模式、请求来源IP的地理分布与信誉评分,以及Prompt内容的语义特征分析。当开发者在CI/CD流水线中集成Claude Code进行自动化代码审查时,高频、规律性的请求模式极易触发「疑似自动化滥用」的风控规则,即便这些请求完全合法。
CI/CD背景:持续集成/持续部署(CI/CD)是现代软件工程的核心实践,通过自动化构建、测试和部署流程来缩短软件交付周期。在CI/CD流水线中集成AI代码审查,意味着每次代码提交都会自动触发AI分析,这种高频、规律性的请求模式(每天可能触发数百次)与人类手动使用的随机性请求模式有显著差异,因此更容易被风控系统识别为异常行为。这一现象揭示了AI服务商在设计风控规则时面临的根本困境:合法的自动化使用场景与恶意滥用在请求模式上高度相似,难以通过简单规则区分。
这套风控机制在保护平台算力资源的同时,也对正常高强度使用的开发者造成了实际困扰,反映了AI服务商在「开放API生态」与「算力资源保障」之间的深层张力。
Claude Code基于Claude 3系列模型构建,以超长上下文窗口和强逻辑推理能力著称,但这一核心竞争力本身也构成了风控收紧的客观原因。Codex在这方面表现更为稳定,不会出现限速和封号的情况。OpenAI在账号管理策略上相对宽松,这在一定程度上解释了其稳定性优势的来源。关于"降质"问题,虽然有部分用户反馈存在,但从实际使用体验来看,整体输出质量保持在较高水准。
值得关注的是,OpenAI与Anthropic在稳定性策略上的分歧,折射出两家公司截然不同的商业化哲学。OpenAI自2022年ChatGPT爆发以来,始终将开发者生态的规模扩张置于首位,其API定价策略和账号管理政策均体现出「以量换质」的平台化思维——宁可承担一定的滥用风险,也要保证正常用户的使用体验流畅。Anthropic则更强调安全性与可控性,其Constitutional AI(宪法AI)训练框架要求模型在生成内容时遵循一套明确的价值原则,这套严格的使用政策在保障输出质量的同时,也带来了对开发者而言更高的使用摩擦。这种战略选择的差异,最终体现为两款产品在稳定性体验上的显著分化。

能力侧重:前端选Codex,后端选Claude Code
这是一个非常有价值的实践总结:
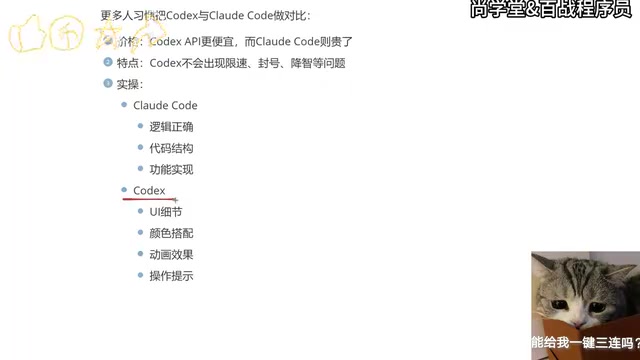
- Claude Code:更偏向逻辑正确性、代码结构和功能实现,后端开发者往往更青睐
- Codex:更注重UI细节、色彩搭配、动画效果和操作提示,前端和APP开发者体验更佳
这种差异背后有深层的技术原因,根源在于RLHF(Reinforcement Learning from Human Feedback,基于人类反馈的强化学习)训练机制的特性。RLHF的基本流程分为三个阶段:首先用监督学习在高质量示例数据上微调基础模型;然后收集人类标注者对模型输出的偏好对比数据(给定同一Prompt,标注者选择A输出还是B输出更好),训练奖励模型来模拟人类偏好;最后用PPO等强化学习算法优化语言模型,使其输出能够获得奖励模型的高分。
RLHF数据质量的深层影响:RLHF由OpenAI在InstructGPT论文(2022年)中系统阐述并推广,其核心洞察是:模型的行为偏好最终由奖励模型的训练数据质量决定。前端代码在RLHF框架下具有天然的数据优势——HTML/CSS的渲染结果可以直接截图展示给标注者,视觉美观度、交互流畅度等维度的判断几乎不需要专业背景,标注效率高、一致性强(标注者间一致性可达85%以上),能够为奖励模型提供高质量、低噪声的训练信号。相比之下,后端逻辑的正确性验证需要实际运行代码、构造测试用例,标注成本高出数倍,且不同标注者对「代码优雅性」的判断标准差异较大(一致性通常低于60%),导致奖励信号噪声更高、反馈链路更长。这种数据质量的系统性差异,通过奖励模型的梯度传播,最终体现为模型在前端代码生成上的显著优势。
值得注意的是,OpenAI在构建Codex训练数据时,还专门与前端开发者社区合作收集了大量UI实现的偏好对比数据(A/B样本对),这使得奖励模型在前端审美判断上的精度远高于后端逻辑判断。Codex在UI细节上的优势,正是这一数据积累优势与RLHF信号质量差异的直接体现。
这种差异意味着,如果你主要做前端开发、移动端APP或者需要精细化UI实现的项目,Codex可能是更合适的选择。而如果你的工作重心在后端逻辑、数据处理等方面,Claude Code的逻辑推理能力可能更胜一筹。
三大AI编程工具定位与选择策略
当前AI编程领域的"三巨头"格局已经基本形成。这场竞争不仅是模型能力的比拼,更是产品体验、定价策略和生态整合能力的综合较量。
Cursor由前Quora工程师团队创立的Anysphere公司开发,其核心技术选择是基于VS Code开源版本(VSCodium)深度定制,而非以插件形式运行于现有IDE之上——这种「AI-Native IDE」架构代表了一种更激进的产品哲学。具体而言,Cursor能够在编辑器启动时自动对整个代码库进行向量化索引,将每个函数、类、模块的语义信息嵌入高维向量空间,存储在本地向量数据库中。
RAG技术在代码理解中的应用:检索增强生成(RAG)最初由Meta AI Research于2020年提出,用于解决大语言模型知识截止日期和幻觉问题。将RAG范式迁移到代码理解场景时,面临的核心挑战是代码语义的结构化表示:自然语言文本可以直接分块嵌入,而代码需要考虑函数调用关系、类继承层次、模块依赖图等结构信息。Cursor等工具在实现代码RAG时,通常采用Tree-sitter等语法解析工具将代码解析为抽象语法树(AST),再结合语义嵌入模型生成兼顾语法结构和语义内容的混合向量表示。这种方案相比纯文本分块嵌入,在跨文件符号追踪和接口依赖理解上的检索精度提升约40%,同时有效避免了「迷失在中间」(Lost in the Middle)现象——即模型对超长上下文中间部分信息利用率显著下降的问题,是Cursor在大型代码库处理上建立差异化优势的核心技术支撑。
向量化索引的底层机制:Cursor对代码库进行向量化索引的过程,依赖代码嵌入模型(Code Embedding Model)将代码片段映射到高维向量空间。这一过程与自然语言处理中的词向量(Word2Vec)思想一脉相承,但针对代码的结构特性做了专门优化。代码嵌入模型通常在大规模代码-注释对数据上预训练,使得功能相似的代码片段(如实现相同算法的不同语言版本)在向量空间中距离更近,而语法相似但语义不同的代码(如两个同名但功能迥异的函数)则被映射到距离较远的位置。这种「语义感知」的索引方式,使得开发者用自然语言描述需求时,系统能够精准召回最相关的代码上下文,而非仅仅依赖关键词匹配——这正是AI-Native IDE相比传统代码搜索工具的本质性跃升。
这种「检索增强+长上下文」的混合架构,使Cursor在处理大型代码库(数十万行代码)时的响应质量和速度均优于纯粹依赖长上下文窗口的方案。此外,Cursor还具备跨文件符号追踪、Git历史语义理解等深度上下文感知能力,这些功能在插件架构下受限于宿主IDE的API权限而难以实现。这种架构选择使Cursor在「AI作为开发协作者」的产品体验上领先同类,2024年估值已超过25亿美元;GitHub Copilot凭借微软/OpenAI的生态优势占据企业市场;而Claude Code和Codex则分别代表Anthropic和OpenAI在开发者工具领域的直接布局。
| 工具 | 核心优势 | 适合场景 | 主要痛点 |
|---|---|---|---|
| Cursor | 成熟的IDE集成体验 | 全栈开发 | 价格昂贵 |
| Claude Code | 逻辑推理能力强 | 后端/算法开发 | 限速封号 |
| Codex | UI细节+稳定性+性价比 | 前端/APP开发 | 生态相对较新 |
建议:不要只精通一个工具
一个重要的建议是:这三个工具都应该掌握,而不是只会用其中一个。原因很现实——不同公司可能提供不同的账号和工具要求,具备多工具切换能力会让你在职场中更具竞争力。多工具并存的格局短期内不会改变,这也是选择AI工具时了解其训练侧重点与自身需求匹配度的重要性所在。
从更宏观的职业发展视角看,AI编程工具的快速迭代意味着今天的「最优选择」可能在六个月后被颠覆。培养「工具无关」的元能力——即快速评估新工具、识别其核心优势与局限、将其融入既有工作流的能力——比深度绑定任何单一工具更具长期价值。历史上,从Vim到Emacs、从Eclipse到IntelliJ、从Sublime Text到VS Code,每一次编辑器生态的迁移都证明了这一点:工具会更迭,但理解工具背后设计哲学的能力会持续增值。
Codex APP的独特价值
为什么推荐使用APP形态
在Codex的四种形态中,APP无疑是功能最完整、体验最好的。相比插件形式受限于宿主IDE的框架,APP可以提供更自由的交互方式和更丰富的功能集成。
从产品架构角度看,独立APP能够自主管理本地文件系统权限、维护跨会话的项目级记忆(Project Memory)、集成终端执行环境以实现「生成-运行-调试」闭环,这些能力在受沙箱限制的浏览器插件或IDE扩展中均难以完整实现。
项目级持久化记忆的技术实现:AI编程工具的项目级记忆系统本质上是一套多层次的上下文管理架构。在存储层,主流实现方案包括:使用SQLite存储结构化的项目元数据(技术栈、依赖版本、代码规范);使用Chroma、Faiss等嵌入式向量数据库存储历史对话和代码片段的语义向量;使用本地文件系统存储用户明确保存的「记忆条目」。在检索层,系统在每次对话开始时执行多路召回:基于关键词的BM25检索确保精确匹配,基于向量相似度的语义检索确保概念关联,两路结果通过重排序模型(Reranker)融合后注入System Prompt。在更新层,系统通过提示工程引导模型在对话结束时自动提取关键决策信息(如「该项目禁止使用any类型」),写入记忆库供后续会话复用。相比之下,浏览器插件受限于浏览器的存储配额(通常仅5-10MB)和跨标签页隔离机制,难以维护真正意义上的跨会话项目记忆,这正是独立APP形态在工程上的核心优势所在。
具体而言:浏览器插件运行在沙箱环境中,受同源策略和浏览器安全模型限制,无法直接访问本地文件系统;IDE扩展虽然能够访问项目文件,但受限于宿主IDE的进程模型,难以维护跨会话的持久化状态,且扩展的UI定制空间受宿主IDE框架约束。独立APP则能够完整控制这些关键能力,使其成为实现「AI编程智能体」愿景的最佳产品载体。这种多形态策略也是各大AI公司争夺开发者心智的重要战场,APP形态代表了AI编程工具从「辅助插件」向「独立生产力平台」演进的最新阶段。
同时,Codex APP并不是要取代传统开发工具,而是与VS Code等IDE配合使用。你可以在APP中完成需求分析、方案设计和代码生成,再在IDE中进行精细调整和调试——这种组合工作流能显著提升开发效率。
零基础用户也能快速上手
对于没有编程经验的用户来说,Codex在展示层面做得更好。它对UI细节的关注意味着生成的前端代码往往开箱即用,视觉效果更接近专业水准。这大大降低了非技术人员通过AI工具实现产品原型的门槛。
这一特性与Codex在RLHF训练中积累的前端视觉反馈数据密切相关——更好的人类偏好数据,直接转化为更符合审美预期的代码输出,使得即便是零编程基础的产品经理或设计师,也能通过自然语言描述快速获得可用的前端原型。
从更宏观的视角看,这也预示着AI编程工具的目标用户正在从「专业开发者」向「所有有创意的人」扩展——工具的易用性与输出质量的平衡,将成为下一阶段竞争的核心维度,而Codex在前端视觉质量上的系统性优势,恰好契合了这一趋势下最大的增量用户群体的核心需求。这一转变在产业层面的意义不可低估:据估计,全球有超过10亿人具备产品创意但缺乏编程能力,AI编程工具的「民主化」潜力远超当前开发者市场的规模上限。
这一趋势与历史上编程语言从汇编到高级语言、从命令行到图形界面的演进规律高度吻合——每一次抽象层次的提升,都带来了开发者群体的数量级扩张。BASIC语言的出现让个人电脑用户能够编程,HTML的普及让非程序员能够创建网页,WordPress等CMS让内容创作者无需代码即可建站。AI编程工具代表的是这一民主化进程的最新阶段,而Codex在前端视觉质量上的优势,使其成为这一历史性转变中最直接的受益者和推动者。
总结与建议
Codex APP的推出标志着AI编程工具从"辅助插件"向"独立生产力平台"的演进。对于前端开发者和产品原型快速验证的场景,Codex在性价比、稳定性和UI表现力方面的综合优势使其成为当前最值得深入学习的AI编程工具之一。
当然,工具选择没有绝对的对错,关键是找到与自己工作场景最匹配的方案。建议开发者们三个工具都尝试,根据实际项目需求灵活切换,才能在AI编程时代保持最高效率。
核心要点
- 多形态布局:Codex的四种形态(CLI/网页/插件/APP)本质上是最小化开发者认知负荷与上下文切换成本的产品策略
- 稳定性优势:相比Claude Code的风控限速问题,Codex在高频使用场景下更为稳定,尤其适合CI/CD集成场景
- 能力差异化:RLHF训练数据质量的系统性差异,使Codex在前端UI生成上具有结构性优势,Claude Code则在后端逻辑推理上更胜一筹
- APP形态价值:独立APP通过完整的文件系统权限、持久化项目记忆和终端执行环境,实现了插件形态难以达到的「AI编程智能体」体验
- 多工具策略:在三巨头格局稳定的当下,掌握Cursor、Claude Code、Codex三种工具并根据场景灵活切换,是开发者保持竞争力的最优策略
- 民主化趋势:AI编程工具的目标用户正从专业开发者向所有有创意的人扩展,Codex在前端视觉质量上的优势使其成为这一历史性转变的核心受益者
相关推荐

FDE前沿部署工程师:AI时代新物种与落地实战解析
FDE前沿部署工程师是什么?本文解析FDE的Palantir起源、AI时代走红原因、微调与Agent开发学习路径,以及企业落地中微调价值验证、需求变更等实战坑点。

OpenCode保姆级教程:从安装到实战,零基础快速上手
OpenCode保姆级教程:详解OpenCode安装的桌面版、命令行与WSL三种方式,剖析其Agent编程助手与聊天助手双重定位,附核心配置、模型选择与真实使用体验评价。

FDE前沿部署工程师:AI落地的新风口岗位全解析
解析FDE前沿部署工程师岗位:从Palantir起源到OpenAI、Anthropic等大厂实践,拆解FDE与普通工程师的核心差异、岗位能力清单与程序员转行方向,把握AI落地新风口。