Codex+Skills+Playwright:从需求文档到自动化测试用例的AI落地实践
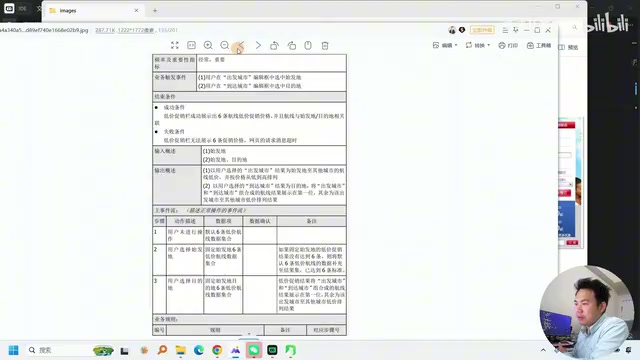
用Skill编排+多模态模型,将需求文档自动转化为可执行测试用例的五步AI工作流
本文介绍了一套基于 Cloud Code(Codex)+ Skills + Playwright 的 AI 测试用例生成方案。其核心思路是:先将各种格式的需求文档统一转为 Markdown 并分离图片,再通过五个专门开发的 Skill 模块依次完成需求拆分、多模态测试点提取、质量评审和用例导出(Excel/XMind),每步之间设有质量闭环。关键创新在于用系统提示约束 Cloud Code 的执行顺序,将默认写代码的智能体改造为专注需求分析的测试引擎;多模态模型识图则显著提升了对流程图、原型图等视觉信息的覆盖度。生成的功能用例还可进一步由 AI 驱动 Playwright 自动执行,全程录屏并生成报告。落地该方案需针对性开发 Skill 并深入理解 Codex 机制,有一定工程成本,但其"分步 Skill + 评审闭环"的设计思路对测试团队具有较强借鉴价值。
在软件测试领域,从需求文档到测试用例的转化一直是耗时且依赖经验的环节。B站UP主分享的一套基于 Codex(Cloud Code)+ Skills + Playwright 的方案,展示了如何让 AI 读懂带图的需求文档、自动拆分功能点、生成测试点并导出可用的测试用例,甚至进一步驱动自动化执行。本文梳理这套工作流的核心思路与关键技术点。
为什么直接扔文档给AI效果差
很多人尝试过把需求文档直接丢给大模型生成测试用例,结果往往质量堪忧。原因在于:需求文档格式各异(PDF、Word、图片),且包含大量业务流程图、原型图等视觉信息。如果模型只能读取纯文本内容,图片里承载的关键需求就被丢弃了,生成出来的用例自然覆盖不全。
UP主指出,这套方案的第一步就是文档规范化处理——无论输入是 PDF、Word 还是图片,都先统一转换成 Markdown 格式,并将文档中的图片单独分离提取出来。这样做的目的是给大模型提供一个统一、可理解的输入标准,为后续处理打下基础。
多模态模型是指能同时处理文本、图像(乃至音视频)等多种输入形式的大语言模型,如 GPT-4o、Claude 3 系列等。与纯文本模型不同,多模态模型可以直接"看懂"流程图、原型截图中的布局、标注和交互逻辑,而这些信息往往无法通过 OCR 或 Markdown 转换完整还原。在需求文档场景下,一张用户注册流程图可能包含十几个判断分支,纯文本提取后这些分支关系几乎全部丢失;而将原图直接送入多模态模型,则可以识别出每条分支对应的条件和跳转目标,从而生成覆盖更全面的测试点。这也是本方案在测试点提取阶段专门调用多模态模型而非复用文本解析步骤的核心原因。
五步工作流:从需求到用例
整套流程被拆解为清晰的五个阶段,每个阶段都对应专门开发的 Skill(技能)模块:
1. 需求规范化处理
使用文档处理 Skill,将各种格式的需求文档统一转成 Markdown,同时把业务流程图、原型图等图片分离出来,方便后续多模态识别调用。
2. 需求裁分(拆分)
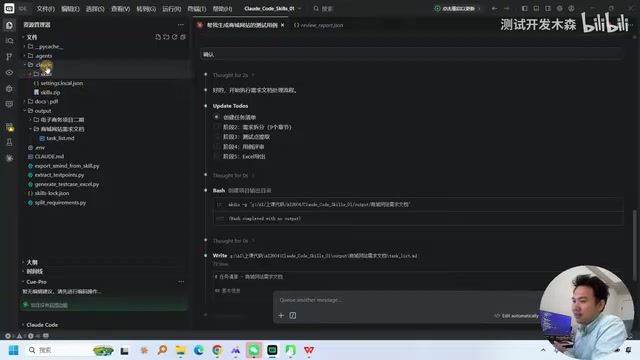
通过专门设计的需求差分 Skill,按模块把文档中的功能点、需求逐一提取出来,并关联对应的图片。演示中一份商城网站需求文档被识别出十个章节,成功解析八个、约一百多个需求点。
3. 测试点提取
这一步是质量的关键。测试点提取 Skill 会读取前面拆分好的需求文本及关联图片,调用多模态模型识别图片内容,结合文字需求综合生成测试点。相比只读文本的方案,多模态理解显著提升了用例覆盖度。
4. 测试点评审
生成的测试点会先经过一个评审 Skill 做质量 review,检查是否覆盖了所有验收标准,并生成一份评审报告。只有评审通过的测试点才会进入下一环节,形成质量闭环。
5. 用例导出
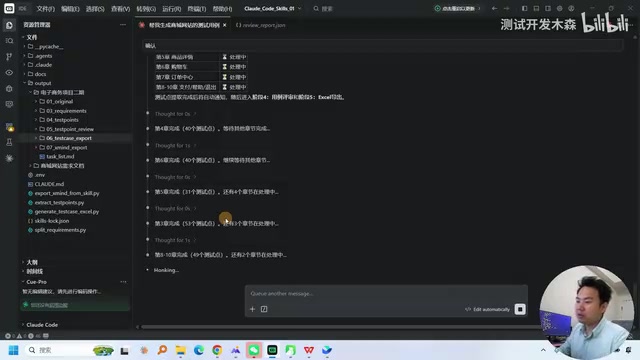
评审通过后,用例可同步导出为 Excel 表格和 XMind 思维导图两种格式。演示中一次生成了三百多个测试点,每条包含前置条件、测试数据、操作步骤、预计结果等完整字段。UP主强调,只需调整 Skill 就能控制输出格式,扩展其他格式也不难。
Skills 与系统提示:改造Codex的行为
这套方案能跑通的核心,不只是 Skill 本身,还在于对 Codex(Cloud Code)默认行为的改造。UP主解释,Cloud Code 默认是一个代码编写的智能体——你给它任务,它倾向于去写代码完成。而测试用例生成需要的是一个专注于分析需求、产出用例的智能体。
因此除了开发一系列 Skill(需求差分、测试点提取、评审、导出等),还要在系统提示中约束 Cloud Code 的整体工作流程,让它按照既定的五步流程执行任务,而不是自由发挥。这就要求使用者对 Codex 的运行机制和 Skill 设计(包括 Mini Skill、带脚本的 Skill 等不同结构)有较深理解。
值得一提的是,UP主提到这些 Skill 都是自行开发的,并非公共通用模板,针对性开发是保证效果的前提。
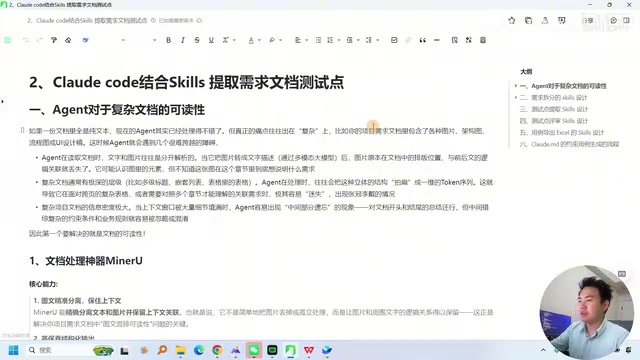
Skills(技能模块) 是 Claude/Codex 生态中用于扩展智能体能力的结构化组件,本质上是一段包含特定指令、工具调用逻辑或脚本的配置单元。Mini Skill 通常只包含提示词模板,适合轻量的文本转换任务;带脚本的 Skill 则可以调用外部命令或 API,例如调用 Python 脚本完成 PDF 解析或 Excel 写入。系统提示(System Prompt) 则是在对话开始前注入的全局指令,用于设定模型的角色、行为边界和任务流程。在本方案中,系统提示承担的是"总调度"角色——它告诉 Cloud Code 整体应按五步顺序执行,防止模型跳步或自行决定用代码实现本该由特定 Skill 处理的环节。Skills 负责"做什么",系统提示负责"按什么顺序做",两者结合才能形成可复现的工作流。
从用例生成到自动化执行
生成用例只是第一阶段。UP主还展示了后续的延伸能力:
- 功能用例自动跑自动化:借助 Playwright 等工具,通过 AI 驱动自动执行功能测试,无需人工编写 URL 自动化脚本。执行过程全程录屏、每步截图,最终生成详细的测试报告。
- 接口自动化:通过接口文档编排用例、生成全流程接口自动化用例,并由 AI 驱动执行。
- 多工具接入:其测试环境同时接入了自动化执行工具,可用于跑功能用例并输出测试报告。
这意味着整条链路——从需求文档解析、用例生成、评审,到自动化执行与报告——理论上都可以被 AI 串联驱动。
Playwright 是微软开源的端到端浏览器自动化框架,支持 Chromium、Firefox 和 WebKit,提供 Python、TypeScript 等多语言 API。与传统的 Selenium 相比,Playwright 内置了自动等待机制、网络请求拦截和更稳定的选择器策略,在 AI 驱动的测试场景中尤为适合——因为 AI 生成的操作步骤描述往往是自然语言,需要框架具备较强的容错性和状态感知能力。在本方案的延伸阶段,AI 将测试用例中的操作步骤翻译为 Playwright 脚本,并实时截图记录每一步执行状态,最终汇总为可追溯的测试报告,整个过程无需人工编写选择器或维护脚本结构。
实践价值与门槛
这套方案代表了 AI 在测试工程中的一个务实方向:不是简单地"问答",而是通过 Skill 编排 + 系统提示约束,把大模型改造成一个专注特定任务的工作流引擎。多模态识图、需求拆分、质量评审的分步设计,也体现出对生成质量的重视。
不过需要清醒认识到几点:整个流程跑完约需十来分钟,并非即时;Skill 需要针对性开发,且涉及对 Codex 机制的深入理解;自动化执行部分还依赖额外的工具配置与调优。换句话说,落地这套方案有一定的学习和工程成本,不是拿来即用。
对于测试团队而言,这套思路的借鉴意义在于:与其期待一个万能提示词,不如把复杂任务拆解为可控的多步 Skill,并在每一步引入评审机制,才能得到可用于生产的高质量产出。
相关推荐
Gemma 4 并行智能体实战:本地多Agent协同生成SVG
Gemma 4 并行智能体本地实战演示:编排器一次生成10个子智能体,借助模型批处理在单机达到超170 tokens/s推理速度,并行生成SVG画廊,展示本地多Agent协同与私有部署的应用潜力。
Chrome DevTools for Agents:为编码智能体构建闭环反馈
Google I/O Connect 演讲深度解析 Chrome DevTools for Agents:如何为编码智能体构建检查—调试—修复的闭环反馈,涵盖底层架构、典型用例、PAIR 公司 10 倍效率案例及 AutoConnect 配置与安全实践。
AI英语背单词智能体:FSRS算法+多模态助记如何重构记忆效率
北京木奇科技推出AI英语背单词智能体,采用改进版FSRS记忆算法、多模态助记引擎、语用评估与RAG检索增强架构,实现自适应复习与场景化背词,解析其技术架构与产品设计。