Codex vs Claude Code实测对比:$20档位真实差距有多大

基于一个月双线实测,全面对比OpenAI Codex与Claude Code的定价、形态、核心能力差异。
作者通过一个月每天在Codex和Claude Code之间切换的真实项目实测,从定价、产品形态、上下文窗口、代码质量、生态系统和杀手锏功能四个维度进行对比。结论是:入门性价比Codex更优,Claude Code上下文窗口更大适合大项目,代码修复能力两者接近但各有侧重,生态系统一个精而少一个多而杂,Codex的Goal Mode自动驾驶能力是其独门武器。
网上关于OpenAI Codex和Anthropic Claude Code的对比文章不少,但大多数作者只深度使用了其中一个,难免各说各话。本文基于一个月的双线并行实测——每天在两个工具之间切换做真实项目,Codex额度用完切Claude Code,Claude Code限速了再切回去——把踩过的坑和真实结论一次性讲清楚。
定价看似对称,细节差距巨大
两边的定价结构几乎一模一样:入门档20美元/月,进阶档100美元,顶配档200美元。但魔鬼藏在细节里。
Codex的20美元是全家桶价。 ChatGPT Plus的20美元不只包含Codex,你还能用GPT 5.5聊天、用DALL·E画图、用Sora做视频。而Claude Code的20美元是单点价,Claude Pro的20美元就是Claude本身,没有额外的画图、视频功能。同样20美元,一个给了你一桌菜,一个只给了一道硬菜。
更关键的差距在额度。Claude Code 20美元档的额度非常紧张,大量真实用户反馈,稍微复杂一点的任务,十来个回合就用完了一个时间窗口的额度。你正在解一个问题解到一半,突然弹出"额度用完,请等5小时"——正在心流中被打断,体验极其糟糕。Codex同价位的额度则宽裕得多,同样20美元能做的事情明显更多。
结论:入门试水,Codex性价比碾压;重度使用,两边都得上100美元档才够用。
产品形态对比:谁更好上手?
Codex提供四种使用方式:桌面端应用(界面友好,有文件管理器和任务侧边栏)、VS Code插件、命令行工具,以及ChatGPT网页里的云端版本。Claude Code则有三种:命令行、桌面端、编辑器插件。
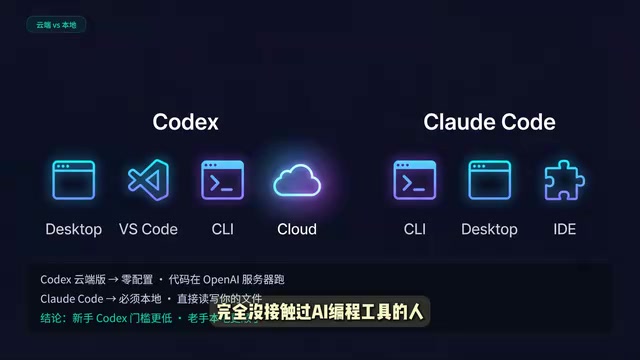
表面差别不大,但有一个关键区别:Codex有云端版,Claude Code没有。 这意味着用Codex的云端版,代码在OpenAI服务器上跑,你电脑上什么都不用装,适合想试试但不想折腾环境的人。Claude Code必须在本地跑,好处是能直接读写你电脑上的文件,和开发环境无缝打通;坏处是你得先把环境配好,对非技术人员有门槛。
完全没接触过AI编程工具的人,Codex上手门槛更低。老手的话,本地跑反而更顺手,这个门槛不是问题。
核心能力对决:四个维度逐个比
上下文窗口:工作记忆的较量
Token是大语言模型处理文本的基本单位,大致可以理解为"词片段"——英文中一个单词约等于1-1.5个Token,中文一个汉字约等于1-2个Token。上下文窗口(Context Window)则是模型在单次对话中能"记住"和处理的最大Token数量,相当于模型的工作记忆容量。超出这个窗口的内容,模型就会"遗忘"。对于代码任务而言,一个中型项目的全部源代码往往在数万到数十万Token之间,上下文窗口越大,AI就能同时"看到"更多文件,对项目整体的理解也就越连贯。
Codex基于GPT 5.5,上下文约40万Token(大致相当于30万字中文内容);Claude Code基于Opus,约100万Token——后者是前者的2.5倍,相当于一部中等长度的长篇小说。
听起来差距很大,但要分场景看。日常任务(写函数、改样式、修小Bug),40万Token完全够用,两边体感没区别。但当你需要AI理解一整个大型项目时,差距就出来了:Claude Code能一次性把更多文件读进去,对项目整体架构的理解更完整、更连贯;Codex遇到大项目可能需要分几次读,中间的关联就可能断掉。
代码质量:各有所长
业界两个常被引用的标准化测试值得深入了解。SWE-Bench(Software Engineering Benchmark)是由普林斯顿大学研究团队于2023年提出的评测集,从GitHub上收集了数千个真实的Issue和对应的修复补丁,要求模型在不知道答案的情况下,仅凭Issue描述和代码库自主生成能通过测试的修复方案。这个测试被业界广泛认可,因为它考察的是真实世界的工程能力,而非刷题式的算法题。Terminal-Bench则专注于评估AI在终端环境中执行自动化操作的能力,包括文件管理、脚本执行、系统配置等任务,更贴近DevOps和运维场景。两个基准测试从不同维度衡量AI编程助手的实际价值:
- SWE-Bench(修复真实代码库问题的能力):Claude Code 59分 vs Codex 56.8分,Claude Code略高但差距不大
- Terminal-Bench(终端自动化操作能力):Codex 77.3分 vs Claude Code 65.4分,Codex明显更强
一句话总结:修复复杂问题Claude Code略强,跑自动化脚本Codex明显强。不是谁碾压谁,是各有所长。
生态系统:苹果商店 vs 安卓市场
Codex有90多个官方插件,Atlassian、GitLab、微软Office等大厂都在列,官方审核过质量有保障,但数量有限。Claude Code有3000多个MCP服务器——MCP(Model Context Protocol,模型上下文协议)是Anthropic于2024年底发布的开放标准协议,设计思路类似于USB接口的统一化:只要遵循这个协议,任何开发者都可以编写连接器来暴露自己的工具或数据,而任何支持MCP的AI客户端都能直接调用,无需为每个外部服务单独开发集成接口。目前MCP已获得微软、谷歌等主要科技公司的支持,有望成为AI工具互联的行业标准,这也是Claude Code生态能在短时间内积累3000多个服务器的根本原因。数量碾压但质量参差不齐。
Codex的生态像苹果应用商店——数量不多但个个能用;Claude Code的生态像安卓开放市场——选择多但得自己挑。
杀手锏功能:自动驾驶 vs 手动挡赛车
这是我认为最关键的维度,每个产品都有一个对方目前做不到的独门武器。

Codex的杀手锏:Goal Mode(目标模式)。 Goal Mode本质上是一种AI Agent(智能体)架构的具体实现。传统的AI编程助手是"一问一答"的响应式模式,而AI Agent则是能够自主规划、执行、观察反馈并循环迭代的主动式系统——先思考下一步该做什么,执行后观察结果,再根据结果调整计划,如此循环。Goal Mode将这一循环延伸到了极致:你给它设一个目标,比如"把这个项目从旧框架迁移到新框架,确保所有测试通过",然后你就可以离开了——出去吃饭、睡一觉都行。它会自己拆分任务、自己执行、自己检查结果、遇到错误自己修正,然后继续推进。不是跑几分钟,是可以自己跑上几个小时甚至几天。有人用Goal Mode让Codex自动复现一篇量化金融论文,它自己跑了好几天,能复现的部分全做完了,做不了的也明确标注了原因。这种"设好目标然后走开"的能力,代表了AI编程工具从"副驾驶"(Copilot)向"自动驾驶
相关推荐
 产品体验
程序员桌面布局指南:打造让你「回到家」的高效工作空间
探索程序员如何打造高效舒适的桌面布局。从多显示器配置到人体工学设计,解析技术工作者的桌面哲学,帮助你构建提升专注力与生产力的个人工作空间。
 产品体验
Qoder vs Cursor实测对比:同样20美金谁更强?
实测对比Qoder和Cursor两款AI IDE,从Agent自主修复能力、人工沟通次数、架构决策等维度评测。Qoder仅需2次沟通完成任务,Cursor需8次。详细分析两者差异,帮你选择最适合的AI编程工具。
 产品体验
Cursor云Agent演示:打通软件开发全链路瓶颈
深度解析Cursor云Agent最新Demo,展示如何通过云端虚拟机、自动测试产物和全链路控制平面,系统性消除软件开发生命周期中的人类瓶颈,让Agent自主运行、人按需介入。