Codex搭建AI知识库全攻略:从安装到自动化实战

一套以Codex为核心、串联Obsidian等四款工具的AI个人知识库搭建方案
本文介绍了B站UP主海朗老师推出的14节Codex知识库课程,旨在帮助零基础用户从工具安装开始,系统性地搭建个人AI知识库。课程分三个阶段:第一阶段部署Codex命令行工具及客户端;第二阶段打通Obsidian、Notion、飞书与腾讯IMA四款工具的数据链路,实现跨平台信息流转;第三阶段演示六类自动化产出场景,包括信息抓取、定时归类、风格化播客稿生成及小红书图文批量产出。课程的核心价值在于提供了一套可落地的系统框架,而非速成承诺,作者同时指出多工具联调的学习成本与持续调试的必要性。
为什么要用Codex搭建个人知识库
很多人都想用AI提升效率,却总卡在最开始的那几步:工具装不上、环境配不好、数据散落在各个平台不成系统。结果折腾半天,AI不但没帮上忙,反而带来一堆焦虑——「大家都在用AI,我不用好像可惜,但用上了好像也没产出什么」。
这正是B站UP主海朗老师推出这套Codex知识库课程想要解决的核心痛点。他花了三个月时间,站在完全零基础的视角,刷遍全网教程后发现一个共性问题:现有内容要么太硬核,要么只讲单个软件,几乎没人教怎么把工具串联起来做实战。于是他把干货整合成14节系统课,目标非常直接——从零开始装好工具、打通数据、跑通产出。
Codex是什么,它在系统里扮演什么角色
在这套方案里,Codex被定位为整个知识库系统的「大脑核心」。它是一款基于命令行与客户端交互的AI工具,承担信息提取、批量处理、内容生成等自动化任务。
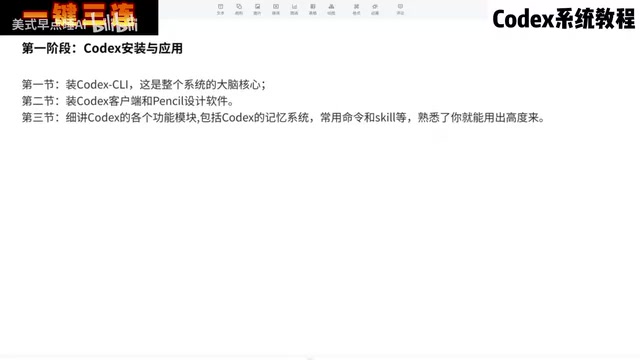
课程的第一阶段就是围绕Codex的部署展开,共三节课:
- 搭建环境:安装Codex的命令行工具(CLI),把运行底座搭好
- 安装客户端:客户端是用户与Codex交互的界面,配合Pencil等辅助设计工具一起使用
- 功能精讲:深入讲解Codex的记忆系统、常用命令和Skill等模块
其中的记忆系统尤其关键,它决定了AI能否在长期协作中「记住」你的偏好和上下文,是实现个性化产出的基础。
Codex是OpenAI推出的一款面向代码与任务自动化的AI模型,其命令行界面(CLI)允许用户通过终端直接下达指令,驱动AI完成文件读写、信息检索、脚本执行等操作,而无需在浏览器中手动交互。与ChatGPT这类对话式工具不同,Codex CLI更擅长在本地文件系统中「动手操作」——它可以直接访问你的文件夹、调用外部API、批量处理文档,这也是它能成为知识库「大脑核心」的根本原因。CLI(Command Line Interface,命令行界面)对于没有编程背景的用户而言可能略显陌生,但其核心逻辑并不复杂:用户输入自然语言指令,Codex将其转化为具体的操作步骤并执行。理解这一点,有助于判断课程中各类「自动化任务」的实现路径与边界。
打通Obsidian、Notion与飞书的数据链路
课程的第二阶段聚焦知识库与数据流,这也是整套方案最有价值的部分——让信息真正动起来。单一工具的能力有限,只有把多个平台串联,数据才能流转,价值才会放大。
核心工具分工
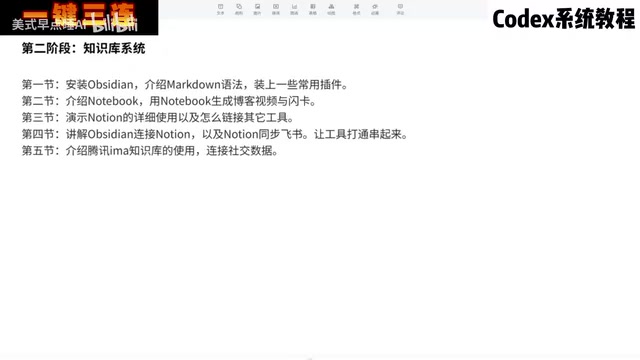
这一阶段共五节课,涉及四款主流工具,各自定位清晰:
- Obsidian:知识管理中枢,配合Markdown语法和常用插件,负责信息的获取与处理
- Notion:用于生成博客、视频脚本和学习闪卡等结构化内容
- 飞书:承担跨平台文档协作,与Obsidian、Notion打通后形成数据通道
- 腾讯IMA知识库:作为数据仓库,优势在于能接入微信等腾讯生态工具,为海量日常信息提供统一入口
Obsidian是一款基于本地Markdown文件的知识管理软件,所有笔记以纯文本形式存储在用户设备上,不依赖云端服务器,数据完全自主可控。它的核心优势在于双向链接(Backlinks)与图谱视图,能将碎片化的笔记织成一张可视化的知识网络。Markdown是一种轻量级标记语言,用#表示标题、**表示加粗等简单符号即可完成排版,几乎所有主流笔记与内容平台均支持,因此成为跨工具数据流转的「通用格式」。在这套方案里,Obsidian承担本地知识沉淀的角色,正是因为它的Markdown原生支持使得Codex可以直接读写其文件,无需额外的格式转换层。
跨平台联动的意义
这套设计的巧妙之处在于分工协作:Obsidian做本地知识沉淀,Notion做内容产出,飞书做协同流转,IMA做信息入口。当这几个工具的数据链路被打通后,用户每天产生的碎片信息就能自动汇入系统,不再散落各处。
自动化产出:从信息提取到内容生成
第三阶段是整套系统的落地应用,也是最能体现「省力」价值的环节。当工具和数据通道都就位后,Codex就可以开始接管重复性工作。
六个实战场景
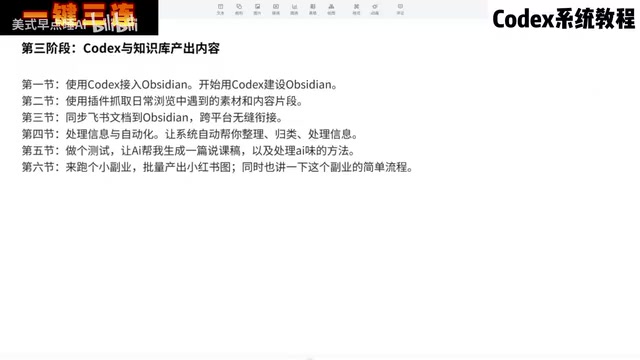
课程演示了Codex与Obsidian协同的六类自动化任务:
- 接入Obsidian:用Codex直接操控知识库的建设与维护
- 信息抓取:通过插件快速捕获日常流转中遇到的素材片段
- 跨平台同步:把飞书文档复制到Obsidian,实现无缝衔接
- 自动化处理:让系统自动整理、归类信息,还能设置定时流程每天自动跑
- 风格化生成:让AI生成一篇符合个人风格的播客稿,检测可用性,并处理「AI味」过重的问题
- 副业变现:批量产出小红书图文,演示图文带货的简单流程
其中「生成个人风格播客稿」这一环节值得关注。它不仅测试AI产出的内容质量,还专门讨论了如何弱化AI味道——这恰恰是当前AI内容创作最被诟病的痛点。
「AI味」是指AI生成内容中常见的一类文风特征:句式高度对称、措辞偏向书面与正式、惯用「总的来说」「值得注意的是」等连接词、缺乏个人口语化表达与情感起伏。这类文本在专业性上无可挑剔,却往往让读者一眼识别出机器痕迹,削弱内容的真实感与传播力。弱化AI味的常见做法包括:在提示词中提供大量个人历史内容作为风格样本、要求模型使用第一人称口语化叙述、生成后人工润色关键段落,以及刻意保留少量语法上的「不完美」。这一问题在播客稿、社交媒体文案等需要强个人属性的内容场景中尤为突出,也是当前AI内容创作领域最活跃的研究与实践方向之一。
这套方法论的价值与局限
海朗老师在课程结尾表达了一个相对务实的态度:他并不承诺「用上三天就能跑通闭环,立刻震惊朋友圈」。相反,他强调的是行动、思考、迭代的渐进过程——「你朝着好的方向实际地走,就会越来越好」。
这种定位值得肯定。相比许多鼓吹「一键暴富」的AI课程,这套14节课的核心价值在于提供了一个可落地的系统框架:从命令行安装起步,到多平台数据打通,再到自动化批量产出,环环相扣。
不过也要客观看待:这类工作流涉及Obsidian、Notion、飞书、IMA等多款工具的配置与联调,对零基础用户而言仍有一定学习成本;跨平台同步的稳定性、Codex自动化流程的可靠性,也需要在实际使用中反复调试。真正的「全自动知识库」更像是一个持续优化的目标,而非开箱即用的现成产品。
对于希望系统化使用AI工具、搭建个人内容生产线的用户来说,这套方案提供了清晰的路线图。关键还是落到那句老话——先行动起来,在使用中迭代。
相关推荐

前端转AI Agent开发:一线架构师解析职业路径与红利
一线AI架构师解析前端转AI Agent开发的行业变化与落地路径:纯前端岗位为何消失、Agent+全栈为何成为招聘主流,以及Agent开发工程师、FDE、远程接单三条转型路线和对应学习策略。

AI Agent开发课程怎么选?五条避坑指南
机械转行开发者踩坑两年总结的AI Agent开发课程筛选清单:完整交付链路、可写进简历的项目、真实开发视角、更新频率、陪跑反馈五个维度,附具体判断方法和避坑要点。

扣子(Coze)智能体搭建入门:零代码开发AI Agent实战指南
扣子(Coze)是字节跳动推出的一站式AI应用开发平台,支持零代码拖拽搭建AI智能体。本文基于B站教程梳理扣子的核心概念、三大优势、国内版与国际版差异,以及智能体与应用的区别,帮助初学者快速入门AI Agent开发。