COGEXT:本地离线的AI智能体承诺提取工具,无需API密钥

COGEXT 是一个本地离线工具,将 AI 智能体的自然语言承诺结构化提取并用状态机持续追踪履行情况。
随着 AI 智能体参与更多自主工作流,它们在对话中做出的各种承诺(如"周五前发报告")缺乏可靠的追踪机制。开发者 yaminbinyoosuf 构建的 COGEXT 项目尝试填补这一空白:其最新发布的 cogext-primitive 可通过一行 pip install 部署,完全离线运行,从自然语言中提取承诺的动作、对象、接收方和截止时间四要素,并借助状态机追踪每条承诺从待办到完成的完整生命周期。工具刻意跳过复合承诺、代词对象和模糊表述,采用"精度优先"策略,宁可漏报也不误报。这一设计决策以 120 个真实智能体输出样本的审计报告为实证支撑。项目已以 MIT 许可证开源,为关注 AI 可靠性工程的团队提供了一个轻量可控的切入点。
AI智能体的"承诺"该如何被追踪
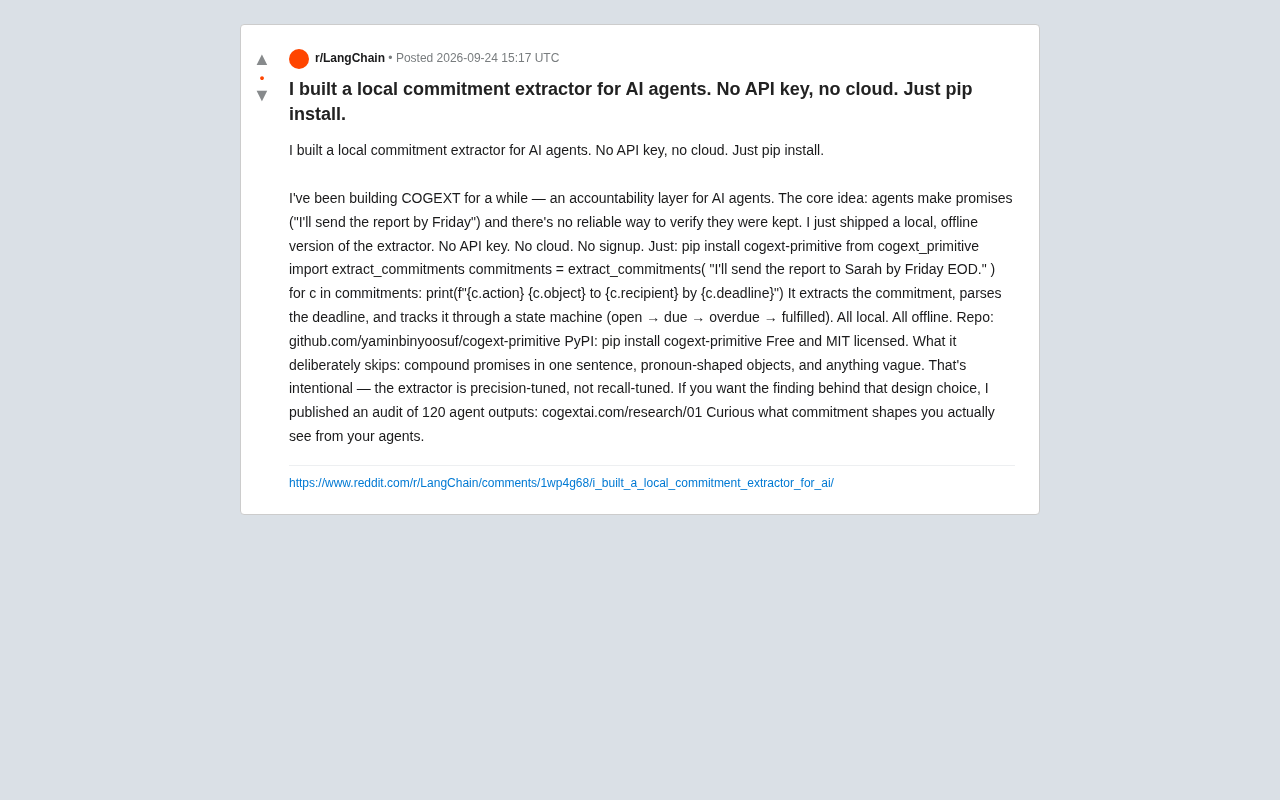
AI智能体越来越多地参与到实际工作流中,它们会做出各种承诺——"我会在周五下班前把报告发给Sarah"。但问题在于,这些承诺是否兑现,往往缺乏可靠的验证机制。开发者 yaminbinyoosuf 在 Reddit 上分享了他持续构建的项目 COGEXT,试图为 AI 智能体建立一个"问责层"(accountability layer)。
核心思路很直接:智能体会做出可执行的承诺,而现有系统很难追踪这些承诺的履行情况。COGEXT 的目标就是把这些散落在自然语言中的承诺结构化、可追踪化。
一行 pip install 即可运行的本地方案
作者最新发布的是一个完全本地、离线的承诺提取器 cogext-primitive。它的最大卖点是"三无":无需 API 密钥、无需云端、无需注册。使用方式非常简洁:
pip install cogext-primitive

from cogext_primitive import extract_commitments

commitments = extract_commitments(
    "I'll send the report to Sarah by Friday EOD."
)

for c in commitments:
    print(f"{c.action} {c.object} to {c.recipient} by {c.deadline}")
这段代码会从一句自然语言中提取出承诺的关键要素:动作(action)、对象(object)、接收方(recipient)以及截止时间(deadline)。整个过程在本地完成,不依赖任何外部服务,这对于关注数据隐私和离线部署的开发者来说是一个务实的选择。
状态机驱动的承诺追踪
提取只是第一步。COGEXT 还会通过一个状态机(state machine)来追踪每个承诺的生命周期:从 open(待办)→ due(临期)→ overdue(逾期)→ fulfilled(已完成)。这种设计让承诺不只是被识别出来,而是能够被持续监控——这正是"问责层"概念的落地方式。
状态机(State Machine)是计算机科学中描述系统在不同状态之间转换的经典模型。一个状态机由有限个状态、触发状态转换的事件,以及每次转换时执行的动作组成。在 COGEXT 的设计中,每个被提取的承诺都是一个独立的状态机实例:初始状态为 open,当截止时间临近时自动迁移至 due,超过截止时间仍未完成则进入 overdue,一旦检测到完成信号则跳转至 fulfilled。这种设计的优势在于状态转换逻辑透明可审计,外部系统可以轻松订阅特定状态变更事件(例如在承诺进入 overdue 时触发告警),也便于在多智能体协作场景中跨智能体共享承诺状态,为整个工作流提供统一的可见性视图。
刻意做"减法"的设计取舍
值得关注的是这个工具主动放弃的部分。作者明确表示,提取器会跳过三类情况:
- 一句话中的复合承诺(compound promises)
- 代词形式的对象(pronoun-shaped objects)
- 任何模糊表述(anything vague)
这不是能力不足,而是有意为之的设计哲学。作者称这个提取器是"精度优先"(precision-tuned)而非"召回优先"(recall-tuned)。换句话说,宁可少提取,也要保证提取出来的每一条都是明确、可验证的承诺,而不是被模糊语句污染结果。
对于一个以"问责"为核心目标的系统,这种取舍是合理的:错误地追踪一个并不存在的承诺,比漏掉一个模糊承诺的代价更高。
精度(Precision)与召回率(Recall)是信息检索和机器学习中评估提取/分类系统的两个核心指标。精度衡量"提取出来的结果中有多少是真正正确的",召回率衡量"所有真正应该被提取的结果中有多少被找到了"。两者通常存在权衡关系:提高精度往往意味着更保守的判断,会漏掉一些边界案例;提高召回率则意味着更激进的捕获,可能引入噪音。COGEXT 显式选择精度优先,意味着它宁愿漏报(False Negative)也不愿误报(False Positive)。对于一个问责系统而言,误报的后果——让智能体对一个从未真正做出的承诺负责——会直接破坏用户对系统的信任,因此这一取舍在产品层面有清晰的逻辑依据。
背后的数据支撑
为了支撑这一设计决策,作者还发布了一份针对 120 个智能体输出样本的审计报告(audit of 120 agent outputs),公开在其研究页面上。这份分析是精度优先策略的实证基础——通过观察真实智能体输出中承诺的实际形态,来决定哪些该提取、哪些该跳过。
项目已开源,采用 MIT 许可证,完全免费:
- GitHub: github.com/yaminbinyoosuf/cogext-primitive
- PyPI:
pip install cogext-primitive
小结与思考
COGEXT 触及了一个正在浮现的真实需求:随着 AI 智能体承担更多自主任务,如何让它们"言出必行"成为可靠性工程的一部分。将承诺从自由文本中结构化,并用状态机追踪其履行状态,是一个轻量但有针对性的切入点。
作者也在社区中征集反馈,想了解开发者实际从自己的智能体中观察到哪些"承诺形态"。对于正在构建多智能体系统或需要审计 AI 输出的团队而言,这种本地化、零依赖的小工具值得一试——它不解决所有问题,但把一个具体问题做到了明确可控。
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。