COLM语言模型顶会解析:从定位到学术生态全面观察

COLM:语言模型时代的专属学术舞台
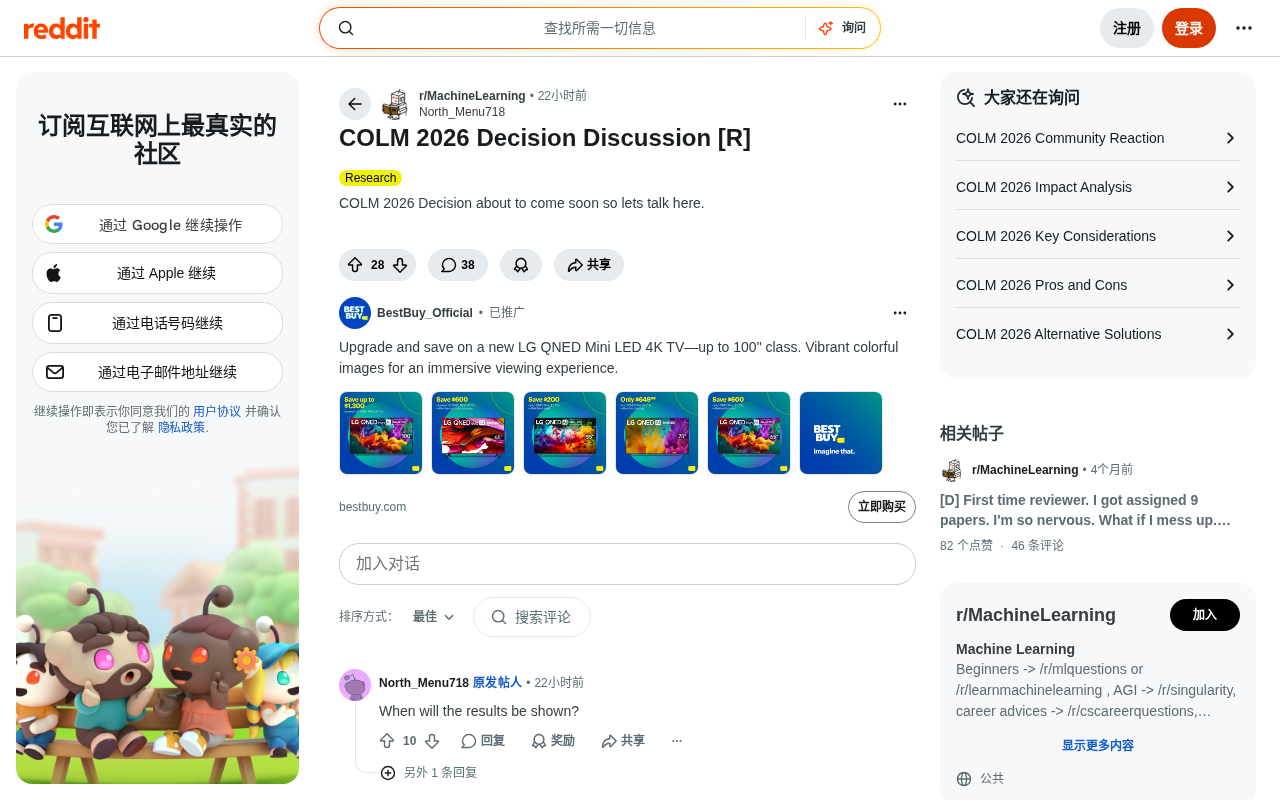
随着 COLM 2026(Conference on Language Modeling)录用结果即将公布,Reddit 的 r/MachineLearning 社区已掀起新一轮热烈讨论。一位用户发起的「COLM 2026 Decision Discussion」帖子,再次将这个成立时间不长却迅速崛起的大语言模型顶会推到了聚光灯下。
COLM 诞生于 2024 年,是目前唯一专门聚焦「语言建模」(Language Modeling)主题的顶级学术会议。与 NeurIPS、ICML、ICLR 等综合性机器学习顶会不同——这些会议历史可追溯至上世纪八九十年代,长期主导 AI 学术发表生态——COLM 从创立之初就将自身定位为大语言模型(LLM)时代的垂直会议,致力于将散落在各大会议中的语言模型相关研究汇聚到同一平台,促成更深度的学术交流。
一个新会议为何能迅速崛起
在传统机器学习会议体系中,语言模型相关研究长期被分散在 NLP 会议(如 ACL、EMNLP)和通用 ML 会议之间。值得注意的是,ACL、EMNLP、NAACL 等传统 NLP 会议的研究范式更多根植于语言学与符号处理传统,与以规模化预训练为核心的现代语言模型研究存在明显的范式鸿沟。这使得语言模型领域始终缺乏一个以「语言建模」为核心议题的专属场所。COLM 的出现精准填补了这一制度性空白。
垂直定位:切中研究者真实需求
随着 GPT、Claude、Llama 等大模型相继爆发,语言模型研究的广度和深度都在急速扩展。这一切的技术基础,是 2017 年 Vaswani 等人提出的 Transformer 架构——其核心创新是以自注意力机制(Self-Attention)替代传统循环神经网络,实现了序列建模的高度并行化。基于这一架构发展出的大规模预训练范式(在海量无标注文本上训练通用语言表示,再通过微调或提示工程迁移至下游任务),彻底改写了整个 AI 研究的方法论基础。
由此衍生出的研究议题极为多元:对齐技术方面,包括基于人类反馈的强化学习(RLHF)和直接偏好优化(DPO),旨在使模型行为符合人类意图与价值观;可靠性方面,涵盖幻觉抑制(减少模型生成虚假信息)与思维链推理(Chain-of-Thought);效率方面,包括量化、蒸馏、投机解码等推理加速技术;此外还有机制可解释性(Mechanistic Interpretability)、多模态融合与评测基准构建等方向。每一个子方向都足以支撑大量高质量论文。COLM 为这些研究者提供了「同频交流」的社区,这是它区别于其他综合性会议的核心竞争力。
学界与业界的深度交融
COLM 的组织者和贡献者中,既有活跃在学术前沿的研究人员,也有来自 OpenAI、Anthropic、Google DeepMind、Meta 等顶尖工业实验室的从业者。近年来,这些工业实验室已成为顶级 AI 论文的重要来源,在某些会议上其论文数量甚至超过传统学术机构——它们带来了大规模计算资源支撑的实证结果,深刻影响着整个学术生态的走向。这种学界与业界的深度交织,使 COLM 既保持了学术严谨性,又能紧贴产业最前沿的实际问题。当然,如何在开放性与学术公正性之间保持平衡,也是社区持续关注的议题。
录用季:社区情绪的集体释放
每逢顶会公布录用结果,社交平台上都会出现类似的「Decision Discussion」帖子。这些帖子是研究者群体情绪的集中释放窗口:有对审稿意见的复盘,有对 rebuttal(反驳)阶段博弈的讨论,也有对录用率和评分标准的种种猜测。
等待周期中的焦虑与期待
顶级 AI 学术会议普遍采用双盲同行评审制度(Double-blind Peer Review),典型流程包括:论文提交、分配审稿人、初审评分、作者 Rebuttal 阶段(作者唯一能主动干预评审结果的窗口,可针对审稿人的误解或质疑提供澄清与补充实验)、审稿人更新评分,再由 Area Chair 或 Meta-Reviewer 综合裁定,最终给出录用决定。这一流程往往历时数月,审稿人评分、meta-reviewer 综合意见都牵动着作者的神经。COLM 作为相对年轻的大语言模型会议,其审稿人池的质量与一致性尤为关键,审稿标准和录用尺度的稳定性也是社区反复讨论的焦点——对于刚举办两三届的会议而言,「口碑」与「含金量」仍处于持续建立的过程中。
讨论帖的实际信息价值
这类讨论帖看似只是集体等待时的情绪出口,实则承担了重要的信息聚合功能。研究者会在其中分享收到的评分分布、交流不同领域的录用倾向,帮助整个社区形成对会议评审质量的判断。对新投稿者而言,这些来自一线的信息往往比官方公告更具参考价值。
COLM 折射出的 AI 研究范式变迁
COLM 的兴起并非偶然,它是过去几年 AI 研究重心迁移的一个缩影。
从「通用 ML」到「语言模型专精」
深度学习早期,研究者更多关注通用的模型架构与优化方法。随着 Transformer 架构和大规模预训练成为主导范式,语言模型本身已成长为一个值得独立研究的复杂系统——其参数规模从早期的亿级跃升至千亿乃至万亿级别,所涉及的训练工程、推理优化、安全对齐等问题已远超传统 ML 研究的范畴。围绕它衍生出的对齐、评测、推理效率、幻觉抑制等研究方向,已构成一个自成体系的领域。COLM 正是这一趋势走向制度化的产物。
AI 学术发表生态的重新洗牌
新会议的涌现,正在悄然改变 AI 学术发表的整体生态。研究者需要在众多会议之间权衡投稿策略:是选择历史悠久、影响力广的传统顶会,还是定位更精准、社区氛围更聚焦的新兴垂直会议?工业界研究者的大量涌入,在带来前沿实证成果的同时,也引发了关于研究独立性与成果可复现性的广泛讨论。COLM 能否在未来数年稳固自身地位,关键在于能否持续吸引高质量论文、维持严谨的评审标准,并逐步建立起可预期的学术公信力。
结语
COLM 2026 的录用结果即将揭晓,这不仅关乎数千名投稿研究者的成果去向,也是观察大语言模型研究生态健康程度的重要窗口。一个年轻会议的成长,需要时间的积累与社区的共同维护。无论最终录用结果如何,围绕它展开的讨论本身,已经体现了这个领域旺盛的学术活力与开放的交流文化。对于持续关注 AI 前沿的研究者和从业者而言,跟踪 COLM 这样的语言模型垂直会议,或许能更早捕捉到这一领域研究的下一个风向标。
相关推荐

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。

Anthropic IPO前,早期投资人账面回报有多高?
Anthropic IPO前早期投资人账面回报引发关注。本文分析其纸面收益来源、资本结构、IPO预期下的博弈与风险,以及对AI创业生态的启示。