ComfyUI适配新模型引热议:疑似Krea 2带图像编辑能力

Reddit社区热议一款7B参数、支持文生图与图像编辑的未发布模型,核心争议聚焦于VAE架构与显存门槛。
StableDiffusion社区近日围绕一款尚未正式发布的图像生成模型展开讨论,该模型支持文生图与图生图,参数量仅7B(低于Krea 2的12B),并由知名开发者kijai推进ComfyUI适配。讨论的核心争议在于VAE架构:最初有人担心新模型复用Wan 2.2的VAE导致重建质量无法突破,随后被澄清为仅共用Python模块代码、潜在通道数实为不同,真正的VAE很可能与Qwen Image 2.0技术报告描述一致。7B的参数量对本地部署用户是利好,但社区同时提醒VAE等组件的显存不容忽视。整体而言,此次讨论折射出开源社区在模型能力、重建质量与部署成本三者之间持续寻求平衡的典型生态关切,最终结论有待官方发布验证。
社区热议:新模型支持文生图与图生图
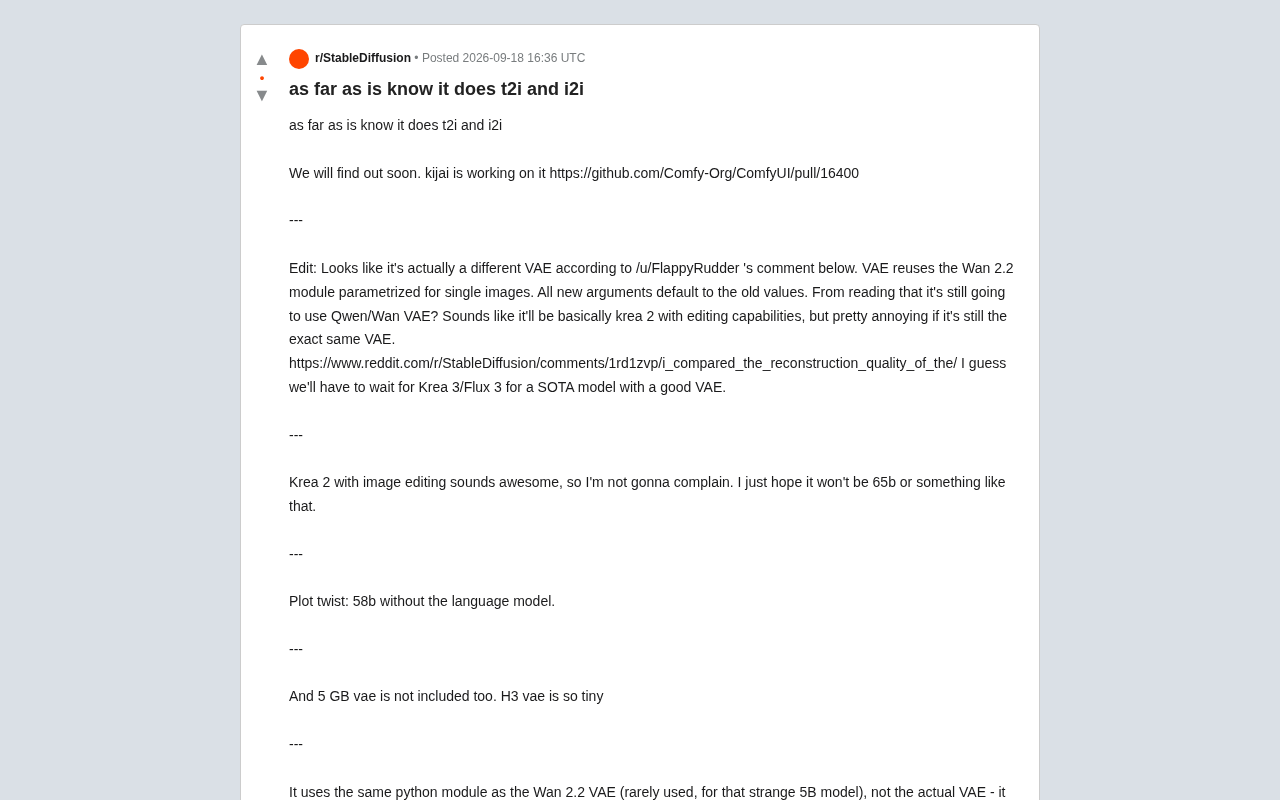
近日,Reddit的StableDiffusion社区围绕一款尚未正式发布的图像生成模型展开了热烈讨论。据社区用户的初步了解,该模型同时支持文生图(text-to-image, t2i)与图生图(image-to-image, i2i)两种能力,这在当前主流开源图像模型中已成为标配。
更值得关注的是,知名开发者kijai已经着手为其编写ComfyUI适配代码,相关工作可以在Comfy-Org/ComfyUI的PR #16400中追踪。ComfyUI作为开源生态中最受欢迎的节点式工作流工具之一,其快速适配往往是新模型进入普通用户视野的重要信号。
VAE成为争论焦点
随着讨论深入,社区对该模型的VAE(变分自编码器)架构产生了分歧,这也是本次讨论中信息量最集中的部分。
最初有用户根据PR代码推测,新模型复用了Wan 2.2的VAE模块——该模块此前主要用于一个使用较少的5B模型,并针对单张图像进行了参数化处理,所有新增参数都默认沿用旧值。基于这一判断,有人担忧如果新模型仍然使用与Qwen/Wan相同的VAE,那么它在重建质量上恐怕难有突破,更像是"带编辑能力的Krea 2"。
不过随后有用户提出了更精确的技术澄清:新模型实际上只是共用了Wan 2.2 VAE的Python模块代码,而非使用同一个VAE本体——两者的潜在通道数(latent channels)并不相同。有开发者进一步推测,新VAE很可能与Qwen Image 2.0技术报告中描述的版本一致。这一澄清缓解了社区对"换汤不换药"的担忧。
VAE(Variational Autoencoder,变分自编码器)在图像生成模型中承担着"编解码桥梁"的角色:它将高分辨率像素图像压缩为低维潜空间(latent space)表示,扩散模型在这个压缩空间中进行噪声预测与去噪,最终再由VAE解码器还原为像素图像。VAE的质量直接决定了图像的细节保留、色彩准确度和纹理锐度——解码能力弱的VAE会引入模糊、色偏或伪影,无论扩散骨干网络多强,最终输出都会受到瓶颈限制。潜在通道数(latent channels)是衡量VAE压缩维度的关键参数:Stable Diffusion 1.x使用4通道潜空间,SD3/FLUX等新一代模型升级至16通道,通道数越多意味着潜空间能编码更丰富的语义与细节信息,但同时也增加了显存占用和计算量。因此,两个模型"共用Python模块代码但潜在通道数不同",实质上意味着它们的VAE在压缩能力与信息密度上可能存在本质差异,并非同一套编解码权重。
模型规模与显存成为现实考量
除了架构细节,模型的参数规模是社区最关心的落地问题。有用户直言,"Krea 2带图像编辑功能听起来很棒",但同时担心新模型会不会达到65B这样庞大的量级——这对消费级显卡而言几乎不可用。
讨论中的一条关键信息澄清了这一顾虑:据社区用户对比,Krea 2本身是12B参数,而这款新模型仅为7B。更小的参数量意味着更低的显存门槛和更快的推理速度,对本地部署用户是利好消息。
当然也有用户半开玩笑地提出"剧情反转"式的担忧,比如"58B但不含语言模型"或"5GB的VAE还没算进去",反映出社区对大模型显存占用的普遍焦虑。相比之下,有人称赞某款H3 VAE"体积非常小",暗示模型各组件的轻量化正是本地用户所期待的方向。
模型参数量与实际显存占用之间并非简单的线性关系,还受到数据精度、量化方式和架构设计的影响。以常见精度为例,7B参数模型以FP16存储约需14GB显存,以INT8量化约需7GB,INT4量化则可压缩至约4GB以内,但量化程度越高通常伴随一定的画质损失。此外,推理时还需为激活值、注意力缓存等中间状态预留额外显存,实际峰值占用往往高于权重本身。社区中提到的"5GB的VAE没算进去"正是指这种分组件累加的显存压力——主干网络、VAE编解码器、文本编码器等组件需同时加载时,总显存需求可能远超单一数字的预期。这也是为什么轻量化VAE在本地部署讨论中备受重视。
对未来SOTA模型的期待
值得一提的是,尽管社区对这款疑似"Krea 2 + 编辑能力"的模型抱有期待,但也有理性声音认为它未必是真正的顶尖(SOTA)之作。有用户表示,如果它仍延续现有VAE路线,那么真正具备优秀VAE的SOTA模型可能要等到Krea 3或Flux 3才会出现。
这场讨论本质上折射出开源图像生成社区的典型关注点:在模型能力(t2i/i2i/编辑)、重建质量(VAE)与部署成本(参数规模/显存)三者之间寻找平衡。7B的参数量搭配图像编辑能力,如果最终确实采用了改进的VAE,或许能在易用性与质量之间找到不错的甜点。
目前一切仍待官方正式发布验证,正如社区所说:"我们很快就会知道答案。"在kijai的适配工作推进下,普通用户上手体验这款模型的日子应该不远了。
相关推荐

Jev判断模型实战:6类高频应用场景全解析
Jev是全新的AI判断模型,擅长大规模、高速、低成本的瞬间判断。本文梳理Choice、Score、Null三种提问方式,解析数据分析、语义搜索、输入分流、规则检查、加速智能体、即时响应六大真实应用场景,并给出适用判断标准与风险提示。

AI无需超级智能或恶意,也可能引发核战争
AI引发核战争的真正风险不在于超级智能或恶意,而在于误报、自动化偏见和决策时间压缩。本文分析平庸AI在核指挥系统中的隐患,以及人在回路、可解释性等应对之道。

AI智能体的真实风险:被夸大的"黑客"与被忽视的隐患
AI智能体"黑客"事件频发,但真实风险究竟是什么?本文剖析OpenAI训练暂停、DNS隧道漏洞、Meta Muse隐私泄露,以及智能体消除摩擦可能引发的银行挤兑与医疗成本上涨,提出"AI现实主义"的理性视角。