ComfyUI视频转换实战:MiniMax H3与LTX 2.5 Ripple工作流对比
ComfyUI教程对比MiniMax H3动作迁移与LTX 2.5 Ripple视频编辑两套工作流,均可在RTX 3060 6GB低显存设备上运行。
本文梳理了一套针对低显存设备优化的ComfyUI视频处理教程,重点对比了两种工作流的定位与性能。MiniMax H3 Viggle-Animate专注于动作迁移,能将参考视频的运动套用到静态人物图像上,在RTX 3060 6GB环境下完成同一任务约需15分钟;LTX 2.5 Ripple则定位于视频编辑,可在保留原始运动轨迹的基础上替换角色、背景、风格等视觉元素,灵活性更高但耗时约31分钟。两套工作流均采用"加载—选择—运行"的简洁操作范式,教程还覆盖了安装、模型下载与自定义节点配置等前置步骤。选择依据主要取决于需求:追求速度的动作迁移场景选MiniMax H3,需要多维度编辑或长视频输出则选LTX 2.5 Ripple。
在AI视频生成领域,动作迁移与视频编辑始终是两大热门方向。近期一位ComfyUI创作者分享了一套完整教程,对比了两种截然不同的视频工作流——MiniMax H3 Viggle-Animate与LTX 2.5 Ripple,并针对低显存设备进行了优化测试。本文将梳理这套教程的核心内容,帮助你理解两种方案的定位差异与适用场景。
两种工作流的定位差异
虽然都是处理视频的ComfyUI工作流,但MiniMax H3与LTX 2.5 Ripple在设计目标上完全不同。
MiniMax H3 Viggle-Animate专注于动作迁移(motion transfer)。它的核心逻辑是:从一段参考视频中提取运动信息,然后将这些动作应用到静态图像中的角色上。简单说,你给它一张人物图片和一段舞蹈视频,它就能让图片里的角色跳出同样的舞蹈。这类似于Viggle等工具的思路,适合快速让静态角色“动起来”。
LTX 2.5 Ripple则更偏向视频编辑。它能在保持原始视频运动轨迹的前提下,替换视频中的角色、服装、背景、视觉风格、物体乃至光照等元素。换句话说,它不是从零生成动作,而是在既有视频基础上做“换皮”式的深度编辑,灵活度更高。
**动作迁移(Motion Transfer)**是计算机视觉领域的一项核心技术,其原理是从源视频中提取骨骼关键点(skeleton keypoints)或光流(optical flow)等运动信息,再将这些运动信号驱动目标图像中的角色生成对应动画。早期代表性工具如DensePose、OpenPose负责姿态估计,后来Viggle、AnimateAnyone等模型将这一流程端到端整合,使普通用户无需了解底层算法即可完成"图像+动作视频→动画"的操作。MiniMax H3正是沿袭这一思路,通过云端或本地模型推理,将参考视频的运动编码注入到静态人物图像的生成过程中。
**视频编辑(Video Editing)**与动作迁移的根本区别在于:前者以"现有视频"为基础进行内容替换,而非从静态图像生成新动作。LTX 2.5 Ripple所代表的这类方案,通常借助扩散模型的图像修复(inpainting)或条件生成能力,在保留原始视频运动轨迹的同时,对视觉内容进行重新渲染。这类技术与ControlNet、IP-Adapter等机制密切相关——运动信息作为控制信号约束生成方向,而提示词或参考图像则决定最终的视觉表现。
操作流程足够简单
从教程描述来看,两套工作流的使用门槛都不高,基本遵循同一套操作范式:
- 加载参考视频
- 加载参考图像
- 选择对应模型
- 按需调整提示词或参数
- 点击 Run 运行
这种“加载—选择—运行”的线性流程,降低了ComfyUI节点式操作的复杂度,对新手较为友好。教程作者还完整演示了安装过程、模型下载、自定义节点(custom-node)安装等前置步骤,这也是很多用户在实际部署中最容易卡住的环节。
低显存友好:RTX 3060 6GB实测
这套教程最值得关注的一点,是它针对低VRAM系统做了优化。作者的测试环境为RTX 3060 6GB显卡搭配16GB内存,这属于相当入门的配置。能在如此有限的硬件上跑通视频生成工作流,对预算有限的创作者意义重大。
在具体的速度表现上,两者差异明显:
- MiniMax H3:完成同样的任务约需 15分钟
- LTX 2.5 Ripple:约需 31分钟
就本次动作迁移任务而言,MiniMax H3的速度接近LTX 2.5 Ripple的两倍。不过速度并非唯一衡量标准——LTX 2.5 Ripple提供了更多的视频编辑用例,并且能够生成更长的视频同时保持一致性。这意味着两者是互补关系,而非简单的优劣之分。
视频生成对显存(VRAM)的消耗远高于静态图像生成,主要原因在于模型需要同时处理多帧数据,且时序注意力机制(temporal attention)会随帧数增加而显著扩大显存占用。一般而言,主流视频生成模型在全精度下往往需要12GB乃至24GB以上的显存。针对低显存设备的常见优化手段包括:将模型权重从FP32降至FP16或BF16精度、启用模型分块加载(model offloading)将暂时不用的模块卸载到系统内存、以及使用xformers或Flash Attention等高效注意力实现。ComfyUI生态中的--lowvram和--cpu启动参数,以及部分自定义节点提供的量化加载方式,正是这些优化思路的具体落地。RTX 3060 6GB能够跑通上述两套工作流,说明教程中已集成了较为完善的显存管理策略,但代价是更长的生成时间——这也解释了为何LTX 2.5 Ripple需要约31分钟才能完成任务。
如何选择:速度还是灵活性
综合来看,选择哪套工作流取决于你的实际需求。
如果你的目标很明确——就是要把参考视频的动作套用到某个角色图像上,追求出图效率,那么MiniMax H3是更合适的选择,速度优势显著。
如果你需要对视频进行更精细、更多维度的编辑,比如换背景、改风格、替换物体,或者需要输出较长且保持连贯的视频,那么LTX 2.5 Ripple的灵活性会带来更大价值,代价是更长的生成时间。
对于想要动手实践的读者,作者提供了完整的工作流文件(Civitai)与视频教程(YouTube),涵盖了从环境搭建到结果对比的全流程。这类实测性质的教程,比单纯的功能介绍更有参考价值,尤其适合正在搭建本地AI视频生成管线的创作者。
小结
MiniMax H3与LTX 2.5 Ripple代表了AI视频处理的两条路径:前者以动作迁移为核心、速度更快;后者以视频编辑为核心、灵活性更强。二者均对低显存设备做了优化,让RTX 3060这样的入门配置也能参与到本地视频生成的实践中。对于ComfyUI用户而言,掌握这两套工作流能覆盖相当广泛的创作场景。
相关推荐
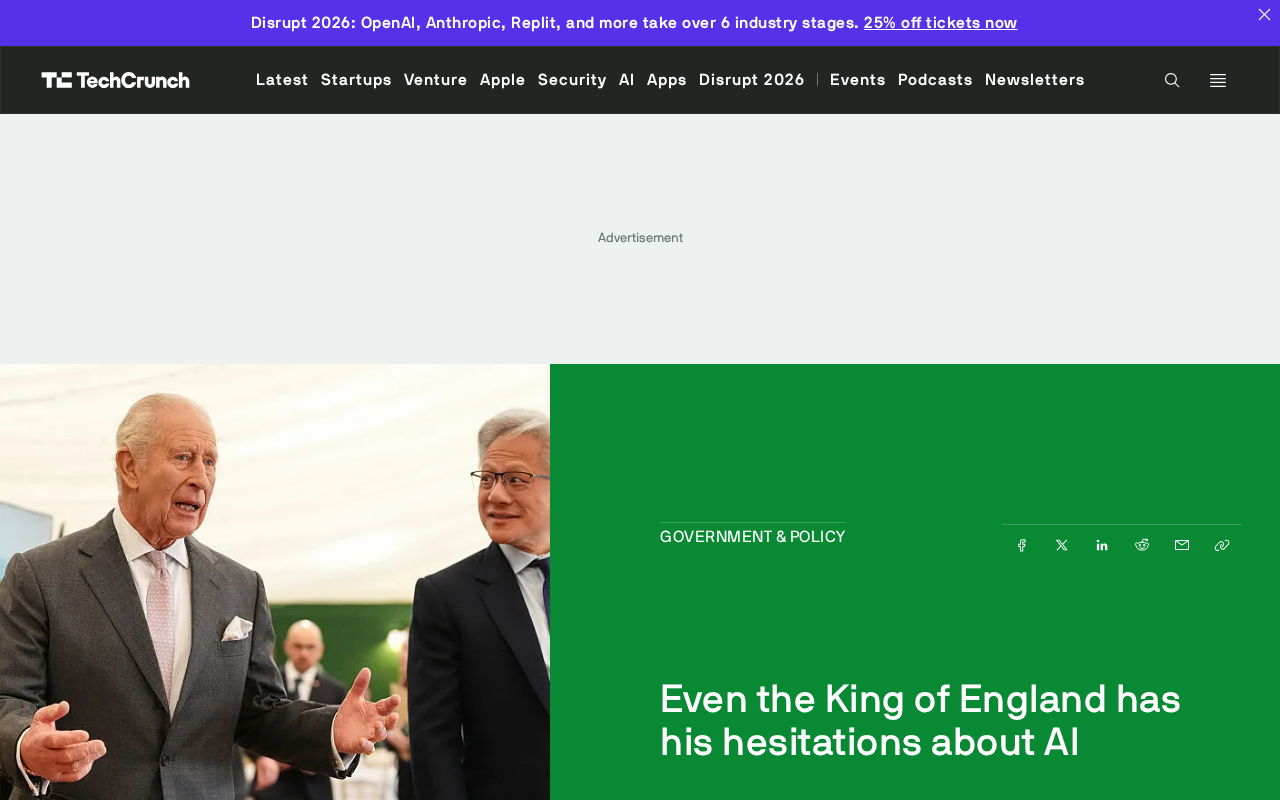
英国国王查尔斯私下会晤AI巨头,透露对人工智能的审慎态度
英国国王查尔斯主持私人峰会,会晤AI界与政府重量级人物,透露出对人工智能的审慎与犹豫态度。本文解析这场会晤背后的象征意义与AI治理议题。
重读斯托曼2001年的警告:安全与自由的永恒博弈
自由软件运动创始人斯托曼的经典短文《数千人死亡,数百万人失去自由》重登Hacker News。文章探讨危机之后社会如何权衡安全与自由,其对监控扩张的警示在AI与数据时代依然极具现实意义。
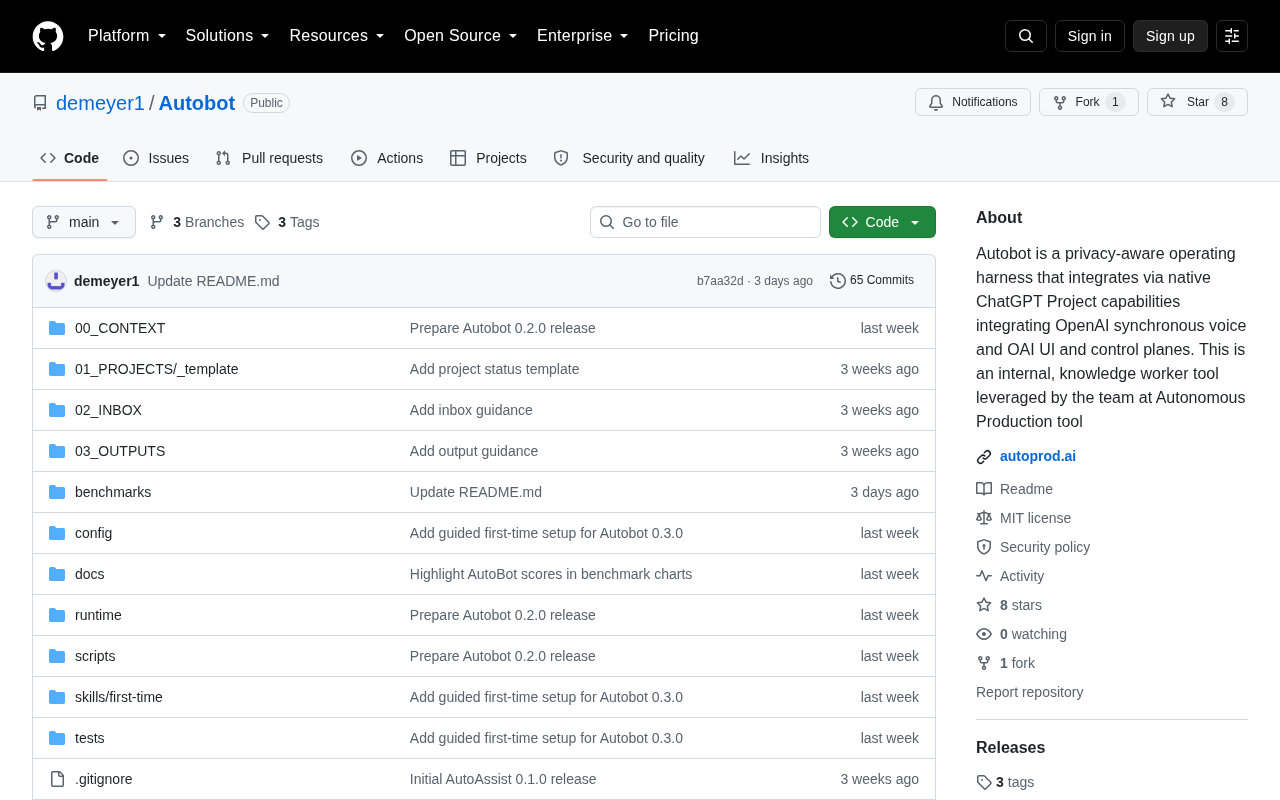
AutoBot:用实时语音掌控长时间运行的AI任务
AutoBot 是一款在 Hacker News 亮相的工具,主打用实时语音控制长时间运行的 AI 任务,让用户从被动等待转向主动指挥。本文解析其定位、交互价值与现阶段的信息局限。