从0到1搭建智能客服Agent:意图识别92%的实战拆解
B站UP主分享的智能客服Agent方案,靠四个工程模块将意图识别准确率从65%提升到92%。
文章拆解了一套已在多家企业落地的智能客服Agent方案,每天处理超10万次对话,意图识别准确率92%、对话完成率78%、满意度从3.2拉到4.6分,节省六成以上人力成本。方案由四个关键模块支撑:用BERT做分层意图识别替代关键词规则;用对话状态跟踪器保留最近十轮上下文解决多轮失忆;知识库采用向量检索加精确匹配的混合方案并对超30天旧知识做权重衰减;转人工由置信度、情绪、重复失败三项加权打分触发。文章强调生产落地还依赖微服务、容器化、监控告警和AB测试等工程配套,四个模块可分阶段落地。
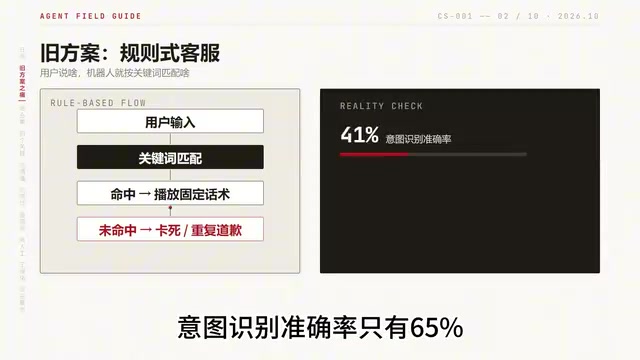
很多企业做客服自动化,第一反应是写规则:用户说什么就匹配什么关键词。结果往往是一个月后,意图识别准确率停在65%左右,10次对话里有6次聊不下去,任务完成率只有40%。
B站一位UP主分享了一套已经在多家企业落地的智能客服Agent方案,每天处理超过10万次对话,意图识别准确率做到92%,对话完成率78%,用户满意度从3.2分拉到4.6分,帮企业省下六成以上人力成本。这套系统不是靠堆概念,而是靠四个工程化的关键模块撑起来的。下面按这套实战路径拆解一遍。
听得懂:用BERT做分层意图识别
规则匹配的天花板很低,因为真实用户的表达太发散。这套系统的做法是用BERT模型做意图识别,把用户问题先分成咨询、投诉、交易三大类,再一层层往下拆到具体业务场景。
先判断“你想干嘛”,再匹配“具体是哪件事”,这种分层拆解的好处是每一层的分类边界更清晰,模型训练也更容易收敛。从65%到92%的准确率提升,核心就来自这里——用深度学习替换关键词匹配,让机器人理解语义而不是背词表。
BERT(Bidirectional Encoder Representations from Transformers) 是Google于2018年提出的预训练语言模型,其核心创新在于双向Transformer编码器——在理解一个词时,同时利用它左右两侧的上下文信息。传统词向量(如Word2Vec)为每个词分配固定表示,无法处理一词多义;BERT则根据句子语境动态生成词的表示,因此能更好捕捉“我想查一下订单”和“我要投诉订单问题”这类语义差异。在意图识别任务中,通常的做法是在BERT输出层之上接一个分类器,用标注好的客服对话数据做微调(fine-tuning),使模型适配具体业务场景。相比关键词匹配,BERT能泛化到未见过的表达方式,这正是准确率从65%跃升到92%的技术基础。
记得住:对话状态跟踪器管上下文
多轮对话最怕“失忆”。用户前面报了订单号,后面说“那个产品”,系统如果接不上,对话就断了。这套系统里有一个对话状态跟踪器,专门记录用户说过的订单号、手机号,以及指代对象,始终保留最近十轮上下文。
这个模块看起来不起眼,但它是多轮对话能连续推进的前提。没有状态跟踪,再强的意图识别也只能处理单轮问答。
查得准:向量检索加精确匹配的混合方案
知识库检索是客服系统准确率的第二道关口。这套系统用的是向量检索加精确匹配的混合方案:一句话进来先算语义相似度,再按紧急程度和知识新鲜度做二次排序。
一个容易被忽略的细节是权重衰减——超过30天的旧知识权重自动下调,避免系统拿过期政策回复用户。很多客服机器人答非所问,不是模型不行,而是知识库在“用旧答案回答新问题”。
向量检索是指将文本通过嵌入模型(embedding model)编码为高维稠密向量,再通过计算向量间的余弦相似度或内积来衡量语义相近程度。与关键词检索依赖字面匹配不同,向量检索能召回“怎么退钱”与“退款流程是什么”这类表述不同但语义相同的内容。常用的向量索引结构包括FAISS、HNSW等近似最近邻(ANN)算法,可在毫秒级完成大规模知识库的语义搜索。混合方案中,精确匹配负责处理订单号、产品型号等结构化查询,向量检索负责处理自然语言问句,两者互补可显著降低漏召回和误召回。二次排序则通常引入业务规则(如紧急程度)和时效性因子,对候选结果重新打分。
知道认怂:转人工的加权打分机制
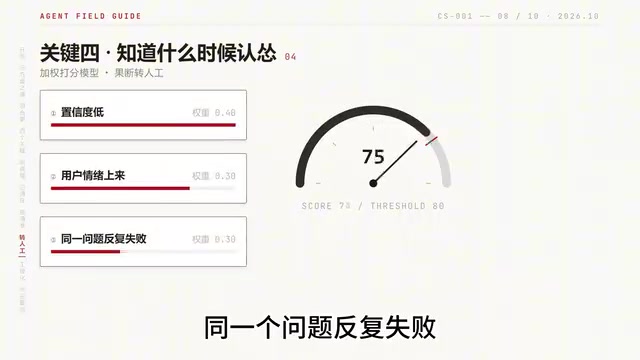
第四点最容易被忽略:系统要知道什么时候转人工。这套方案的触发条件是置信度低、用户情绪上升、同一问题反复失败,三者通过一套加权打分模型综合判断,达到阈值就果断转人工。
UP主的原话是“AI不是要取代人,而是把人留给最需要人的时刻”。这个设计思路值得所有做客服Agent的团队参考——转人工不是失败,而是系统设计的一部分。
置信度(confidence score) 在分类模型中通常指模型对预测类别的概率输出或归一化后的分数。当BERT意图分类器对当前用户语句的最高类别概率低于某个阈值时,意味着模型“不确定”用户意图,此时继续自动回复的风险较高。工程上,置信度阈值需要根据业务容忍度做校准:阈值过高会导致频繁转人工、增加人力成本;过低则会让机器人强行作答、损害用户体验。实践中常用AB测试和线上反馈数据来动态调整阈值。将置信度与情绪识别、重复失败次数联合建模,本质上是一种多信号融合的兜底策略,确保系统在不确定时做出保守决策。
上线只是开始:工程化才是分水岭
方案能跑在生产环境,靠的不只是模型。原文提到微服务架构、容器化部署、实时监控告警,以及AB测试持续迭代。这套工程配套决定了系统是“演示能跑”还是“每天扛10万次对话”。
对于正在被客服成本困扰的团队,这套拆解的参考价值在于:四个模块各自有明确的工程目标,可以分阶段落地,而不是一次性重造整个系统。UP主也提到下一步方向是多模态情感计算和大语言模型深度融合。
常见问题
Q:这套方案适合什么规模的企业? 原文未给出明确规模门槛,但从每天10万次对话、节省六成人力成本的数据看,适合客服量已经形成成本压力的团队。
Q:规则系统能不能直接升级? 可以保留规则作为兜底,核心路径替换为BERT意图识别加混合检索,转人工打分机制可以独立先上。
Q:知识库权重衰减怎么定? 原文给的是30天衰减起点,具体阈值需要按业务政策更新频率调整。
相关推荐

前端转AI Agent开发:一线架构师解析职业路径与红利
一线AI架构师解析前端转AI Agent开发的行业变化与落地路径:纯前端岗位为何消失、Agent+全栈为何成为招聘主流,以及Agent开发工程师、FDE、远程接单三条转型路线和对应学习策略。

AI Agent开发课程怎么选?五条避坑指南
机械转行开发者踩坑两年总结的AI Agent开发课程筛选清单:完整交付链路、可写进简历的项目、真实开发视角、更新频率、陪跑反馈五个维度,附具体判断方法和避坑要点。

扣子(Coze)智能体搭建入门:零代码开发AI Agent实战指南
扣子(Coze)是字节跳动推出的一站式AI应用开发平台,支持零代码拖拽搭建AI智能体。本文基于B站教程梳理扣子的核心概念、三大优势、国内版与国际版差异,以及智能体与应用的区别,帮助初学者快速入门AI Agent开发。