从Bandit反馈学习校准决策头:CAPS方法胜出

研究揭示朴素概率奖励失效,提出CAPS从bandit反馈中有效学习校准决策头。
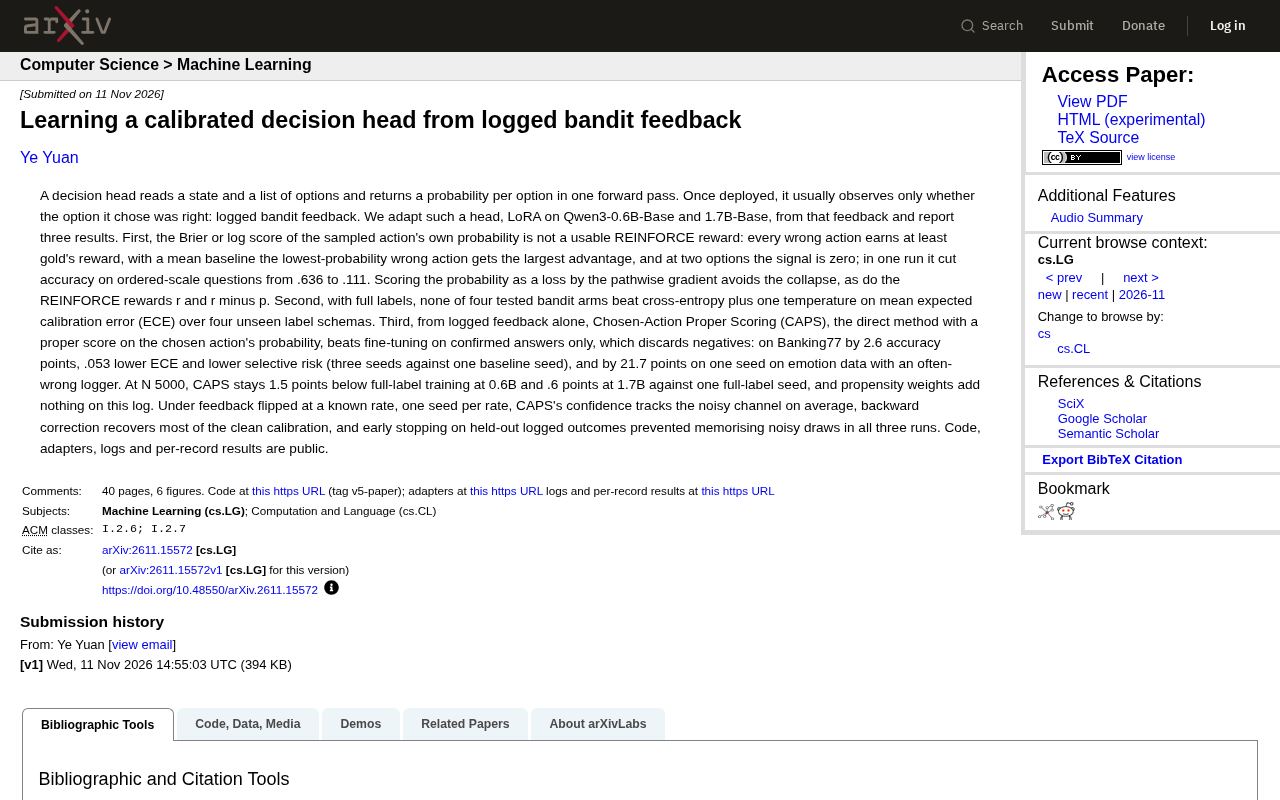
本文探讨如何仅利用记录的bandit反馈(所选动作是否正确)来微调决策头,并在Qwen3-0.6B-Base和1.7B-Base上通过LoRA进行实验。研究发现,将采样动作概率的Brier或对数分数作为REINFORCE奖励会导致训练崩溃,准确率从0.636暴跌至0.111;而在全标签条件下,四种bandit方法均未超越交叉熵加温度的基线在期望校准误差(ECE)上的表现。为此,作者提出Chosen-Action Proper Scoring(CAPS),对所选动作的概率应用适当评分规则。仅从记录反馈学习时,CAPS在Banking77上比仅用确认答案微调准确率高2.6个百分点、ECE低0.053;在情感数据上,当日志记录器常出错时,CAPS准确率高出21.7个百分点。与全标签训练相比,CAPS在N=5000时差距较小(0.6B模型低1.5个百分点,1.7B模型低0.6个百分点)。在噪声反馈下,反向校正可恢复大部分干净校准,早停能防止记忆噪声。研究强调奖励设计需谨慎,CAPS为bandit反馈学习校准提供了有效方案,但仍依赖日志质量。
决策头(decision head)是一个接收状态和选项列表、通过一次前向传播为每个选项输出概率的模型组件。一旦部署,它通常只能观察到所选选项是否正确,即记录的bandit反馈(logged bandit feedback)。一项新研究基于这种反馈,在Qwen3-0.6B-Base和1.7B-Base上通过LoRA微调决策头,并报告了三项关键发现。
朴素REINFORCE奖励的失效
研究团队首先检验了将采样动作自身概率的Brier分数或对数分数作为REINFORCE奖励的做法,发现这种信号不可用。具体而言,每个错误动作获得的奖励至少与正确动作(gold)的奖励相当;在使用均值基线时,概率最低的错误动作反而获得最大的优势值;当只有两个选项时,信号恒为零。在一组有序量表问题上,这种奖励设计导致准确率从0.636骤降至0.111,出现严重的性能崩溃。
相比之下,将概率作为损失并通过路径导数(pathwise gradient)进行优化可以避免这种崩溃,使用REINFORCE奖励r或r减去p(r minus p)也能达到类似效果。这表明奖励设计需要谨慎处理概率信号,而非简单地将概率分数直接作为奖励。
REINFORCE 与路径导数:REINFORCE 是策略梯度的一类经典估计方法,它利用对数概率的梯度乘以奖励来更新参数,本质上是对采样动作的得分函数求导,因此梯度方差较大且依赖奖励的尺度。路径导数(pathwise gradient,又称重参数化梯度)则通过将随机采样表示为确定性函数与独立噪声的组合,直接对概率输出求导,通常方差更低。在决策头场景中,若将概率分数直接作为奖励,REINFORCE 的得分函数项会与奖励中的概率项耦合,导致梯度方向异常;而路径导数直接优化概率本身(如 Brier 分数),能避免这种耦合,从而更稳定。
全标签条件下Bandit方法未超越交叉熵
在拥有完整标签的场景中,研究比较了四种bandit方法与交叉熵加一个温度参数(cross-entropy plus one temperature)在四个未见标签模式上的平均期望校准误差(ECE)。结果显示,没有一种bandit方法能够超越这一简单基线。这意味着在标签充足时,传统的监督学习方式在校准性能上仍然具有优势,bandit方法并未带来额外收益。
期望校准误差(ECE):ECE 是衡量模型置信度与真实准确率一致性的常用指标,它将预测置信度划分为若干区间,计算每个区间内平均置信度与平均准确率的绝对差,再按样本比例加权平均。ECE 越低,说明模型输出的概率越可靠。交叉熵加温度参数是一种简单的事后校准方法:在验证集上调整一个温度标量来缩放 logits,使交叉熵最小化,从而改善校准。bandit 方法通常直接优化决策损失,可能牺牲校准性能,因此在这一指标上未必优于经过温度缩放的交叉熵基线。
CAPS:仅从记录反馈中学习校准
研究的核心贡献是提出了Chosen-Action Proper Scoring(CAPS),即对所选动作的概率应用适当评分(proper score)的直接方法。仅从记录的反馈中学习时,CAPS beats 仅对确认答案进行微调(fine-tuning on confirmed answers only)——后者会丢弃负面样本。具体结果包括:
- 在Banking77数据集上,CAPS在准确率上高出2.6个百分点,ECE低0.053,选择性风险更低(基于三个随机种子对比一个基线种子)。
- 在情感数据上,当日志记录器经常出错时,CAPS在一个种子上准确率高出21.7个百分点。
- 在N=5000时,CAPS与全标签训练相比,在0.6B模型上准确率低1.5个百分点,在1.7B模型上低0.6个百分点(对比一个全标签种子),而倾向权重(propensity weights)在此日志上并未带来增益。
此外,在已知翻转率的反馈噪声下(每个翻转率一个种子),CAPS的置信度平均上能跟踪噪声通道,反向校正可以恢复大部分干净校准,而基于保留日志结果的早停(early stopping)在所有三次运行中防止了记忆噪声抽样。
适当评分规则(Proper Scoring Rule):适当评分规则是一类损失函数,当预测分布与真实分布一致时取得最小值,从而鼓励模型输出真实概率。常见的例子包括 Brier 分数(均方误差)和对数分数(交叉熵)。CAPS 的核心思想是:仅对所选动作的概率应用适当评分规则,利用记录反馈中“所选动作是否正确”的信息来构造损失,而无需知道未选动作的标签。由于适当评分规则的性质,最小化该损失会驱动模型输出校准的概率,即使训练信号仅来自所选动作。
倾向权重(Propensity Weights):在 bandit 反馈中,每个动作被选择的概率称为倾向得分(propensity score)。倾向权重通常指用逆倾向得分对样本加权,以纠正日志记录策略带来的选择偏差,从而无偏地估计目标策略的价值。然而,当倾向得分估计不准确或日志策略与目标策略差异过大时,倾向权重会引入高方差甚至偏差。本研究中倾向权重未带来增益,可能源于日志质量或权重估计的局限性。
实践启示与局限
这项研究揭示了从bandit反馈学习校准决策头的几个关键点:朴素的概率奖励会导致训练崩溃,而CAPS提供了一种有效的替代方案。然而,CAPS仍与全标签训练存在一定差距,且倾向权重在特定日志上无效,说明方法的效果依赖于日志质量。在噪声反馈下,反向校正和早停是必要的稳定手段。代码、适配器、日志和逐记录结果均已公开,便于复现和进一步研究。
相关推荐
GPT-6.2 Astra与Sol发布:双模型架构与社区热议
OpenAI 发布 GPT-6.2,包含 Astra 与 Sol 两个模型。本文梳理官方公告与 Hacker News 社区讨论,分析双模型架构对开发者的潜在影响与选型建议。

Gmod TTT 埃及主题地图:太空资本主义与法老对决
探索Gmod TTT埃及主题地图的趣味玩法:玩家选择法老等角色,通过立方体传送到太空,展开资本主义与共产主义的幽默对决,并体验道具战斗的混乱乐趣。

GraphRAG:超越搜索,实现全局知识发现
GraphRAG 是微软研究院推出的知识图谱增强检索技术,超越传统 RAG 的局部搜索,实现全局性知识发现。本文介绍其核心理念、代际演进及医疗领域应用案例。