从部分语音学习何时提交:端到端同声语音翻译新突破

前缀监督让语音语言模型无需标注即可学会同声翻译的最优提交时机,多轮解码使校准误差下降最高80%。
本文针对同声语音翻译(SimulST)中"何时提交译文"这一核心难题,提出基于前缀监督的自监督微调方法。研究无需人工转录或翻译标注,直接利用模型对完整波形与部分波形的翻译结果构造训练信号。实验对比了单轮强制前缀与多轮仅追加两种解码策略,后者在低延迟场景下整体更优,提交校准误差整体下降63%–68%,在最难处理的早期前缀阶段更下降68%–80%。置信度阈值被证明是推理期最通用的质量—延迟调节手段,而训练前缀的合成密度则呈现非单调权衡,需精细调校。方法在FLEURS和CoVoST2的三个语言方向上均验证有效,为低资源语言的同传落地提供了可行思路。
同声语音翻译的核心难题:什么时候该说出口?
同声传译的本质矛盾在于——你必须在说话人话还没说完时,就输出有用的目标语言文本,同时又不能收回已经说出去的内容。这正是**同声语音翻译(Simultaneous Speech Translation, SimulST)**面临的根本挑战:既要抢时间降低延迟,又要保证已提交(committed)的每一个词都是准确的。
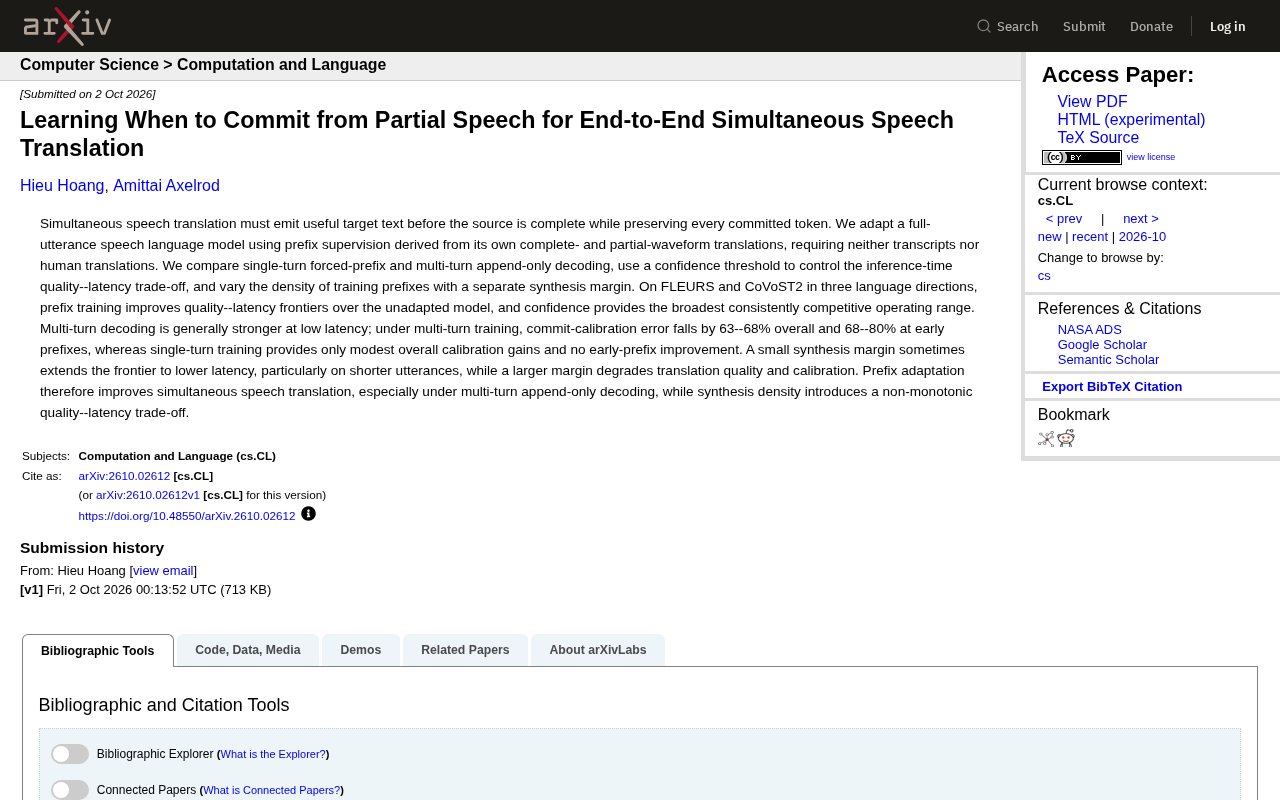
一篇发表于 arXiv 的新研究(arXiv:2610.02612v1)正面回应了这个问题。研究者提出了一种基于前缀监督(prefix supervision)的方法,让一个原本只能处理完整语句的语音语言模型,学会从不完整的语音波形中判断「什么时候该提交输出」。更关键的是,整套方法既不需要文字转录,也不需要人工翻译,训练信号完全来自模型自身对完整波形和部分波形的翻译结果。
**同声语音翻译(SimulST)**是语音翻译的一个子领域,区别于离线语音翻译(Offline ST)——后者等待整句说完后再翻译,而前者必须在说话人持续输入的过程中实时输出译文。衡量SimulST系统性能通常用两个维度:翻译质量(常用BLEU分数)和延迟(常用平均滞后AL、差分AL等指标)。两者天然对立,构成一条质量—延迟前沿曲线(quality-latency frontier)。传统SimulST系统依赖显式的"读/写"策略(read/write policy)来决定何时提交输出,例如经典的CIF、MMA等机制。本文的工作则另辟蹊径,将"提交时机"的学习嵌入语音语言模型(Speech-LLM)的微调过程中,通过前缀监督让模型内化这一决策,而非依赖外部规则。
方法核心:用模型自己的输出当老师
这项工作的巧妙之处在于数据来源。传统的翻译模型训练依赖大量平行语料和人工标注,而本研究采用自监督式的前缀监督:先让完整语句的语音语言模型分别翻译「完整波形」和「部分波形」,再用这些自生成的翻译作为训练目标来微调模型。
这意味着模型在学习一件事——面对一段还没说完的语音,它应该提交哪些词、保留哪些判断。这种做法大幅降低了数据获取成本,也让方法更容易迁移到缺乏标注资源的语言方向上。
两种解码策略的对决
研究对比了两种关键的解码方式:
- 单轮强制前缀(single-turn forced-prefix):在一次解码中强制给定前缀。
- 多轮仅追加(multi-turn append-only):分多轮逐步追加输出,已提交的内容不再更改。
实验结果显示,多轮仅追加解码在低延迟场景下整体表现更强。这符合直觉——分步追加的方式更贴近真实同传的工作节奏,模型可以在信息逐渐积累的过程中稳健地扩展输出。
**前缀监督(prefix supervision)**的核心思想来自序列到序列模型中对"前缀"的处理方式。给定一段完整语音对应的完整译文 $Y$,其长度为 $n$ 个词,则该译文的所有前缀($Y_{1:1}, Y_{1:2}, \ldots, Y_{1:n}$)均可视为不同信息量的训练目标。当模型只看到部分语音(即语音前缀)时,理想输出应是完整译文中与当前信息量"对齐"的那一段前缀。自监督的技巧在于:用同一个模型分别对完整波形和部分波形进行推断,以完整波形的译文作为参考,从而自动构造出「部分输入→部分输出」的训练对,无需人工标注哪些词在哪个时间点应当被提交。这一思路与知识蒸馏(knowledge distillation)有相似之处——用一个"教师"模型(完整波形翻译)指导"学生"模型(部分波形翻译)。
置信度阈值:控制质量与延迟的平衡杆
同声翻译永远绕不开质量—延迟权衡(quality-latency trade-off)。等得越久、信息越完整,译文质量越高,但延迟也越大;反之则可能因信息不足而出错。
研究引入了**置信度阈值(confidence threshold)**来在推理阶段动态调节这一权衡。实验表明,置信度机制提供了「最广泛且持续具有竞争力的操作区间」——换句话说,无论你偏向低延迟还是高质量,基于置信度的控制都能给出相对稳定的表现。这使它成为实际部署中最实用的调节手段。
关键数据:提交校准误差大幅下降
这项研究最具说服力的数字来自**提交校准误差(commit-calibration error)**的改善。
在多轮训练模式下:
- 整体提交校准误差下降 63%–68%;
- 在早期前缀(即语音刚开始、信息最少的阶段)下降 68%–80%。
相比之下,单轮训练只带来了「适度」的整体校准提升,且在早期前缀阶段毫无改善。这个对比非常重要:同传中最难、最容易出错的恰恰是开头阶段,而多轮训练正好在这个最关键的节点上实现了最大幅度的提升。
研究在 FLEURS 和 CoVoST2 两个数据集、三个语言方向上验证了这些结论,说明方法具备一定的跨语言泛化能力。
**提交校准误差(commit-calibration error)**是本文引入的评估指标,用于衡量模型"过早提交"或"过晚提交"译文词汇的程度。具体而言,若模型在只接收到少量语音时就输出了大量译文(过度激进),后续可能因信息不足而产生错误且无法撤回;若模型始终等待更多语音才输出(过于保守),则延迟过高。校准误差越小,意味着模型提交时机与实际可用信息量的匹配越精准。FLEURS 是 Google 发布的多语言语音数据集,覆盖102种语言,常用于评估语音识别与翻译的跨语言泛化能力;CoVoST2 是基于 Mozilla Common Voice 构建的大规模语音翻译数据集,包含多个语言对的翻译方向,两者结合使用能较全面地反映方法的鲁棒性。
合成密度:一把双刃剑
研究还探讨了训练前缀密度(density of training prefixes)的影响,引入了一个独立的**合成边际(synthesis margin)**参数。
结论呈现出明显的非单调性:
- 较小的合成边际有时能把质量—延迟前沿推向更低延迟,尤其在较短语句上效果明显;
- 较大的合成边际则会同时损害翻译质量和校准表现。
这提醒实践者,合成数据并非越多越好,密度需要精细调节,否则会适得其反。
**合成边际(synthesis margin)**控制的是在生成训练前缀时,截断点与实际词边界之间保留的"缓冲区"大小。直觉上,较大的合成边际意味着模型在提交每个词时,都要求更多的后续语音作为佐证,从而生成更保守、更高置信度的训练样本;而较小的合成边际则鼓励模型更激进地在早期提交词汇。非单调性的出现源于两种相反的压力:过小的边际会引入噪声标签(模型被迫在信息不足时提交,训练信号本身就有误),过大的边际则会导致训练分布偏向高延迟场景,压缩了低延迟区间的优化空间。这一发现对实践者的启示是:合成数据的质量比数量更重要,边际超参数需要针对目标延迟区间单独调校。
结论与意义
这项研究给同声语音翻译领域带来了几点扎实的贡献:前缀适配(prefix adaptation)确实能改善质量—延迟前沿,尤其配合多轮仅追加解码时效果最佳;置信度阈值提供了最通用的推理期调节能力;而合成密度则引入了需要谨慎处理的非单调权衡。
对于希望构建低延迟、高可靠同传系统的开发者来说,「多轮训练 + 置信度控制 + 适度合成边际」构成了一套值得借鉴的组合方案。不依赖转录与人工翻译的自监督思路,也为低资源语言的同传落地打开了新的可能性。
相关推荐

NFL为何重金押注旗帜橄榄球?安全与商业的双重博弈
NFL为何重金投资没有擒抱对抗的旗帜橄榄球?本文解析CTE脑病争议、女子体育数十亿美元市场与奥运机遇如何共同驱动联盟布局橄榄球的未来。

Asana浏览器智能体成本降76倍:GPT-6模型优化实测
Asana借助OpenAI的GPT-6 Astra模型与Codex工具,在浏览器智能体测试中将模型成本降低76倍、速度提升5倍。本文解读这一工程优化案例对企业AI落地的成本与性能启示。

@ai-sdk/vue 3.0.303 发布:依赖更新的补丁版本
@ai-sdk/vue 3.0.303 补丁版本发布,核心为依赖项同步升级,核心包 ai 升级至 6.0.303。本文解析该 Vue AI SDK 更新内容及对开发者的意义。